
只加四个 token 就把滑动窗口救回来:架构对比先问改了什么|洹拓科技
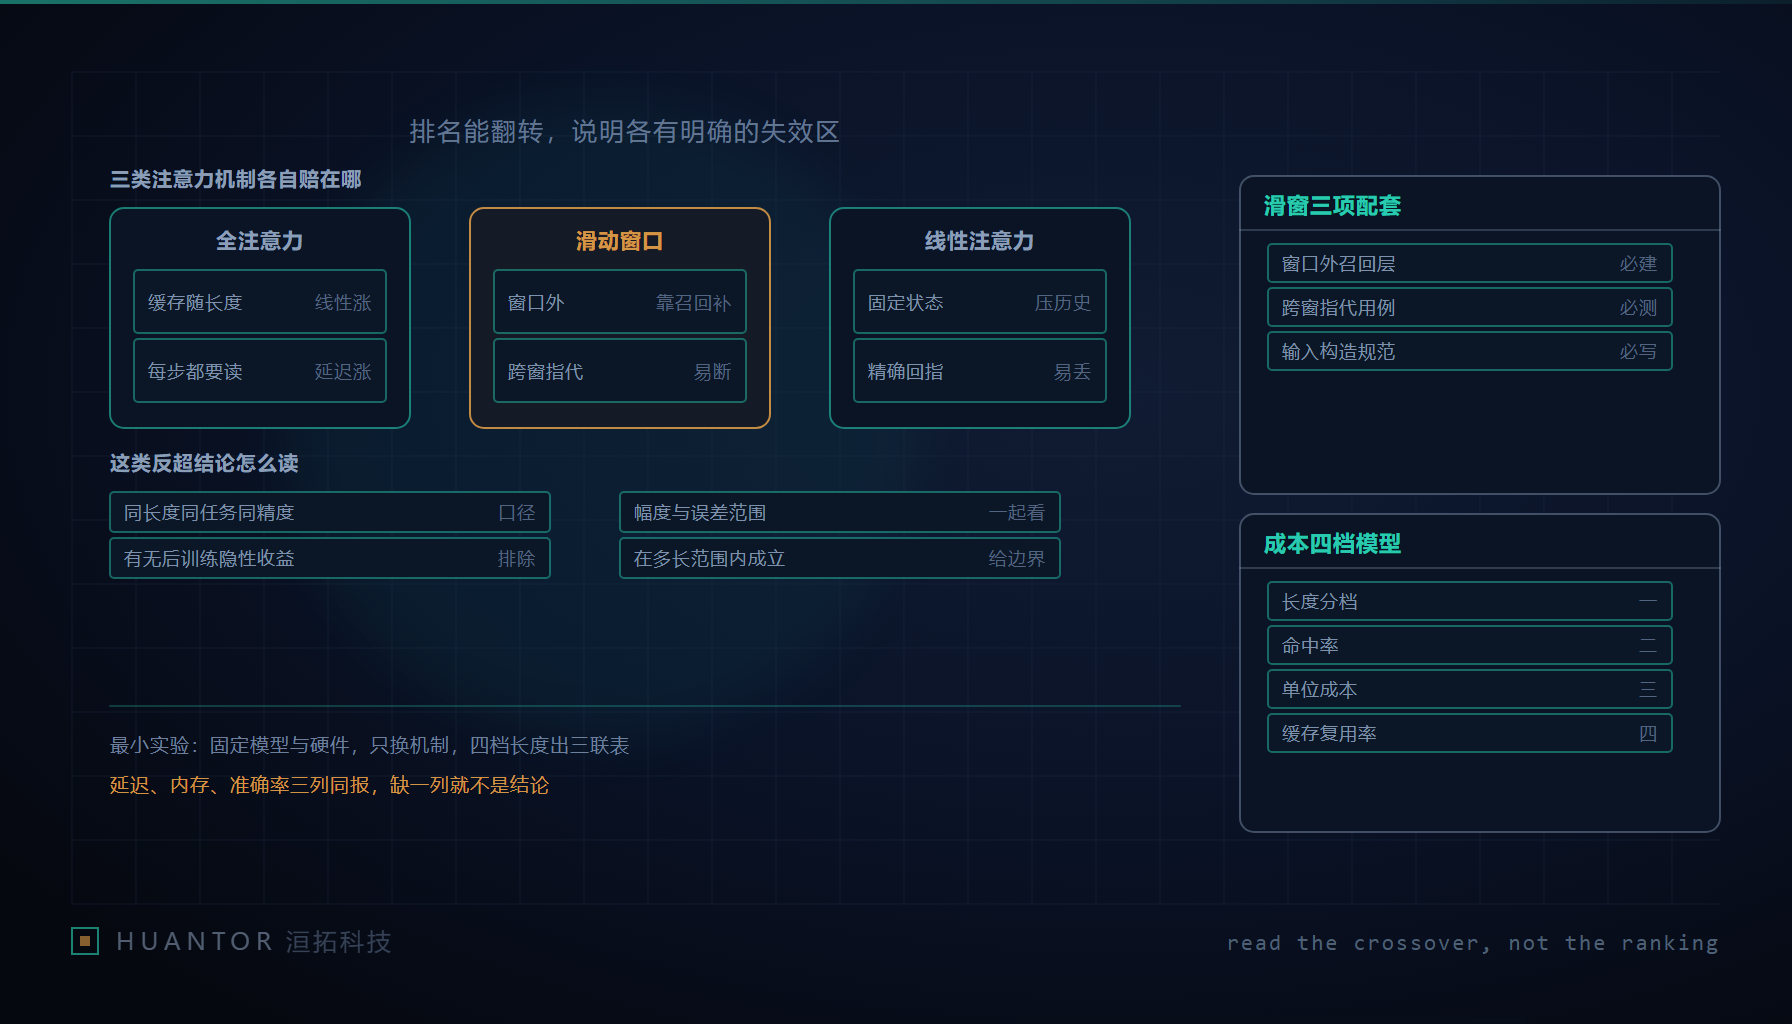
一、三条成本曲线,先说清各自赔在哪
公开讨论里有一项研究:上下文长度增加后,推理阶段的内存占用与能耗成为部署瓶颈;标准全注意力会为每个新词元保留此前所有词元的键与值,缓存随上下文持续增长,解码成本随之攀升;线性注意力想把时间与内存复杂度降下来;而该研究称无需后训练,只在输入里加四个词元,滑动窗口注意力就能在线性注意力之上翻回来。这里没有任何可核对的任务集、长度档位与降幅数据,所以本篇不引用它的结论做选型,只把它当作一条线索:能让排名翻转的技巧这么小,说明被比的两类机制本来就各自站在自己的失效区里。
| 机制 | 省在哪 | 赔在哪 | 失效的触发条件 |
|---|---|---|---|
| 全注意力 | 精确回指与远距离任意位置检索最稳 | 缓存随长度线性增长,且解码每一步都要读一遍 | 上下文长到缓存读写成为解码主耗时 |
| 滑动窗口 | 缓存与每步算量都被窗口长度钉住,不随总长增长 | 窗口外的信息只能靠召回补回来 | 关键信息落在窗口外,或需要跨窗口拼接 |
| 线性注意力 | 用固定规模的状态压缩历史,长度增加时内存增长被压住 | 压缩是有损的,精确定位与逐字回指容易丢 | 任务要求精确回指、小字段落或长距离一对一匹配 |
二、四个词元为什么能翻转,先验证它改了什么
机制上最可能的解释有两条。一条是窗口边界的对齐:滑动窗口在长文本上切块时,边界容易正好切在关键片段中间,少量前置或后置的记号会改变分块的位置,使关键内容落进同一个窗口。另一条是检索锚点变密:几个固定词元相当于给注意力提供了一个位置参照,让窗口外的信息更容易在解码时被重新够到。
这两条解释的工程含义完全不同,必须分开验证。要跑两个对照。第一个是不等长对照:加词元之后输入变长了,如果对照组的线性注意力没有拿到同样多的填充,那比较的不是机制而是长度。正确做法是给对照组补上与语义无关的中性填充,把表观长度拉平,再看排名是否翻转。第二个是位置打散对照:把关键信息在文档里的位置随机化、前移、后置各跑一组,如果翻转只在某一种位置分布下出现,那这套技巧改变的是任务的表观结构,而不是机制的能力上限。
这一步做完,才谈得上”这个技巧能不能用到我们自己的业务上”。业务文档的段落长度和信息位置是相对固定的,比如合同、工单、检测报告,边界对齐这类效应会稳定复现;而对话式长上下文的位置分布很散,同一技巧的收益就不一定在。
三、把这类结论读成可用信息的四步
- 口径是否对齐:同长度、同任务、同精度设置。三种机制跑在不同长度档位或不同数值精度上的比较,读不出机制差别。
- 是否含后训练的隐性收益:一项对照里如果一侧经过与任务格式相关的继续训练,收益就归不到机制头上。公开研究强调”无需后训练”,值得肯定的正是把这一项排除掉,但排除掉之后也要反问:加上后训练会不会让另一类机制反超。
- 反超的幅度与误差范围:只报单一差值、不报重复实验波动的排名翻转,与噪声不可区分。幅度接近波动范围时,正确结论是”这套任务分不出来”。
- 成立区间有多长:翻转往往只在某一段长度区间成立。要问的是它从哪一档开始不成立,而不是它在标称点上赢了。
四、业务侧的四档成本模型
长上下文的成本在我们自己的报价里按四个因子乘出来:上下文长度分档、命中率、单位词元成本、缓存复用率。命中率指输入里真正被用到的部分占比,它决定同样长度下实际算量的差别;缓存复用率决定多轮会话里前缀能省掉多少。两者都不进模型,就只剩一个长度数字,结论一定偏。
| 长度档 | 典型形态 | 命中率与复用特征 | 三类机制的推荐位 |
|---|---|---|---|
| 短档 | 单轮问答、短摘要 | 命中率高,复用低 | 三者差别小,按现有部署走,不必为机制改动 |
| 中档 | 多文档拼接、报告解读 | 命中中等,窗口外内容开始出现 | 滑窗优先,但必须配召回层,否则窗口外信息直接不可见 |
| 长档 | 长会话、代码库级上下文 | 复用高,前缀占大头 | 全注意力的缓存读写开始成为主耗时,线性注意力值得进实测 |
| 超长档 | 归档检索、批量比对 | 命中率被稀释,精确回指要求高 | 先测精确回指,再看省下的内存够不够抵回召成本 |
推荐位是”先测哪一档”的顺序,不是结论。跨档的成本关系不单调,一条曲线画不出三类机制的交叉。
五、滑窗三项配套与线性注意力两项必测
选滑动窗口,三项工程要同时上,缺一项就是把风险留给用户。窗口外内容的召回层:明确召回触发条件、召回片段长度和排序口径,并让召回结果在输出里可指认。跨窗口指代的显式检查用例:构造信息分属两个窗口的题,看模型是否漏掉前项;这类用例会稳定暴露缺陷,是滑窗最便宜的回归。关键信息在窗口内的输入构造规范:分段长度、字段前置、把必答项固定放在末段还是首段,写成文档交给上游,而不是靠调模型。
选线性注意力,生产前至少测两项。远距离精确检索:小字段落、编号、标识符、逐字回指这一类任务,压缩历史的做法在这里最容易掉。逐词元状态更新的延迟抖动:状态是每步都改写的,步与步之间的耗时不一定平稳,均值好看而长尾难看的部署在交互场景里会直接踩到。
六、最小实验方案:三联表必须一起出
给自研或选型的一份最小方案是:固定同一份模型权重与同一台硬件,只替换注意力机制,跑同一组任务,在四个长度档位上各出一组延迟、内存、准确率。延迟记分位数,内存记峰值与稳态两个值,准确率按任务类型分桶,三项同表同批出。
为什么必须一起出:只看准确率会漏掉长尾延迟,机制在离线跑分上占优而在线超时是常见结果;只看内存会漏掉命中率,省下来的缓存是靠丢掉窗口外信息换来的,不在同一张表里就看不出这是同一件事的两面;只看延迟会漏掉精度掉在哪一档,跨档的交叉点恰恰是决策点。三类机制的成本关系随长度改变斜率,任何一个单指标结论都只在它自己那一档成立。这套三联表在洹拓内部的用法很简单:把它当作机制换代的准入门槛,没有按档的三联数据,就不许在方案里写”某类机制更省”——这句话我们至今没有在任何一次交付里写过。