
AI 帮写之后,文本方差收窄,埋点要换一个指标|洹拓科技
一、这项研究里真正能抄的,是它选了方差而不是均值
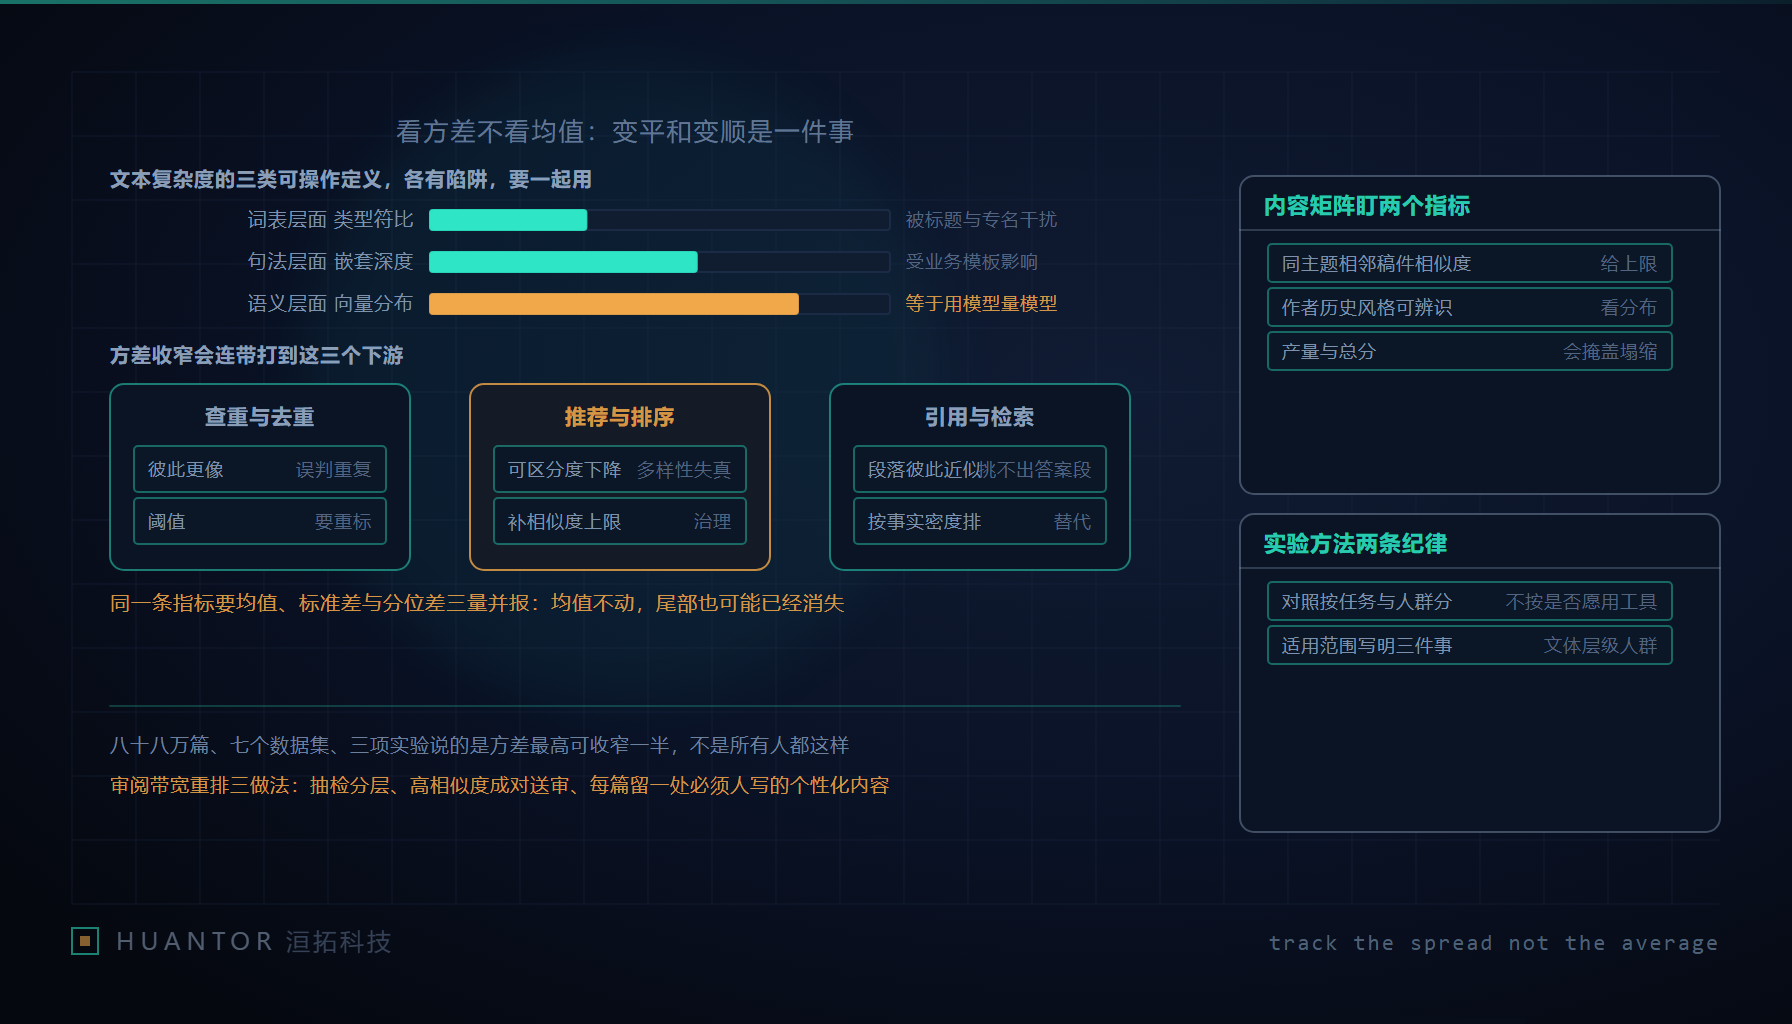
据公开报道,一项公开发表的研究跨了多项实验、多个数据集,分析了几十万篇量级的真实文本,给出的核心数字是:当大模型普遍介入写作后,文本复杂度的方差最高可收窄一半。这个数字先放到一边,它不是可以对任何人套用的结论,也不该被当成行业通则;这项研究真正值得做内容的人拿去复用的,是它选的那个观察量——方差,而不是平均质量分。原因很直接:均值会掩盖分布的塌缩。一批文本整体变得“规整”的时候,平均复杂度很可能几乎没动,但它的尾部消失了——过去会写长句、会口语、会夹带个人痕迹的那些样本,和过去写得干巴巴的那些样本,被同一个助手拉到了一条线上,平均值不变,可分布收窄了。只盯均值的话,这件事在报表上是隐形的。所以我们主张一个能落地的做法:任何一个用来观察文本形态的指标,都要同时报三个量——均值、标准差和分位差,比如中位数与第九十分位之间的距离;只给均值等于没给。埋点层面也一样,从只记录“内容质量分”改成同时记录这个分数的分布宽度。落到埋点字段上,就是给每篇稿件多存一个“与同主题近邻的平均相似度”和一个“本文在历史分布里的分位”:前者管塌缩,后者管离群,两个都进看板,才不用等出了问题再回头补数据。
二、“复杂度”要落成三类可操作定义,而且不能单选
麻烦在于“文本复杂度”不是一个现成的字段,得自己定义,而每一种定义都有坑。我们的原则是三类一起用,不要单选某一个当唯一指标。
- 词表层面,用类型 token 比和罕见词占比来衡量用词的丰富度。它的陷阱是很容易被标题、专有名词和品牌词干扰:一堆型号名会让数字虚高,却不代表语言更生动。
- 句法层面,用句长和从句嵌套深度来衡量结构复杂度。它的陷阱是受业务模板影响极大,同一批内容只要套了同一种开头结尾模板,句法指标就会一起塌下去,跟写得好不好无关。
- 语义层面,用文本向量在空间里的分布来衡量意义的多样性。它的陷阱最深,它依赖嵌入模型自身的偏好,等于用一个模型去量另一个模型影响下的文本,助手和量尺可能共享同一套偏见。
三类各管一个侧面:用词、结构、意义。单看任何一类都会被上面那个坑骗到,三类合起来才敢下“分布到底有没有收窄”的判断。操作上,我们给每一类各设一条下限而不是上限:要的不是文本多复杂,而是不许整批一起跌破某个水位,一旦集体跌破,就说明分布在被压窄。这里要提醒一句,具体指标叫什么名字并不重要,重要的是每一类都要有对应的抽检口径;不要为了省事,自拟一个新名词就往看板里放。
三、方差收窄砸到的,是下游三个系统
对做内容、做 GEO、做推荐的人来说,“看起来更规范”和“可辨识的信息变少”是同一件事的两面。文本彼此更像,会连带影响三个系统,每个都要提前配一条治理动作。
| 下游系统 | 会出什么问题 | 对应治理动作 |
|---|---|---|
| 查重与去重 | 文本彼此更相似,正常的改写被判成重复,误伤原创 | 把阈值从“绝对相似”改成“相对本主题历史基线”,别一刀切 |
| 推荐与排序 | 内容间可区分度下降,多样性指标看着在掉其实没坏 | 排序里补一个分布项,盯方差而不是只盯单篇相关性 |
| GEO 与引用 | 改写后的段落彼此近似,检索侧挑不出最能回答的那一段 | 同主题稿件做一次择优,只让区分度最高的版本参与引用 |
以洹拓做 GEO 交付的经验,第三行最容易被忽略:当一批稿件都改写得差不多,检索端没法判断哪一段真正回答了问题,引用质量会下降,而原因不在单篇写得好不好,在于它们太像了。查重那条也要算成本:误伤一篇原创,补回去的编辑工时远大于放过去一篇雷同,所以阈值宁可偏松,再把人工集中在高相似的那一层。
四、内容矩阵真正该盯的两个内部指标
做内容矩阵时,最实用的两个内部指标不是产量,也不是平均分,而是下面这两条。
- 同一主题下,相邻稿件的相似度分布上限:管住“我们在批量制造雷同”这件事。一旦某个主题下两两相似度顶到上限,就该提示换角度,而不是继续加产量。
- 某作者历史风格的可辨识程度:把同一个人前后的文本放在一起,看他能不能被认出来;掉了,就说明助手把这个人的痕迹磨平了。
为什么这两个比“产量”和“总分”值得盯?因为产量只证明多,总分只证明平均不差,二者都看不见塌缩;而这两个指标天生是分布指标,直接反映多样性有没有在流失。把它们设成内容团队的一等指标,比再加一条“必须用助手”的流程更有价值。
五、文本变像之后,审阅带宽要重排
当所有稿件彼此更相似,人工审阅的价值也要跟着挪位置:从“改错”变成“挑选值得留下的那一点特征”。错的地方本来就被助手抹得差不多了,值得人看的恰恰是那一点点不一样。配套三个做法。
- 抽检分层,而不是全量逐篇看:按主题、按来源、按相似度分桶,优先看相似度异常高的那一层,把人的时间用在刀刃上。
- 把高相似度对成对送审:不要一篇一篇孤立地看,把最像的两篇并排放,人眼更容易判断该留哪一篇、该给哪一篇补差异。
- 给每篇留一处必须人写的个性化内容:一个真实数据、一句现场话、一个具体案例,强制保留一处助手生成不出来的东西,防止整篇被拉平。
这三条的本质,是给“方差”留出人为的落点,让审阅从守底线变成保上限。说白了,全量逐篇看在这种局面下已经不划算,把带宽集中在高相似的边界样本上,才是同样的多头能多拦住塌缩的地方。
六、实验方法的两条纪律,和一句对客户的实话
最后回到方法本身。这类研究有两个地方最容易被夸大,也正是我们要守的两条纪律。
- 对照要按任务和人群来分,而不是按“愿不愿意用工具”来分:愿意用的人和不愿意用的人本来就不一样,拿他们直接对比,测出来的是人群差异,不是工具影响。
- 结论的适用范围要写明:说清是哪类文体、哪一层面的度量、哪个人群,超出这个范围就不能外推。
之所以容易被夸大,是因为方差这类结论很反直觉、很适合被写成一句耸动的数字;而据公开报道给出的那组实验、数据集与文本量级,也常被脱离适用范围地引用。所以我们把它当成一个信号,不是一个裁决。给客户的那句实话是这样:AI 帮写不会让内容变差,但会让内容变平;要让内容真正有效,投入方向是差异化和事实密度,而不是通顺度。通顺是助手能给的,差异和事实只有人能补——这也正是我们把度量从平均分换成分布宽度、把审阅从改错换成挑选的原因。