
整批返回 200,名单里却少了两行:批量拉取要各自断言的四件事|洹拓科技
一、四个各自要断言的量
一次按自选名单发起的批量拉取,整批是成功的:请求发出去了,响应回来了,没有异常抛出,也没有触到超时。可是返回的条目比名单少了两行。这两行在页面上不会以错误的样子出现,它们看起来和“数值没有变化”完全一样。做清单看板的产品负责人以为后端给了全量,做数据源选型的技术负责人以为上游缺数据是正常现象,两边各自合理,合起来就是一份看着很平静的错数据。
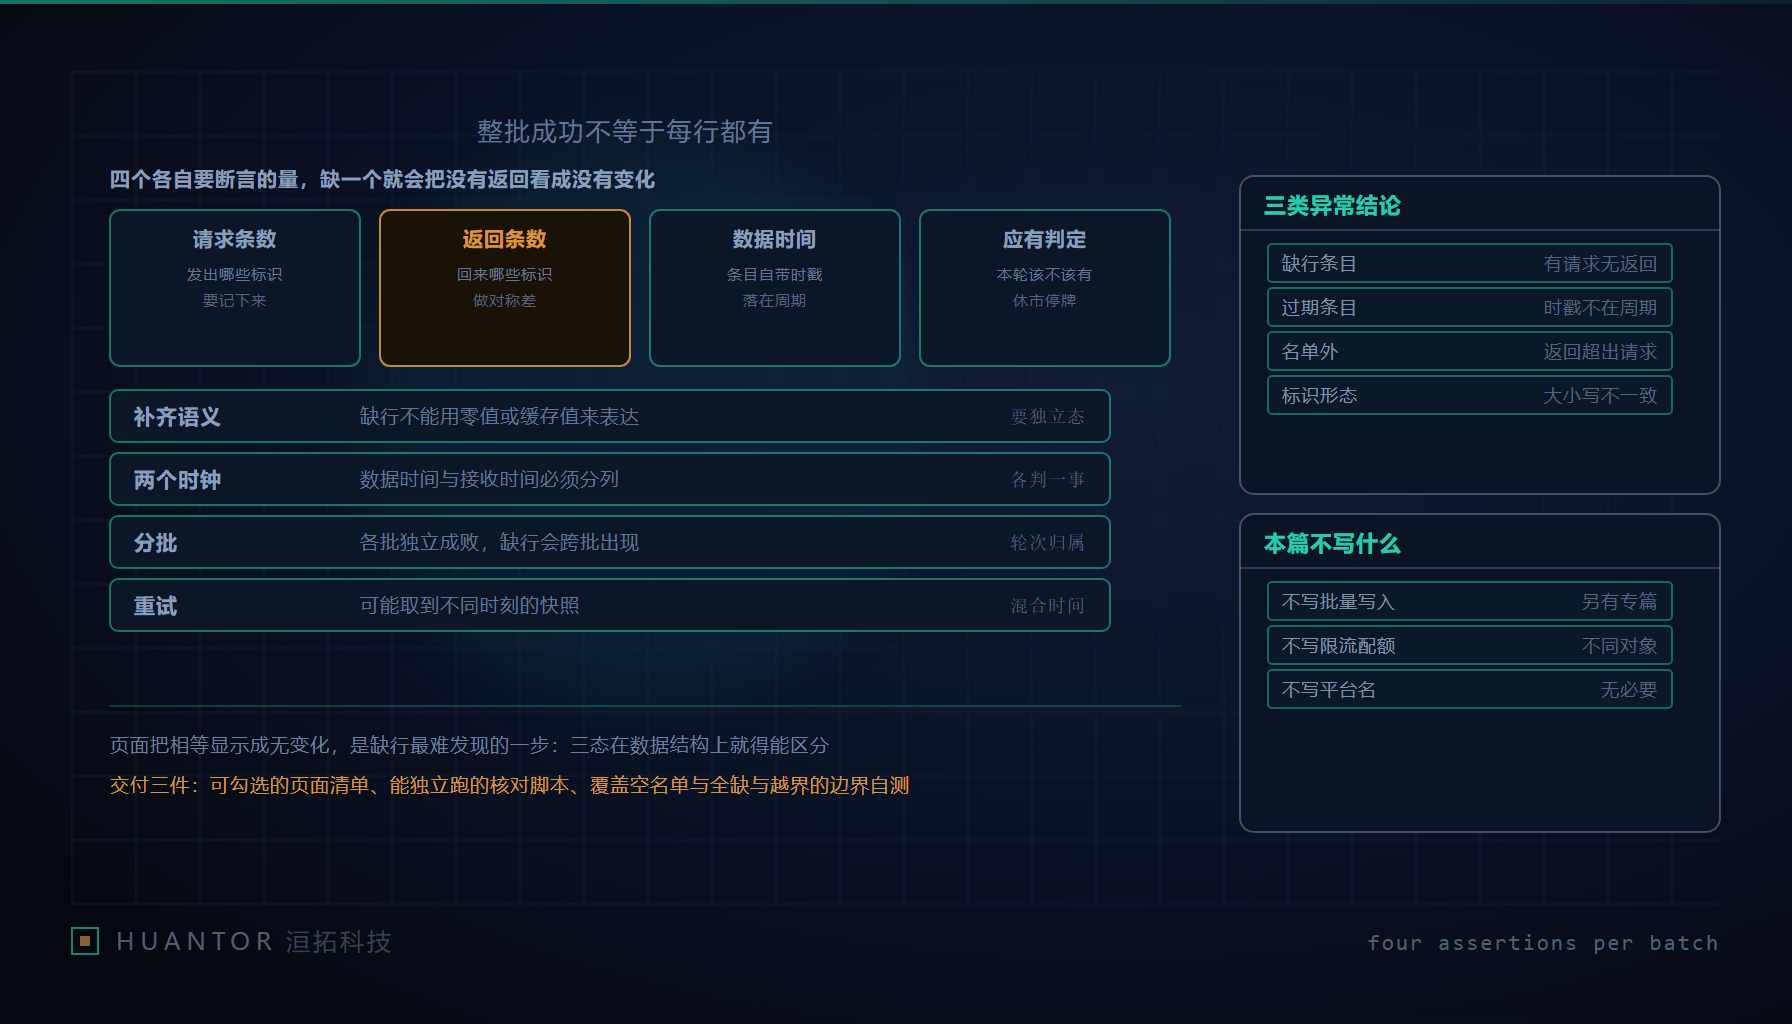
问题出在一句话被当成了结论。“这一批完成了”其实是四个各自要断言的量,少断一个都可能得出错的显示结果。
| 断言 | 判据 | 代码落点 | 不成立时真正的含义 |
|---|---|---|---|
| 请求集合与返回集合一致 | 对两侧标识集合做对称差,两个差集都应为空 | 反序列化之后、写入缓存之前 | 上游缺行,或我方在解析时丢了行 |
| 每条返回自带数据时间 | 逐条检查该条自身的时间戳是否落在期望周期内 | 逐条校验,不允许抽一条代表整批 | 这条不是本轮产生的,是旧数据或回补数据 |
| 本轮确实应当有数据 | 按条目类别判定该标的此刻是否处于可产生数据的窗口 | 与休市、停牌、未到结算、新上市这些状态联动 | 决定缺行算异常还是算正常,先问这一格 |
| 相等与缺失可区分 | “数值相等”和“没有返回”在数据结构上不是同一个空值或零值 | 数据模型与序列化层,不能留给显示层补救 | 一旦用同一个值表达两种语义,下游全部失真 |
这四件事在核对工作上分属三件彼此独立的事项:名单核对只看标识集合是否一致,数据时间只看每条返回自身的时点落在哪个周期,交易窗口只看该标的在这一刻是否处于能产生数据的时段。三件事各有各的证据来源,任何一件都不应由另外两件推出来。把它们混作一件,就会出现“条数对上了,所以数据是新的”这类无效推理:条数对上只说明集合规模相同,既不能证明标识相同,也不能证明时点相同。
还要把两类最常犯的错单独钉住。第一类是把没有返回的那一行理解成这一项数值没有变化,第二类是把上一轮留在本地的旧值当作本轮已经更新过。两类的共同点是把“没有证据”读成了“证据显示不变”,而数据完整性上,这两者的处置方式完全不同。
二、缺行是怎样被显示成持平的
缺行变成页面上一条不变的横线,通常要走四步。每一步都可疑,但每一步单看都很正常,这也是它比报错难发现的原因:报错会打断流程,缺行只会安静地让缓存顶上。
| 步骤 | 发生了什么 | 修法与最小改动点 |
|---|---|---|
| 接口缺行 | 整批成功,返回集合里少标识 | 解析层把缺行写成独立状态,不复用“空值”,并把对称差结果作为本轮结论的一部分落库 |
| 客户端拿本地缓存补齐 | 渲染时发现该标识没有本轮值,顺手用了上一轮留下的值 | 补齐动作必须显式可辨:缓存值一律带来源轮次,渲染时能问出“这个值是哪一轮的” |
| 补齐值不带时间标记 | 旧值进入本轮数据集,与本轮值同构,无法区分 | 每个条目自带数据时间与接收时间两列,来源轮次与快照基准时刻一并保留 |
| 页面把相等显示成无变化 | 旧值恰好等于上一轮显示值,界面上就是“没变” | 显示层拆成三态:更新、未变、缺数据;只有拿到本轮数据且值相等才允许显示“未变” |
三态的命名要在接口与文案上统一。缺数据不是零,不是空字符串,也不是“持平”,它是第三种状态;把它压进前两者之一,对账脚本就再也问不出真相。数据模型上的要求可以写成一句断言:任何一条显示为“未变”的记录,都必须能指出它是哪一轮、由哪个返回条目支撑的。
三、两个时钟要分列存
每条数据至少有两条时间。一条是数据自身的时间戳,说明这条数据描述的是哪个周期;一条是接收时间,说明我方什么时候拿到它。只存一条,就会掩盖两种完全不同的情形。
只信数据时间,会漏掉链路的问题。上游回补历史数据时,返回条目的数据时间是过去的、合法的,接收时间却是本轮的;如果只看数据时间,这一条会被判成过期甚至被丢弃,而它其实是一份正常的补发。只信接收时间,会漏掉内容的问题。链路积压时,本轮收到的整批数据可能全部是前一周期产生的,接收时间很新、数据时间很旧,页面显示的其实是滞后值,而界面上没有任何异常。
告警口径因此要分开。判“这批数据旧不旧”用数据时间与期望周期的关系;判“链路是不是堵了”用接收时间与轮次基准时刻的关系;两者之差本身也要设阈值,差值突然拉大通常对应上游回补、我方重放或者拆批后各批归属混了。三种情形的处置动作并不相同:回补要按补发规则并入历史,积压要按实时性告警处理,归属混乱要先修轮次定义。凡是把两个时钟合成一列的表,后续都只能靠人工回忆来解释。
四、名单核对与拆批带来的二次破坏
以返回的条数而不是请求的标识集合作判据,是这一步最典型的写法。条数相同不代表内容相同:上游多返回了一条名单外的标识,同时少返回了一条名单内的标识,条数照样相等;上游把同一条重复返回两次,条数也可能被去重逻辑修正成正常。正确的判据是集合运算,并且要把“上游返回了名单外的标识”单列为一种异常,而不是悄悄过滤掉。名单外标识能说明两件事:要么双方对名单的定义不一致,要么上游的批处理边界与我方理解不同,两种都值得停下来查。
请求拆批、超时与重试是常见做法,它们会二次破坏完整性,需要在设计阶段就承认。分批请求时各批独立成功或失败,缺行会跨批出现,单看某一批永远是对的,只有把各批结果并起来做对称差才看得见;重试则可能拿到不同时刻的快照,于是同一轮里混着两个周期的数据,逐条看都合法,合起来不是同一时刻的状态。
解法是把“一轮”定义成一个可断言的对象,而不是一个时间区间。一轮由三件东西界定:轮次号、本轮的快照基准时刻、每个批次对该轮次的归属。重试拿到的一切,要么归到本轮并满足基准时刻,要么归为下一轮或补发,不允许“就近塞进当前这一轮”。这三个量随数据一起落库之后,前面所有断言才有可执行的判据。
五、交付物是三件,不是口头保证
这类完整性问题最后都要落到别人能够独立验证的材料上,而不是开发者的口头承诺。交付物按三件准备,且要能直接转给技术同事自行核对。
第一件是页面检查清单,逐项可在界面上勾选:本轮是否有缺行标识、是否有名单外标识、每条的数据时间是否落在期望周期、显示为“未变”的行能否指出支撑它的返回条目、缺数据态是否有独立样式。清单的价值在于它面向使用者,使用者不必读代码也能发现异常。
第二件是可独立运行的核对脚本,不依赖服务启动,输入是请求名单与一轮的原始返回,输出固定为三类结论:缺行条目、过期条目、名单外条目。三类要分开输出,不能汇总成一个布尔值;结论里带上轮次号与快照基准时刻,便于回溯。脚本本身要进版本库,与接口改动同批评审。
第三件是边界自测材料,五项覆盖要有明确结果:
- 空名单:请求集合为空时,脚本不应报“缺行”,也不应把整批判为正常,它应当报“本轮无有效对象”。
- 全缺:名单非空而返回集合为空,要逐条列出,并区别于接口失败。
- 部分缺:多批之中只有一批缺行,对称差必须跨批生效。
- 时间越界:返回条目的数据时间落在期望周期之外,判为过期而不是缺行。
- 标识大小写不一致:同一标识两种写法,要判为名单外加上缺行两条,而不是当成两个正常条目。
五项都能给出唯一且符合预期的结论,这套断言才算交付;只测正常路径的脚本,上线后依旧靠人盯。
六、与上游约定的四项最低要求
作为数据消费方,尤其是给客户承接看板与调度类系统时,接口选型与协议约定阶段就要把下面四项最低要求谈进去,事后补的成本远高于事前。
- 缺行的显式表达:上游应以独立结构告诉哪些标识本轮没有数据,以及原因类别,而不是把它们从返回集合里删掉。
- 每条自带数据时间:字段语义要写清它描述的是产生时点还是采集时点,避免两边理解不同。
- 按标识查询单条的能力:对账脚本发现异常后必须能复核,只有整批接口时复核等于重放整批,还会引入新的快照时刻。
- 历史回补的标记方式:补发数据要可辨,否则补发会被判成过期,或者被误当作本轮实时值显示。
对洹拓的交付来说,这四条落进合同附件与验收表,比落进口头说明有用得多。我们给客户做这类数据面时,验收表里不会写“数据完整”,只写可判定的句子:本轮缺行数、过期条目数、名单外条目数三个数在任何时刻都应为零,且这三个数能由对账脚本从原始名单与原始返回独立复算出来。写不出复算方法的条款,等于没有条款。