
签名库拿到的是头加二进制:流与字节要分清|洹拓科技
一、报错出在最后一跳,线索藏在第一跳
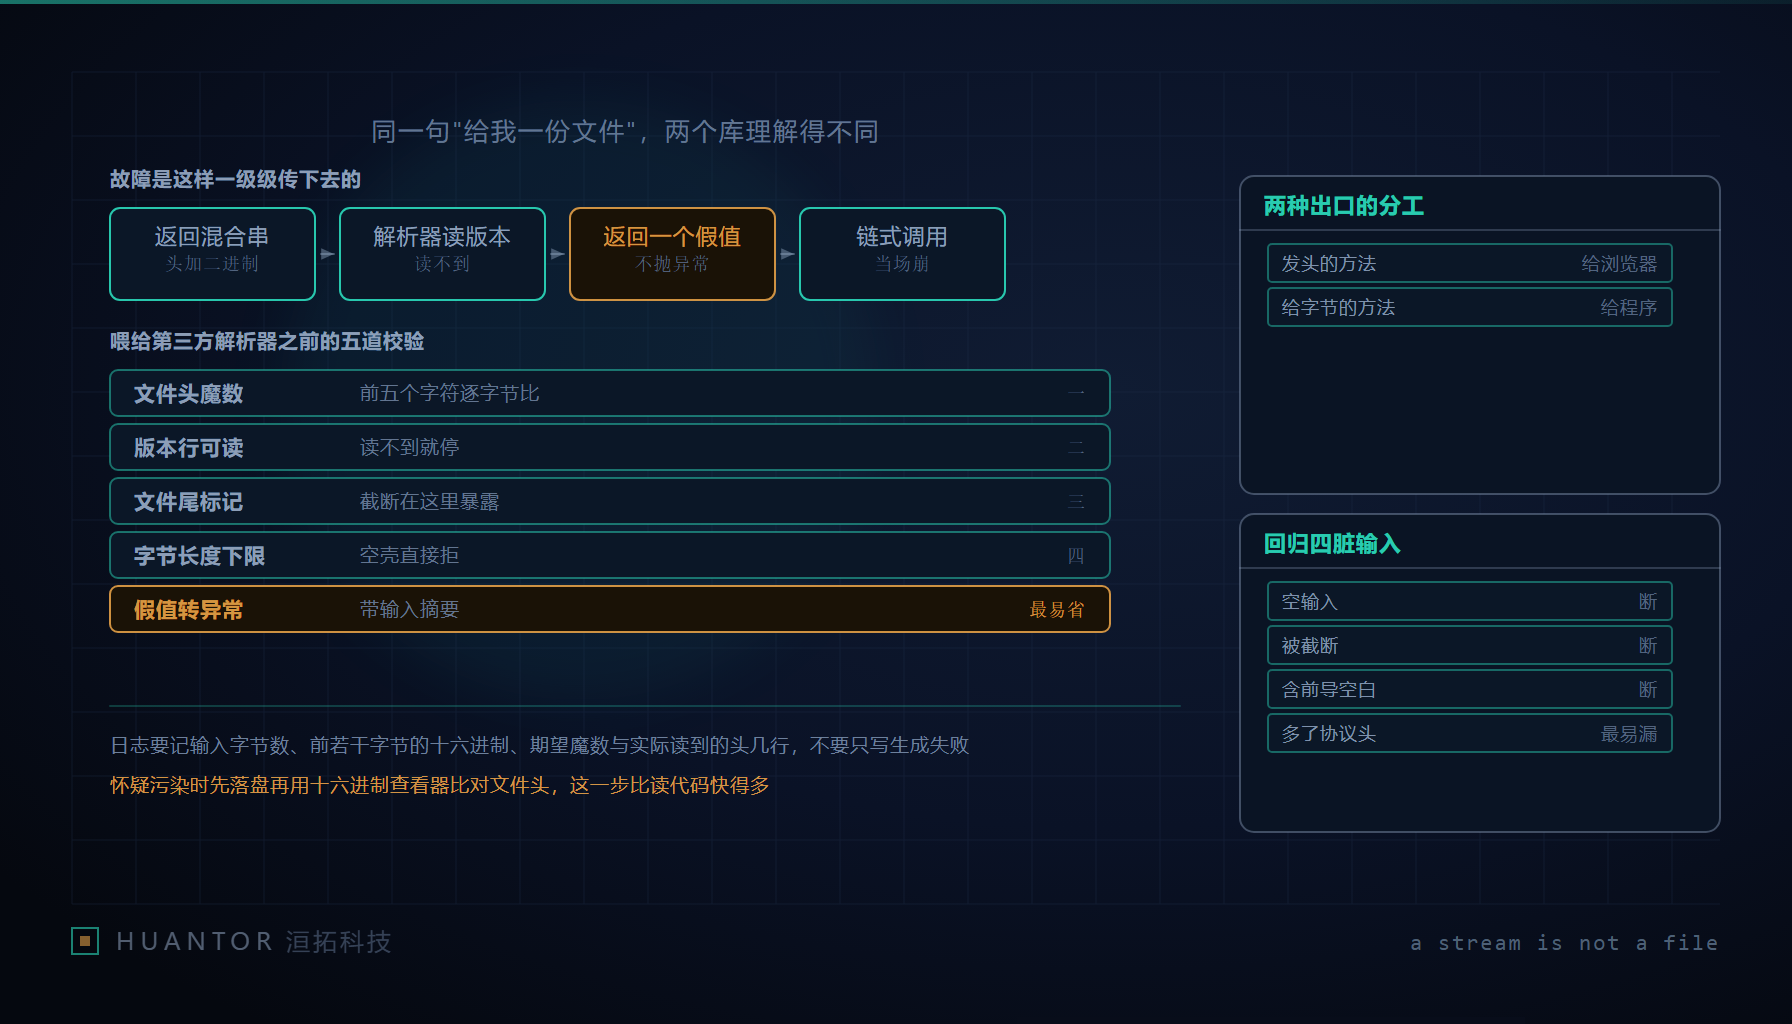
先把现场完整还原一次。一个 PHP 后端里两个库配合的链路:上一步调用生成端的某个方法,本意是拿到“这份文件的内容”;下一步把它交给一个以成熟 PDF 引擎为核心的签名扩展做签注;再往下是对返回对象继续链式调用。真正跑出来的报错却是一句看似不相干的话——“在布尔类型上调用成员方法”。
绝大多数排查者的第一反应是去翻签名库的文档、比对版本兼容、怀疑对方接口有 bug。这个方向是错的,因为报错文本里的类型名并不是故障的原因,它是脏数据穿过边界之后留下的指纹。把这条链拆成三段,每段的证据位置完全不同。
| 链路段 | 现场表现 | 该问的问题 | 证据在哪 |
|---|---|---|---|
| 生成段 | 返回的不是纯字节,而是六行以上的头文本再拼上 PDF 二进制,其中能看到 HTTP/1.0 200 OK、Content-Type: application/pdf 这类行 |
这个方法返回的到底是“一份响应”还是“一份内容” | 返回串的前若干字节 |
| 解析段 | 要求输入以 %PDF- 加版本号的魔数开头;读不到版本号时不抛异常,直接返回布尔假值 |
它失败的时候有没有把失败说出来 | 该接口既返回对象又返回假值的两用约定 |
| 调用段 | 链式调用在布尔值上取成员方法,报错指向最后一跳 | 上一跳为什么把布尔给了我 | 调用栈往上一层的那个返回值 |
于是这条故障链的推理法就有了一条固定顺序的三问:第一问,上一跳为什么返回布尔;第二问,它拿到的字节前五个字符是什么;第三问,才轮到怀疑解析器或签名库本身。前两问各花不到一分钟,第三问却常常把整条链路从头读一遍还没找到入口。
二、“给我一份 PDF”在两个库里指的是两件事
这篇真正想留下的判断是:同一个业务名词,在两个库里有两套互不兼容的定义。生成端那一侧的“输出一份 PDF”,指的是一个可以直接发给浏览器的响应——它要负责头、负责缓冲区、负责在合适的时机结束请求。签名端那一侧的“给我一份 PDF”,指的是一段可解析的纯净字节——它假设拿到的第一个字符就是格式签名。
把这两件事写进同一个方法,污染就必然发生:响应头被拼进了正文。正确的分工是拆成两个出口,并且职责不许重叠。谁负责发头,谁负责给 body,一个出口只做一件事。
命名要把语义写出来,否则调用方只能靠猜。我们在洹拓的封装层里定的是两条硬规矩:名字里带投递类动词的出口一律视为“有副作用、不返回可用值”,禁止作为任何解析器的入参;名字里带取回类语义的出口才允许继续往下传,且它的返回类型必须在文档注释里写死为字节串。一个类同时提供两个出口时,还要给“取回值”这一路配一行最短的用法示例,让下一个接手的人不必去读实现。
这条分工不只对 PDF 成立。电子表格导出、逗号分隔文件下载、图片压缩回传,全都是同一个形状的问题:一个方法既想当发送器又想当值工厂,最后两头都不干净。
三、喂进第三方解析器之前的五道最小校验
第三方解析器不应该承担“判断输入是不是它期望的东西”这份责任,它只应该在输入合规的前提下工作。喂进去之前在封装层做五道最小校验,成本很低,收益是错误现场立刻可读。
- 魔数与版本行。起始位置必须命中该格式的文件签名标记,就 PDF 而言是
%PDF-后面紧跟版本号。前面有空格、有换行、有字节顺序记号,都算不过——因为这类文本在位置上就是错位的。 - 文件尾标记。结尾区段要能找到表示结构收尾的记号,也就是
%%EOF及其前后的交叉引用位置。只有头没有尾,说明中途被截断,多半是缓冲区提前刷新或者输出被别处接管。 - 字节长度下限。按业务上“最合理的最小文档”设一条阈值,低于它直接判为生成失败,不再往下喂。阈值定多少不重要,重要的是不许没有。
- 能否成功载入。用解析器自己的装载接口显式跑一次,把“装载成功”当成一个必须断言的条件,不许默认成功、不许跳过返回值。
- 假值即抛。只要上一步返回布尔假值,当场抛出,绝不允许一个布尔值进入下一跳的链式调用。
五道校验要写在封装层而不是业务层,一份实现多处复用;每一道的失败要带自己的原因码,不许合并成一句“文件无效”——合并之后,日志和报错又回到了无从判断的状态。
四、用假值表示失败的接口,要在边界处转成异常并留摘要
一部分库的公开接口沿用了历史约定:成功返回对象,失败返回布尔假值。一个返回值承担两种语义,调用方只要写成链式,失败就会以“类型不对”的形式在远处爆出来,而真正有信息量的现场——拿到的到底是什么字节、多长、从哪条分支生成——全部丢失。
处置规范是把两用返回值在边界处收敛成单一语义:封装层接住假值,立刻转成异常,异常消息必须携带输入摘要。摘要内容我们固定成六项:前十六字节的十六进制表示、总字节数、期望的魔数、实际读到的前几行文本、生成它的类与方法名、当时生效的配置快照。
为什么用十六进制而不是把原文拼进去:二进制区段不可打印,直接拼接会把日志本身的行结构破坏掉,还会让后续检索失效;十六进制既保留了判定所需的全部位置信息,又保持文本可查。十六字节这个长度也是有讲究的——它刚好足够区分三种完全不同的现场:混进了报文头、开头是空白或记号、真文件在很靠前处就断了。再长收益递减。
五、日志记什么,回归断什么
日志字段这一节最容易被写成一句“生成失败”,而那正是排查中最没有用的四个字。要落的字段我们列成这样:输入字节数与输出字节数、前若干字节的十六进制、期望魔数与实际读到的头几行、生成方法的调用来源(类名、方法名、模板标识、配置快照)、落盘路径与校验和、以及这五道校验各自的通过情况。落盘路径与校验和只在排查期开启,注意留存范围要限定在排查目录内。
回归用例用三段法:生成、签注、验签三段各自可以单独断言。不要把三段合并成一条端到端用例就算完——端到端只能告诉你“坏了”,分段的用例才能告诉你“从哪一段开始坏”。三段之外,脏输入至少覆盖四种,一种都不许省:空输入、被截断的输入、含前导空白或字节顺序记号的输入、内容本身正确但被多塞了几行头的输入。第四种最像正常输入,长度够、尾部标记在、魔数也在开头某处,偏偏第一位不对,它往往在生产环境里才第一次暴露。
六、把传输编码写进联调清单第一页,再留一个自查动作
跨系统对接时,这类故障有一半能在合同层面避免。接口约定必须写明“传输编码”这一层到底约定的是什么:给的是原始字节,还是带协议头的完整响应;是二进制直传还是做了 base64 封装;是否分段传输;内容是否已经压缩过。这一条要写在联调清单的第一页,不要塞进附录——第一页会被签字,附录不会。把这条写清楚,等于把“谁负责发头”这件事在两人握手时就分掉了。
自查动作也给一个可操作的:任何“文件类”接口在怀疑污染时,先把返回值原样落盘,再用十六进制查看器对比文件头,看起始位置是不是格式签名、中间是不是混进了可读文本行。按洹拓交付现场的经验,这一步比通读代码快十倍,因为它给出的是位置而不是猜测;拿到位置之后,再回头判断该改生成端还是改调用端。
最后收口到一条更一般的纪律:边界处不留脏数据。校验不过就当场抛出并把摘要写进异常,让第一跳就把话说完。签名与验签这类环节的失败代价是对外交付物不可用,不是日志里多一行错误,在喂进解析器之前拦一次,永远比事后回查整条链路便宜得多。