
整数不会溢出,但它按位收费:30 位一节,代价在乘法上
一、把整数当成一个有体积、有耗时的对象
日常写法里,整数是免费的:赋值不要钱,加法不要钱,多大都一样,反正不会溢出。这份公开拆解做的第一件事,就是把这个直觉拆掉。它给的口径是:整数对象固定占用约 28 字节,此后每多一节数字再加 4 字节,每一节存 30 位。换句话说,代价不是按会不会溢出收,是按有多少位收。不溢出是运行时的能力,不是成本模型,这两件事分不开,账单就读不懂。
要把一个”值”变成可核对的判断,只需要三个量。我们做技术评审时也只问这三个:
- 占用字节数:单个值在内存里占多少,进了容器之后又占多少;
- 单次运算耗时随位数的增长阶:是跟着位数近似线性走,还是比线性更陡;
- 字符串化耗时:同一个值转十进制文本、转十六进制文本、转字节序列,三者相差多少。
第三个量最容易被忽略,又常常是实际压垮服务的那一个。线上见到的多数”某个接口突然变慢”,不是乘法慢,是把一个大整数写进日志、拼进返回值、塞进缓存键的那一步慢。
需要声明:文中的数字来自一份底层拆解,是别人在其环境下的口径,不是我们在客户机器上跑出来的结果。引用它,是因为它给了一张可以照着核对的账单,不是因为它能直接换成本方的结论。洹拓这边做这类评审时,也是拿这三个量去问客户自己的实现,而不是拿文章里的倍数替客户预估。
二、每节只用三十位,这个设计值得读一遍
底层用一个 32 位无符号量做存储单元,但只使用其中 30 位有效值,留下 2 位。留出来的两位给进位与中间计算的余量,理由很直白:两个 30 位的数相乘,中间结果最大可到 60 位,正好落在两个单元的范围内。
这样做的收益是乘法过程中不必在每一步都插入一次”这一节会不会溢出”的判断;代价是每节有 2 位空间被永久闲置,并且跨节的进位传播要单独处理。理解到这里,就能明白为什么跨节运算会有额外开销——不是实现写得粗糙,是它在一个折中点上工作。定宽运算快但不准,变宽准确但不快,30 位一节是两者之间取的那一档。
这类设计值得读一遍的原因不在记住 30 这个数字,在建立一种判断方式:凡是折中点,都会在折中点之外的那类操作上收钱。写代码时能感知到的形式是,单节之内的运算便宜,一个值一旦跨过节边界,同一行代码的成本就变了,而源码层面看不出任何区别。审查大整数相关代码时,我们只看一件事:这一段的输入位数会不会跨过它现在所在的那一节。
三、加法近乎线性,乘法是另一回事
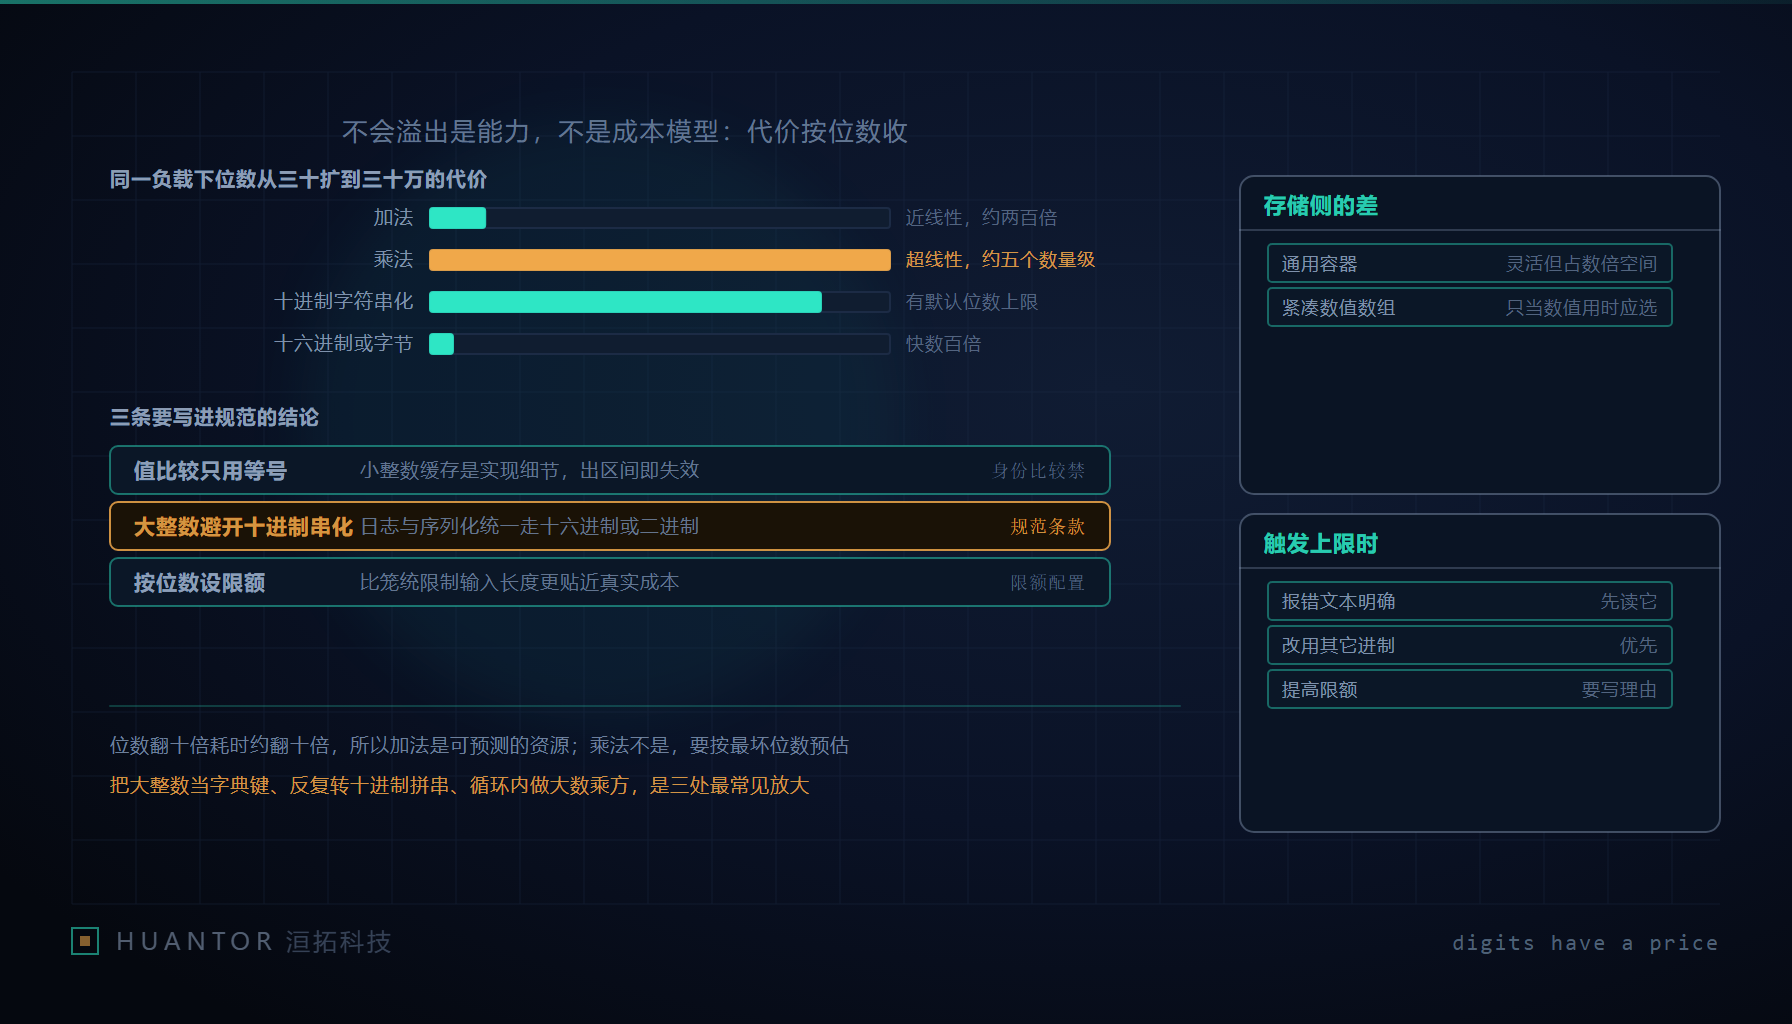
位数从 30 扩到 300000,加法耗时约增近两百倍,乘法耗时约增五个数量级。两条曲线的形状不同,工程含义完全不同,混为一谈就会做出错误的容量判断。
加法的近乎线性意味着位数是一个可预测的资源:位数翻十倍,耗时大约跟着翻十倍。可预测的东西才有限额可做——可以按位数设阈值、按位数设超时、按位数设并发。凡是”输入长度决定成本”的线性关系,都应该在入口侧写成一条明确的上限,而不是等到运行时才发现。
乘法的超线性意味着位数上去之后单位成本失控,平均值会骗人。因此在设计哈希、加密与组合数学这一类计算时,要按最坏位数预估,不按平均位数预估。一批请求里位数最大的那个值,决定了这一批的耗时上限,其余值再快也不能把这一点摊平。我们评审这类代码时会要求两件事同时写下来:最坏位数是多少,以及什么样的输入会把位数推到最坏值。第二条写成测试的说明文字,避免半年后没人记得当初为什么这样设。
同一份拆解还给了一个对照:在同一量级下,十进制字符串化、十六进制与字节序列转换的耗时可以相差数百倍。这条比位数本身的结论更实用,因为它指出了一种几乎零成本的规避方式。
四、小整数缓存不能作为正确性依据
拆解里提到,-5 到 256 这段区间的整数被缓存,超出之后同一字面量转换出来的对象不再是同一个。这里埋着两个坑,第二个比第一个隐蔽。
第一个坑是身份比较。用身份而不是值去比较整数,在这段区间内恰好成立,出了区间就错。它的危险不在于”有时候会错”,在于它在开发环境里几乎总是对的:日常调试用的数值大多落在区间内,等到生产环境里出现一个较大的标识值才出问题,而且崩在一行看起来毫无问题的比较上。这类”大部分时候对”的写法是最容易漏进生产的缺陷之一。处置方式只能是规范禁止:值比较只用等号,身份比较只留给确实需要判断同一对象的场合,而在整数上这种场合几乎不存在。还要补一句,缓存区间是实现细节,不是可依赖的语义。
第二个坑是把常量折叠的结果误读成缓存机制。有些写法在编译期就把字面量归一了,于是两份相同写法得到同一个对象,测出来”相等”的现象成立,但这与运行期那段缓存区间没有关系。前者是编译期产物,后者是运行期实现细节,两者要分开解释。混起来讲,团队里就会出现”我验证过可以这样比”这种结论,而验证样本恰好全在区间内。
五、四千三百位的转换上限是一道安全限额
十进制字符串转换有默认上限 4300 位,超过就抛出取值错误,报错原文里带着 Exceeds the limit (4300 digits) for integer string conversion 这句话。它的背景是一项公开的拒绝服务问题:超长整数的十进制转换代价过高,而转换入口往往远程可达,于是”很小的请求换很大的计算”就成了一条现成的杠杆。这道限额是安全设计,不是缺陷。
多数人第一次见到这句报错会以为是内存不够,接着去调内存限制、调容器规格,方向全错,因为瓶颈从来不在容量而在算法代价。正确的处置是三件事:
- 把限额写进配置项,并在对接文档里说明它是安全限额而非问题;报错文本原样透传,不要包装成看不出原因的通用错误。
- 超限场景改用十六进制或字节序列输出。这两条路径不受该上限约束,代价也低得多,适合用于标识、摘要与存储。
- 只有在确实需要长十进制的场合——例如大数校验、人工核对、对账串比对——才用专门的设置函数提高限额,并且用一句注释说明为什么提高、提高多少、由谁批准。
对应到编码规范,还有一条更容易执行的写法:日志与序列化里凡涉及大整数,一律避开十进制字符串化,优先用十六进制或二进制。这一条几乎不增加任何工作量,收益是在一次流量高峰里不被自家日志拖住。
六、容器选型、三处放大与定位顺序
容器侧的对照是:同样存放一百万个整数,普通列表约 26MB,紧凑数值数组约 7MB。判据不是哪个更省,而是这批数据是否只当数值用。只当数值用就上紧凑数组,省下的不只是内存,还有缓存命中率和整批拷贝的成本;需要异构元素、需要灵活结构、需要元素级多态时,仍然用通用容器,这不算退步。
哈希与签名类代码里最常见的三处放大,以及对应改写:
| 放大点 | 为什么贵 | 改写方向 |
|---|---|---|
| 把大整数直接当字典键 | 每次插入与查找都要算哈希,哈希按节走,位数一上去,字典操作就不是常数代价 | 先用固定长度摘要换一个小键,或者改用紧凑数组配索引 |
| 结果反复转十进制再拼串 | 十进制转换本身按位收费,且受转换上限约束,拼串又在循环里放大 | 循环内保持数值形态,只在最后一次转换,或换成十六进制输出 |
| 在循环里做大数乘方 | 乘法超线性,底数与指数同时增长时最坏位数迅速失控 | 先取模把结果压回可控位数,或改为预计算表加查表 |
性能问题定位的顺序也要换一下:先看位数分布,再看调用次数。位数是被低估的那个变量,因为它在源码里不占位置,只在数据里。调用次数看得见,位数分布看不见,于是所有人第一刀都砍在看得见的地方。
测试要补的一条是给边界位数与大数转换写用例:断言耗时落在预期区间内,断言超限的报错被正确捕获并给出可解释的文案。这条用例的价值在于它让第一次遇到几十万字节的输入发生在测试机上,而不是发生在客户的请求里。
对客户交付的启示最后落在限额写法上:纯计算类服务要按”位数与字节数”设限额并给出明确报错,比笼统限制输入长度更贴近真实成本。输入长度是同一把尺子量所有请求,位数才是那个真正决定耗时的量。