
跨库事务在同一个实例上必然撞号:XA 的真实失效形态
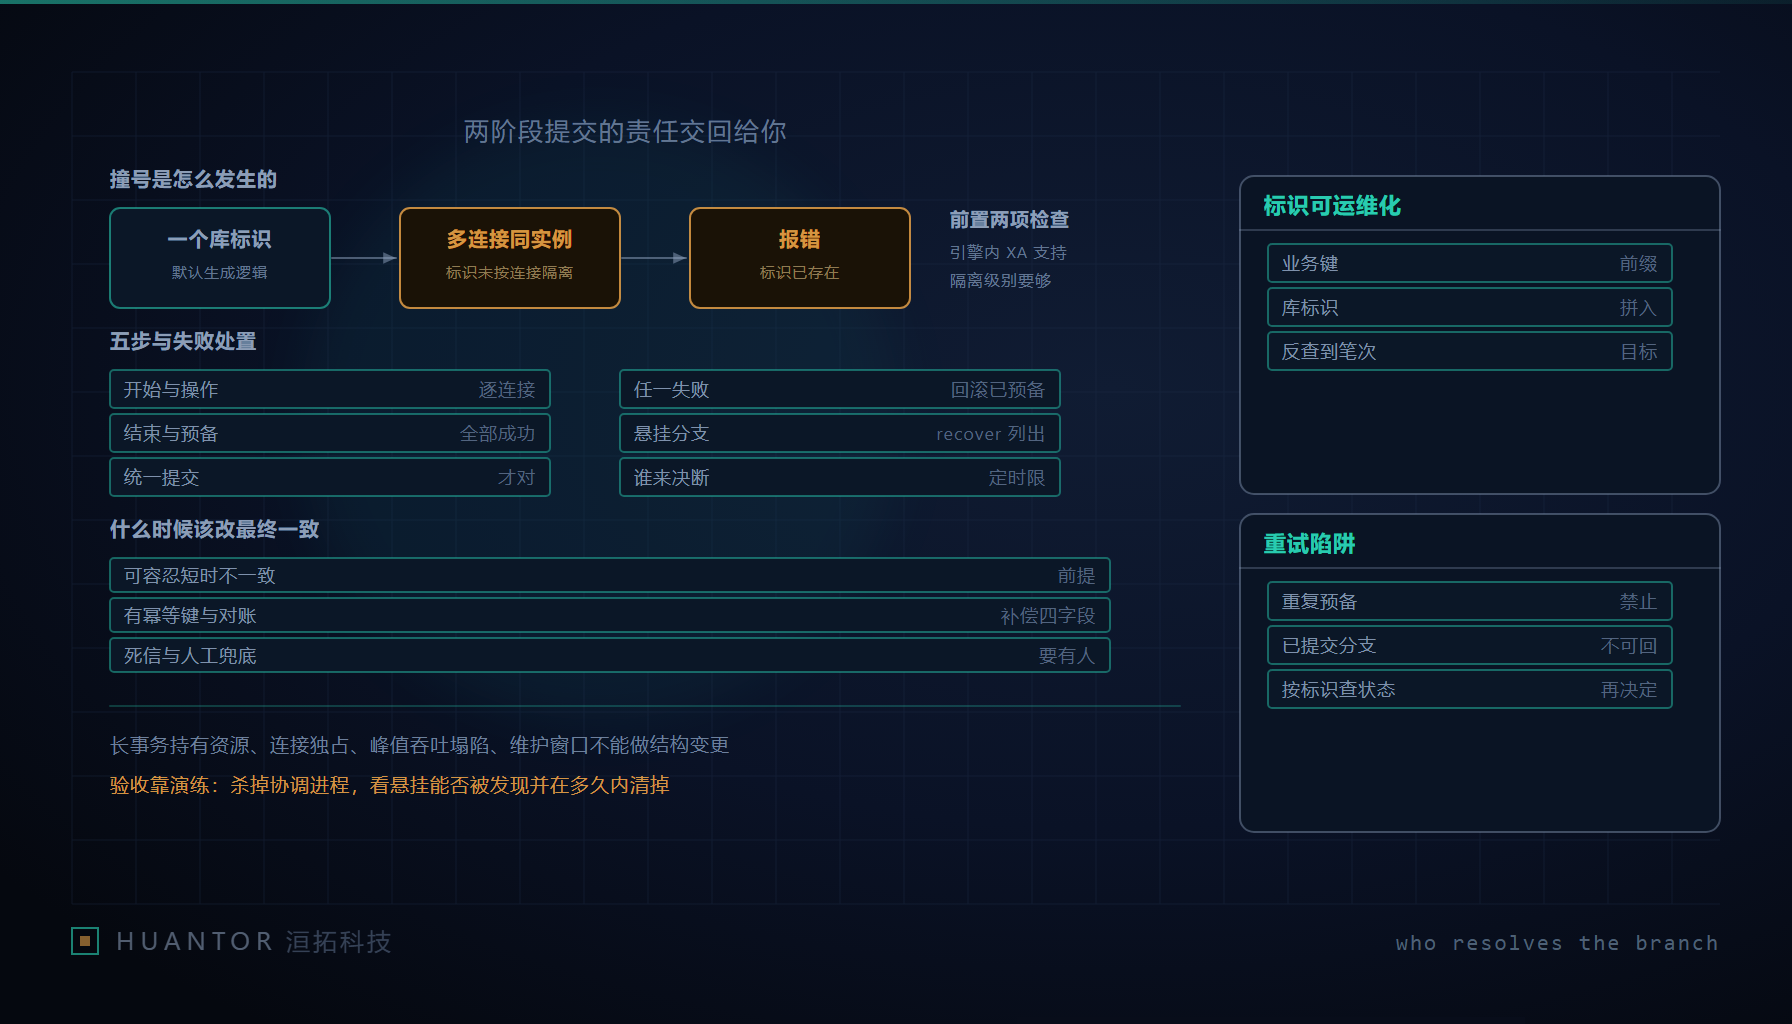
一、同一个实例上为什么必然撞号
该实践记录里记的现象很具体:某个框架版本做多连接事务时,几个连接指向同一个数据库实例,就会返回 XAER_DUPID: The XID already exists。记录里给出的根因是两件事对不上——数据库侧要求事务标识在该实例上全局唯一,而封装层的默认生成逻辑没有按连接去隔离命名空间。我们只转述这个现象,不断言任何框架存在缺陷,也不把它外推到别的版本或者别的实现。
但”同一个实例反而更容易撞号”这件事本身是有通用道理的,值得讲清机制。跨实例时,标识只要在每个实例里不重就行,两个各自随机的短串撞上同一个实例的概率很低;一旦几个分支落在同一个实例上,它们共享同一个唯一性判定域,等价于把”各自不重”变成了”合起来不重”。如果生成器是每连接独立计数、或者按进程启动时间取一段,多个连接又共用同一个生成器实例,那么同一批分支里出现同一个标识就不是运气问题,而是必然。
另一个同源的问题是连接复用。记录里明确要求显式建立独立连接实例、禁止复用同一个连接,这条约束看起来笨,实际是必要的:XA 的状态是挂在连接上的,同一个连接上先后套两层事务,第二层的行为完全取决于实现怎么处理,最常见的结果是看起来成功了,实际只管理了其中一个分支。跨库事务出问题时最难受的地方就在这里——不是报错,是它告诉你成功了。
二、XID 是一个运维字段,不是随机串
撞号之后多数团队的第一反应是”加长随机串”。这能消掉报错,但把事故排查难度往后推了一层:出问题时你手里有一串没有任何含义的字符,没法知道它属于哪笔业务、哪个库、哪个时刻。
该记录的替代做法是给每个库拼专属前缀再生成标识。沿这个思路,我们把 XID 当成一个可反查的运维字段来设计,格式上留四段:
- 业务标识:哪条业务线发起的,能对应到服务名或者任务类型。
- 库标识:分支落在哪个库,同一实例多库时靠这一段区分命名空间。
- 时间或序列:用于把悬挂分支按发生顺序排出来,也是判断”该不该清理”的依据。
- 幂等键:与业务单据绑定,重试时标识可以重算,不会凭空多出分支。
这四段不是为了好看。实例上会看到一批处于 prepared 状态的分支,运维唯一的线索就是这串标识;能读出业务、库和时间,才谈得上决断。设计上有一条底线:不要把它做成需要查表才能解释的形式,悬挂发生时那张表可能正是不可用的那个东西。
三、上线前的四项检查与为什么常被跳过
该记录列出两条前置条件:一项是引擎侧的 XA 支持开关 innodb_support_xa 必须为开启;另一项是事务隔离级别需要为 SERIALIZABLE,记录里说明其他级别下 XA 可能被忽略或者行为异常。这两条按来源转述,不去推断其他级别下的具体表现。加上连接与标识两条,凑成我们上线前要跑的四项检查。
| 检查项 | 看什么 | 跳过之后的真实表现 |
|---|---|---|
| 引擎侧 XA 支持开关 | 每个参与实例的运行时值,不是配置文件里的期望值 | 不报错,但事务分支没有真正进入两阶段流程 |
| 隔离级别 | 每个连接实际生效的级别,含会话级覆盖 | 部分语句不被 XA 管理,提交顺序和预期不一致 |
| 标识命名空间 | 同实例多分支时前缀是否按库隔离、生成器是否共用 | 高并发时随机出现标识重复报错 |
| 连接独立性 | 每个分支是否独占一条物理连接、有没有复用 | 分支状态串在一个连接上,回滚只回掉一半 |
为什么这四项总是被跳过?因为前三项在开发机上都能”跑通”。单机单连接、低并发、只有一个库的场景里,开关关着也不报错,隔离级别不对也不报错,标识短到两位也不会撞。检查项的价值只在真实拓扑上出现,所以它必须写成部署脚本里的一次断言,而不是文档里的一段提醒。我们吃过这个亏:同一份代码在预发跑了很久没问题,上到有多库同实例的生产环境第一天就开始报标识重复,差别只在拓扑,不在代码。
四、prepared 悬挂:谁在什么时候补 COMMIT 或 ROLLBACK
该记录给出的手工流程是:逐连接执行 BEGIN、操作、END、PREPARE,全部 PREPARE 成功后统一 COMMIT,任一失败则对已经 PREPARE 的连接执行 ROLLBACK。这套顺序本身没有秘密,秘密在它没写完的那一半——如果”统一 COMMIT”那一步没跑完,进程就死了呢。
这就是 XA 最容易被低估的一点:两阶段提交的责任并没有被封装掉,它只是换了位置。分支进入 prepared 状态后,它已经准备好了,但既不算提交也不算回滚,会一直占着资源等一个决定。三种情况会造出悬挂:协调者进程崩溃或发布时被杀掉;PREPARE 到 COMMIT 之间超时;网络分区导致部分分支收不到最终指令。
处置规则要在上线前写成文字,不能留给现场判断:
- 谁负责发现。定时任务在实例上执行 recover,把处于 prepared 的分支列出来,写入告警而不是只写日志。
- 谁负责决断。只允许一个协调者决断,其他进程不许碰,否则会出现两边对同一批分支做出相反决定。
- 多久之内决断。给一个明确时限,超时后按预定义的保守方向处理,并在文档里写清这个方向是提交还是回滚以及依据什么判定。
- 依据什么判定。看业务侧的幂等键与状态表,而不是看分支本身——分支只知道”准备好了”,它不知道业务是否已经算完成。
- 决断动作要可重放。补 COMMIT 与补 ROLLBACK 都要能被重复执行而不产生第二次副作用。
悬挂分支最坏的地方不是不一致,而是它把不一致冻住了:那些行被一个不存在的事务锁着,读它的人等待,写它的人超时,故障表现看起来像锁竞争,没人会去查一个”已经报成功”的事务。
五、超时与重试的两个陷阱,以及必须承认的代价
第一个陷阱是重试时把同一个标识再 PREPARE 一次。多数实现下这是非法的,分支已经在那里了;正确做法是重试用同一标识去查状态并补决断,而不是重放整个流程。标识里那段时间或序列段,就是为了让这两种情况能区分开。
第二个陷阱更硬:部分分支已经 COMMIT,剩下的没法回滚。这时”要么全成要么全不成”的直觉是错的,两阶段提交保证的是分支之间不出现”有的提交了有的被回滚了却没记录”,它不保证你可以在任意时刻把已提交的那半收回来。所以超时策略里必须有一条:COMMIT 阶段的失败只允许重试与补决断,永远不允许转成 ROLLBACK。
代价也要按记录与实践如实写下来,别只看它的语法有多干净。长事务会长时间持有资源,隔离级别拉到 SERIALIZABLE 之后可冲突的范围更大;每个分支独占一条连接,并发上去以后连接池先塌;峰值时段吞吐掉下来的通常不是计算,是等待。维护窗口里的结构变更要和 XA 事务错开,实例上挂着 prepared 分支时做变更,风险不由你控制。这些是定性判断,我们不在这里给未实测的数字对比。
六、什么时候该换最终一致,以及补偿表要留什么
在洹拓接手的系统里,多数跨库写入其实不需要强一致,需要的是”能被对账、能被补”。该记录也直接给出替代路线:本地事务表加消息队列加补偿。判据我们列四条,四条同时成立才考虑换:业务能容忍短时间不一致;每个动作有幂等键;有对账手段能发现中间态;失败后有明确的补偿动作,并且补偿本身也可能失败,要有死信处理与人工入口。
| 维度 | 适合 XA | 适合最终一致 |
|---|---|---|
| 不一致的容忍度 | 不能出现哪怕很短的中间态可见 | 可容忍秒级到分钟级,界面上有”处理中”表达 |
| 参与方数量 | 少数几个自有库 | 跨服务、跨外部系统,参与方会增删 |
| 失败后的动作 | 回滚即结束 | 需要业务补偿,补偿逻辑本身要设计 |
| 峰值压力 | 低到中等并发 | 高并发,不能接受连接与资源独占 |
| 排障手段 | 能从实例上的分支状态反查 | 必须能从状态表反查每一步 |
换成最终一致之后,核心交付物变成一张本地事务表,四个字段不能省:业务键、状态、已执行步骤、下一次动作。业务键用于幂等与对账;状态是有限枚举,不许用布尔凑;已执行步骤要能回答”走到哪一步了”,否则补偿逻辑只能从头再来;下一次动作是给重试任务读的指令,不是给人读的备注。这四个字段齐了,重试才有依据,缺任何一个,补偿都会退化成”再试一次完整流程”。
验收要做三件事,都是主动制造故障:拔掉了其中一个连接制造失败,看剩下分支是否被正确回滚且没有悬挂;杀掉协调进程,看 recover 能不能发现悬挂并在规定时限内被决断;双实例同表并发跑一轮,确认标识重复不再出现且隔离级别与开关检查真的能拦住配置漂移。这三件事跑完并留档,才算这个方案上线。
最后一条纪律:跨库事务的复杂度不在语句里,在”谁负责补最后一步”上。这句话写进设计文档比多写一段流程说明有用。