
把内存堆到处理器头顶:vHBM 真正的门槛是热,不是带宽
一、内存墙卡在哪一段:路径上每一跳都在收费
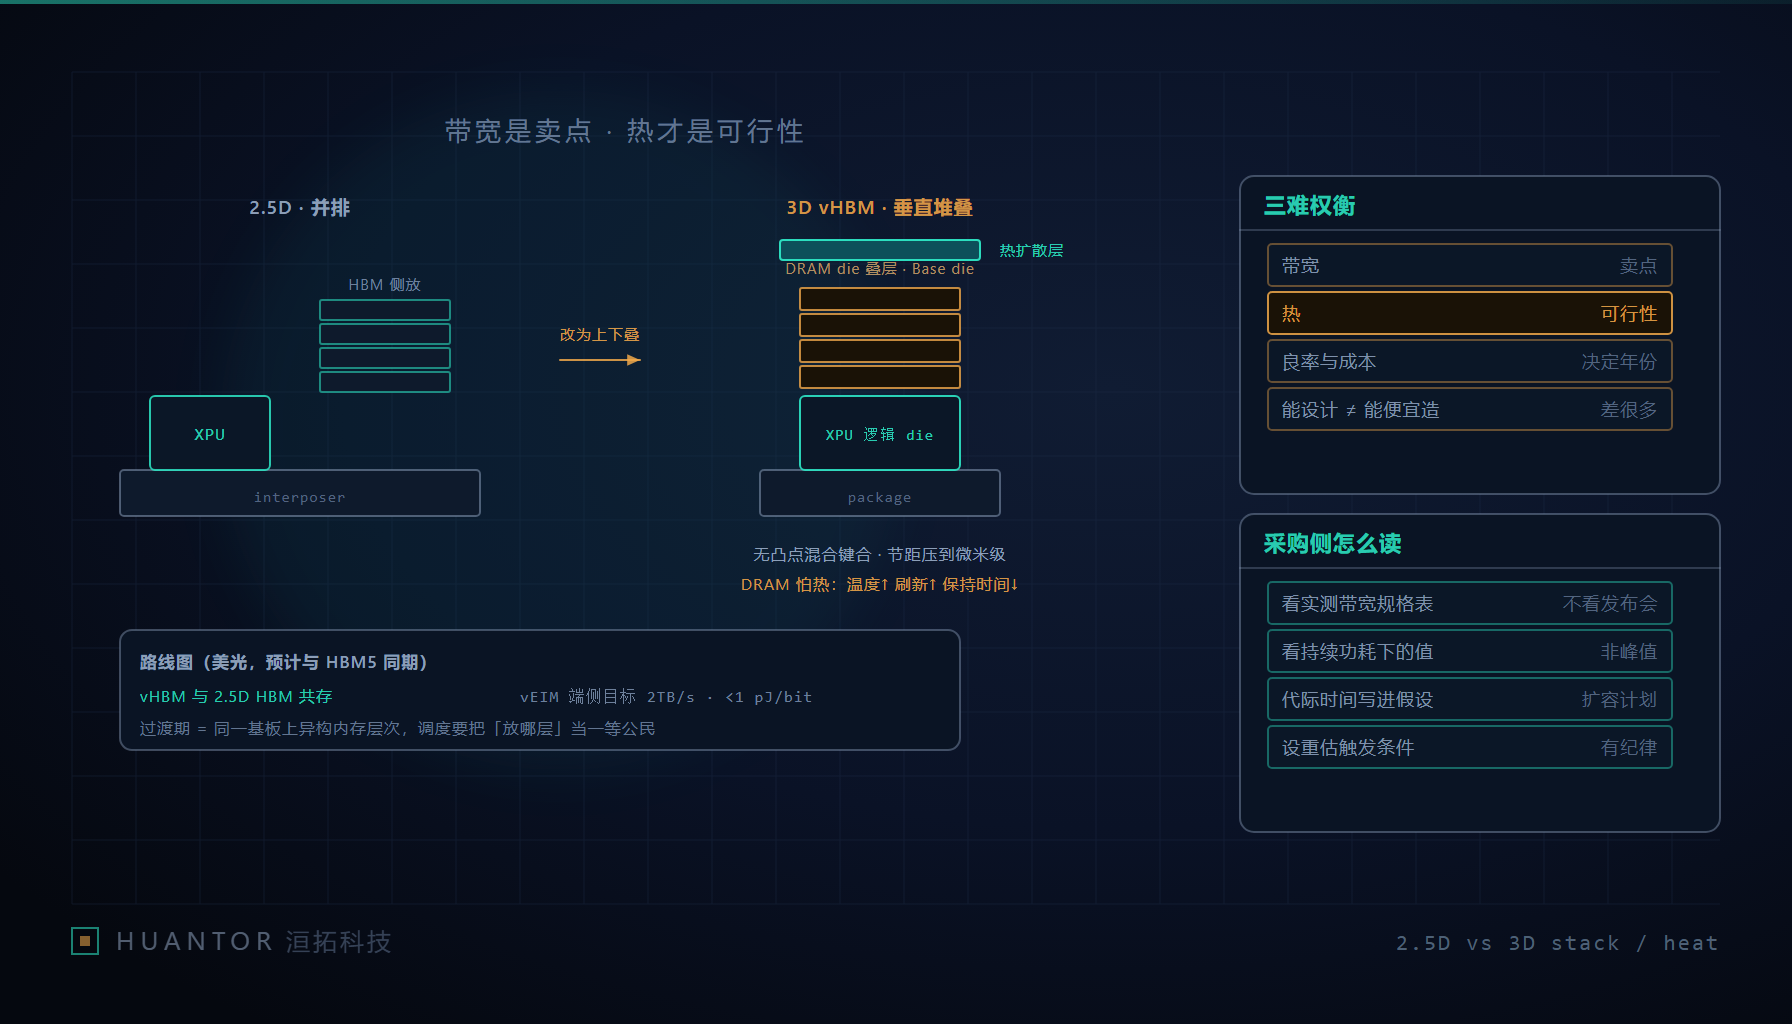
据公开报道,美光在年度技术网络研讨会(当地时间 10 月 21 日召开,10 月 22 日见诸报道)上给出 vHBM 与 vEIM 两条路线:vHBM 是 HBM 的 3D 集成版本,把 DRAM Die、Base Die 与 XPU 逻辑主芯片垂直堆叠,用来缩短数据通信路径、提升带宽效率并降低能耗;配套手段是无凸块的混合键合与集成散热方案;两类新型 3DS 内存预计与标准 HBM5 在 2028 年同期到来。这些全部是美光给出的路线图与目标值,不是已经量产的产品,下面所有讨论都按这个前提展开。
要看这件事改了哪一段账,得先把”内存墙”落到具体路径上。大模型推理的耗时并不主要花在算,而花在把权重和 KV 缓存搬到计算单元跟前。数据从片外 DRAM 走到计算逻辑,要依次穿过 PCB 走线、封装基板、硅中介层,最后才进逻辑裸片。每一跳都要多一份寄生电容要驱动、多一份互连损耗要补偿——驱动容性负载这件事是按比特收费的,走的距离越长、拐的接口越多,单个比特摊到的能量就越多。
2.5D 封装(HBM 与 GPU 并排放在中介层上)已经把这段距离压得很短,这是它相对”内存插在主板远处”的核心收益。但 2.5D 仍然是横着走:信号从 DRAM 阵列出来,穿过 Base Die,在中介层里横向跑一段,才进主芯片。vHBM 做的事是把”并排”改成”上下叠”,缩掉的正是最后那一段横向距离——Base Die 直接压在 XPU 逻辑主芯片头顶,DRAM 堆就立在上面。
省下的路径不是免费的。同一件事的另一面是:被缩掉的那段距离,原本是热量最容易被分开处理的距离。
二、带宽是卖点,热才是可行性
先说省下的那份能量去哪了。 单位比特互连能耗下降,意味着同样算力下搬运部分占的功耗变小,账面看整颗芯片的热负担该减轻。这个推理错在只看了平均功率密度,没看它的分布。
DRAM 比逻辑电路怕热得多,而且是原理层面怕。 DRAM 的存储单元是一只电容加一个晶体管,数据存在电容的电荷上,电荷一直在漏,所以必须周期性地把每一行读出来、放大、再写回去,这就是刷新。漏电速率与器件失效速率都随温度按指数关系上升,半导体可靠性里那条常用的经验规律(结温每上一个台阶,失效速率明显抬升)说的就是这件事。温度上去之后,三件事同时发生:
- 刷新必须更频繁。 刷新期间行被激活、感测放大器工作、总线被占用,这些时间不能用来读写字节——温度升高会直接吃掉有效带宽,而且是吃掉你宣传的那个数。
- 数据保持时间下降。 同样的刷新间隔下丢位的概率上升,超出保持时间就是不可恢复的数据错误。
- 错误率上升,纠错与巡检的开销随之上升。 ECC、巡检刷新、行干扰管理都要抢时间片,进一步压低可用带宽。
而堆叠之后,DRAM 面对的是整块基板上最热的位置:功耗密度最高的计算单元就在它正下方,热量还得往下穿过键合界面才能出去。于是”散热”从封装环节的问题,升级为决定可用容量与可靠性的问题——温度上限决定你能同时点亮多少层、能容忍多高的刷新占空比、能在同一封装里放多大容量。热不够用,容量和带宽都只能按比例缩水。
这也解释了路线图里那几条支撑技术为什么会长成那样:PHY(接口物理层)位于堆叠底部、正对主芯片,是单位面积翻转最多的地方,把热扩散层压在 PHY 上方,说明设计者按热点分布做热规划而不是按整片平均值;前/背面创新意味着热路径不只从底部走;热感知设计这一条更直白——温度被当成设计约束,而不是出事之后的保护动作。我们的结论一句话:带宽是卖点,热是可行性。
| 美光路线图条目 | 主要回应带宽还是热 | 从条目本身能读出的信息 | 落地仍缺的验证 |
|---|---|---|---|
| TSV 与 µbump 微缩 | 带宽 | 垂直互连密度是堆叠的前提 | 微缩后的缺陷率与测试覆盖能力 |
| 16H µbump 与混合堆叠 | 带宽与容量 | 堆叠层数继续加大,键合方式混用 | 层数越多,单点缺陷影响整摞 |
| PHY 上方的热扩散层 | 热 | PHY 被明确列为热点来处理 | 加扩散层后还剩多少结温余量 |
| 混合铜键合带来带宽与热改善 | 两者 | 去凸点同时降电阻与热阻 | 平坦度、洁净度、不可返修带来的良率 |
| 前/背面创新 | 热与集成 | 热路径不只从底部走 | 具体结构与厚度未公开 |
| 2.5D HBM + 3D vHBM 集成 | 容量与带宽 | 官方明确共存,不是替代 | 两类区域的调度与规格口径 |
| 热感知设计 | 热 | 温度作为一等约束进入设计 | 降额行为是否对用户可见 |
三、混合键合换来了节距,也换走了返修的可能
它解决的是什么。 微凸点同时卡着两件东西:互节距(pitch)与 I/O 密度——凸点要有体积,节距就不能无限缩小;凸点本身还有电阻与热阻,串联在信号路径和热路径上。无凸点的铜-铜混合键合把节距压到微米级,同样的键合面积能放更多通道,于是带宽上升而互连能耗下降。注意这条收益是双份的:更低的串联电阻意味着更少的焦耳热,更短的路径意味着更小的驱动负载。 路线图把”混合铜键合”同时记在带宽与热两栏,逻辑就在这里。
它的代价必须一起写。 铜面直接键合,对表面平坦度与颗粒洁净度极端敏感;一旦叠好,缺陷不能像凸点那样逐颗重做,只能整摞报废;堆叠层数越多,良率越是逐层相乘而不是相加——单颗裸片合格与整摞合格是两个数量级的难度。加上键合与减薄环节的产线投入,成本曲线现在没人能给出口径。所以我们看这类路线时会把两个问题严格分开:能设计出来和能便宜地大规模造出来,历来不是同一年。2028 是美光给出的预计时间点,不是已经跑起来的产线节拍。
对采购方,这个区分有直接含义,洹拓科技在扩容评审里把它固定成一条问法:路线图上的年份决定的是”什么时候开始重新询价”,而不是”什么时候能买到”。
四、与 2.5D 共存意味着什么:选型要重读的三段
路线图本身说了共存,而且专门列了 2.5D HBM + 3D vHBM 集成这一项。它的实际含义不是”新旧两代产品并行卖”,而是过渡期会出现异构内存层次:同一块基板上,既有侧放的 HBM,也有叠在计算芯片上方的 vHBM。这两类区域的可达带宽、容量上限、温度预算和错误率都不会相同。
这样一来,”哪块数据放哪一层”就从实现细节上升为体系结构问题。它要求规格表不再只写一个总容量,而要按区域描述带宽与容量;也让未来几年 GPU 实例的规格口径与厂商定价方式跟着变——单卡”显存容量”这一个数字,可能不再足够定义一张卡能装下多大的模型状态。
洹拓科技给客户的一句话建议是:不要因为新封装出现就重做预算。要动的是假设,不是数字。具体我们按三步走:
- 只认已交付的规格表。 看实际出货产品的显存带宽、容量与单卡价格,路线图上的目标值不进任何采购模型。
- 把代际时间点写进扩容假设。 未来 2 到 3 年的扩容计划里,”下一代显存/内存代际”作为一条显式假设存在,并给它配上触发条件:厂商公布量产节点、首批实例上线、或者同一代产品报价出现明显波动。
- 提前定义重新评估的动作。 假设变化时不是”再等等看”,而是走一次完整的重询价:把新代际的每带宽单价与旧代际剩余租期放在一起比,避免在价格波动最大的窗口只做单边决策。
五、vEIM 这条端侧线更值得盯,盯功耗包而不是峰值带宽
vEIM 的结构与 vHBM 类似,瞄准端侧 AI 推理,美光给出的初代产品目标是 2TB/s 带宽、能效低于 1 pJ/bit。这条线在讨论度上不如数据中心,但在工程约束上更硬。
端侧的瓶颈不是算力,是功耗包与散热体积。 手机与便携设备不可能为单颗芯片留出独立散热结构,整机外壳还要守着人能长期握持的接触温度;封装里多让出一层散热结构,就意味着电池要少让出一部分体积。在这类设备里,热不是”性能上限”的问题,而是”这个产品能不能被拿在手里”的问题。同一个 DRAM 温度敏感问题在端侧更严重:设备的散热余量随使用场景剧烈变化(握持、放进包里、边充边用),而堆叠的内存必须在这种波动里守住刷新与保持时间。
如果目标值达成,改变的到底是什么? 是”本地能跑多大的模型上下文”——权重与 KV 缓存的搬运不再是第一道限制,长上下文、多轮会话状态、常驻的多模态特征才有可能在电池供电的设备上站住。它不等于端侧算力追平云端:算不算得动是另一笔账,宣传里常把这两件事混着说。
官方路线图里那句”Token 效率随带宽、能效、容量而变”其实是最好用的评估口径:三个量互相约束,只报其中一个的都属于不完整信息。所以我们看端侧这类内存只盯三件事:在什么封装体积下达成、在什么持续功耗下达成、温度抬高后按什么规则降额。峰值带宽排在它们后面。
六、我们的判断
回到买云上算力的人真正要处理的两个问题。第一,先进封装产能处在爬坡期,供应方只有少数几家,内存代际切换通常是采购价格波动最大的窗口——不是新技术出现的时候贵,是新代际刚落地、旧代际还没退干净的那段时间最难定价。第二,代际这件事会改变规格口径(按区域写带宽),而口径变化最容易出现”同名不同物”的报价。我们的做法是把这两条都当成不确定性来管理,而不是当成战斗力来规划:假设写清楚、触发条件写清楚、重询价动作写清楚。
这类路线图新闻真正的信息量,不在”带宽又要翻一倍”,而在它承认了热是主矛盾。凡是把热列进设计目标的路线——热扩散层压在 PHY 上、前/背面同时做文章、把热感知写进设计流程——通常离落地更近,因为它在算可行性的账;只报带宽数字、对温度与降额一字不提的路线,不一定。我们不会因为这条路线图调整任何现有采购计划;会让我们在下一轮扩容评审里加一页的,是”美光把热当成设计输入”这件事本身。