
6 美分一个星标、两周订单当全年收入:四个指标各自的正确读法
一、先给一条判据,再逐个看四个指标
有报道描述过这样两个数:6 美分一个的 GitHub 星标,以及把两周订单说成全年经常性收入。我们不谈这件事的道德评价,它对我们只有一层意义——这类做法能被反复使用,靠的不是某个平台的漏洞,而是被广泛使用的几个指标,验证成本远低于它们宣称的价值。
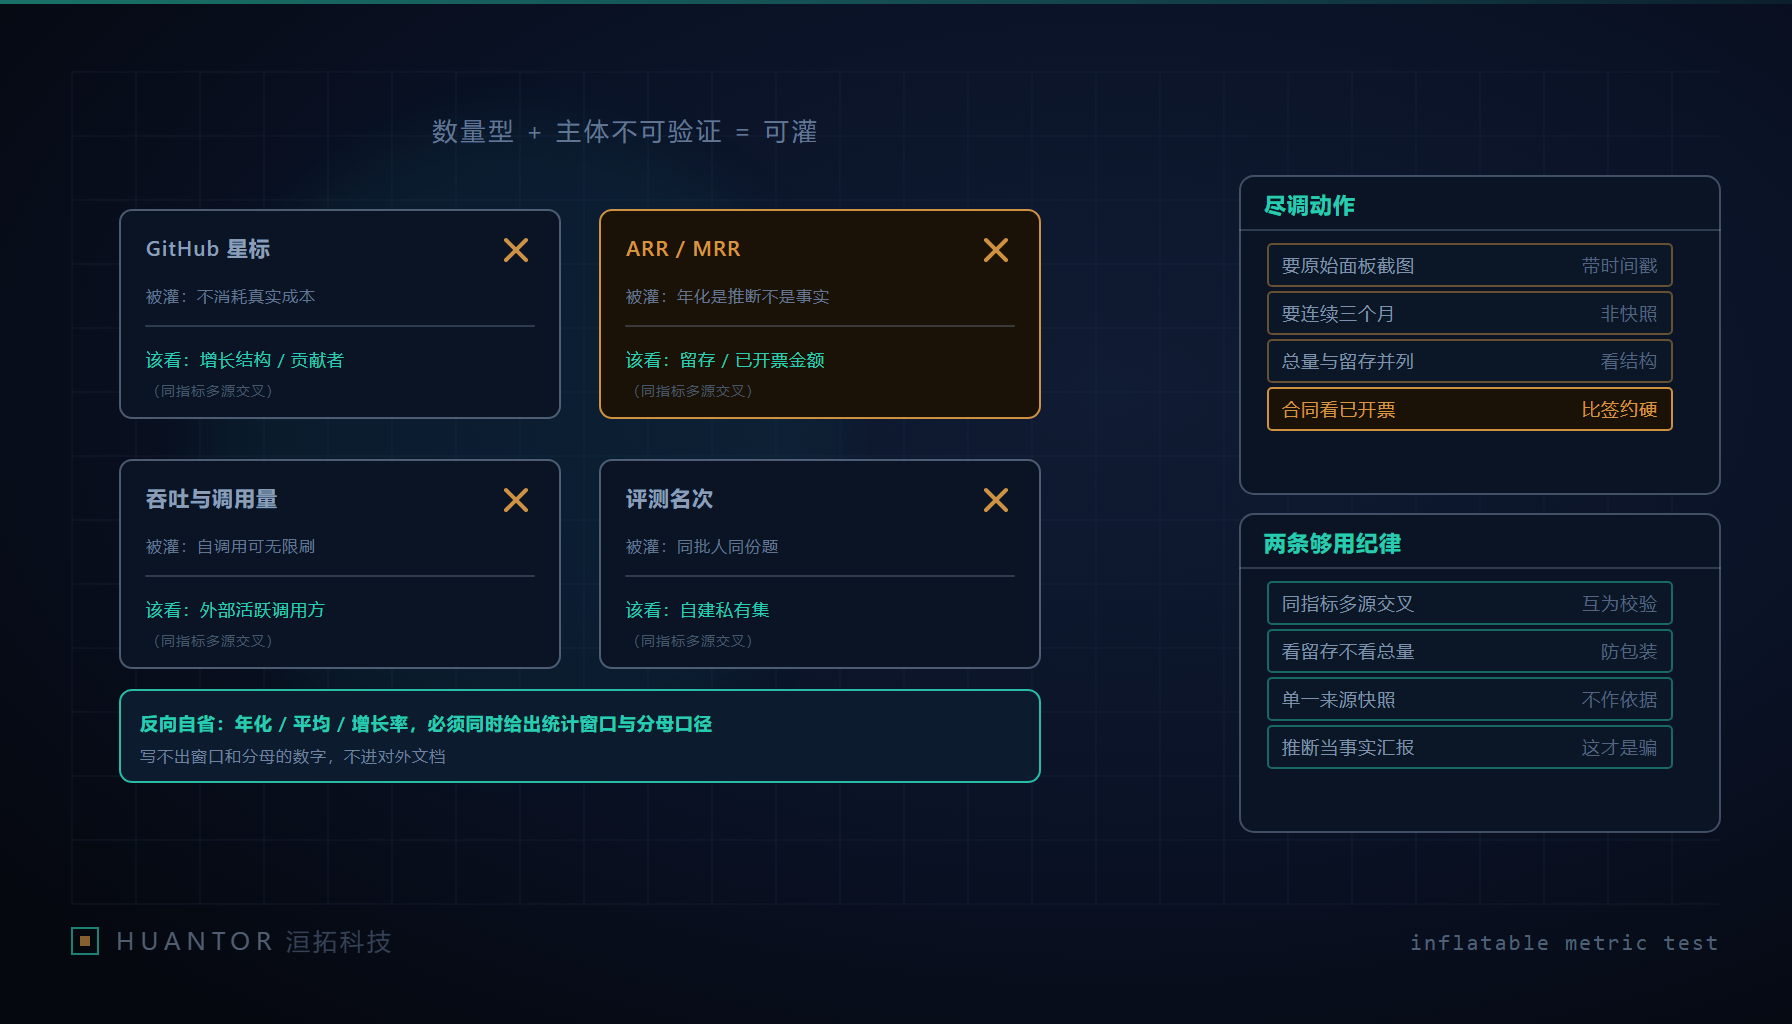
要判断一个指标能不能被灌,不需要一份清单,需要一条判据:凡是”数量型 + 采集方无法验证主体真实性”的指标,都可灌。 两个条件缺一不可,合起来就是机会。
- 数量型。 指标是一个计数,或由计数派生的比率:星标数、请求数、Token 数、榜单名次。它不是一笔已经履行的付款,不是发票,不是可核验的合同。数量的增长不需要说服任何人,只需要累加。
- 主体真实性无法被采集方验证。 报数的人和核数的人不是同一方,而分子背后那些主体(账号、客户、调用方)的存在与意愿,不需要任何外部系统确认。这条一旦成立,分子就变成报数方单方面可以造出来的东西。
按这条判据把四个指标排一遍,能灌的位置和替代问法就都出来了:
| 指标 | 可灌的机制 | 可交叉验证的旁证 | 我们真正会去看的字段 |
|---|---|---|---|
| GitHub 星标 | 星标不产生交易、不消耗真实成本,造假成本约等于注册成本;同一主体可以复制出多个账号 | fork 之后有没有后续提交、提过有意义 issue 的人数、issue 与回复的语言多样性 | 增长的时间分布形态,以及贡献者名单 |
| ARR / MRR | 年化本身是推断;一次性收入乘十二、极短窗口数据年化、意向或框架合同计入分子 | 已开票金额、银行流水口径、同一批客户的第二年状态 | 留存与复购,退款与降配有没有从分子里扣掉 |
| 吞吐量 / 调用量 | 自调用可以无限重复,内部脚本与真实外部用户在总量里不可区分 | 独立调用方标识、去重后的终端数、单账号使用时长分布 | 外部活跃调用方数量,以及时长分布有没有长尾 |
| 评测分数 / 榜单名次 | 题目、评委、提交方三者的独立性不成立时,分数只是排队的副产品 | 是否公开题目与判分细则、有没有第三方复现 | 名次旁边的分差与评测集构成 |
这四行的用法不是”看懂了就算完”,而是每一条都能变成一个可以要求对方回答的问题。下面逐个说。
二、星标:总量不含信息,结构才有
星标的问题在于它同时满足两个条件:是个纯计数,而且标星的主体对任何人都不可证明。站内《star 曲线不该出现在选型评分表里》已经把”该不该把它放进评分表”这件事处理过了,本篇不复述那个结论,只把机制说清:一个仓库的星标总量,是营销投放、榜单曝光和账号侧异常三件事的合力,没有任何一项需要在代码里留下痕迹。
于是唯一可用的读法是把总量换成结构,问四个可以核实的问题:
- 增长在时间上是什么形状。 自然传播的曲线带抖动——一次分享、一篇外部文章都会形成一个可以追问来源的凸起;异常增长是不自然的窄峰,涨得极快、落得极平,而且解释不了触发点是什么。
- fork 之后有没有后续提交。 fork 是”想用它”,星标是”路过点一下”。只有 fork 没有提交的形态,说明看的人多、用的人少。
- 有没有作者之外的技术讨论。 提过有意义 issue 的人数、回复的语言多样性、讨论里出现的是使用细节还是”good project”,这三件事比总量可靠得多。
- 贡献者名单长什么样。 一段时间内集中出现又集中消失的贡献者,和这个项目的时间线能不能对上。
这四个问题的共同点是:它们都在要求跨系统的一致性。造假一个数字便宜,造假一堆数字互相咬合的代价高得多。这也是我们评估开源依赖时的默认动作——跑一次真实构建,看提交记录,不看首页那句”被多少项目在用”。
三、ARR:年化是推断,不是事实
经常性收入这个词被误用得最彻底,因为**年化的意思是”把没发生的事外推成会发生的事”**。这类做法有三常见写法,值得单独认出来:
- 一次性收入直接乘十二。 一笔只买一个月的钱被报成一年的收入。这个数和”公司一年实际收到多少钱”之间没有任何关系。
- 极短窗口的数据年化。 这就是报道里说的两周订单当全年收入——签了两周,报一个全年数。它的隐藏假设是”后面每一周都签得一样好”,而这个假设恰恰是需要被证明的那件事。
- 意向合同、框架合同计入分子。 双方互相签一份没有履约义务的意向书,在报表里就成了收入。这类合同没有任何一方需要掏钱,所以它能被无限复制。
对应的替代问法,我们只问三条,且要求书面回答:
- 这是经常性收入还是合同总额摊销?两者的分母完全不同,前者要求服务在持续供给,后者只是把一笔钱摊久一点。
- 留存是多少——同一批客户第二年还在不在?新签只能说明销售动作,留存才说明产品有没有把价值留下。这一条比总量更能识别质量。
- 退款、降配、免费试点有没有从分子里扣掉?只要有一项没扣,这个数的口径就和别人报的数不可比。
四、吞吐量和评测分数:另外两种口径松动
调用量类指标(请求数、Token 消耗量、生成条数)看起来比星标硬,因为它有真实的系统开销。但它的可灌性来自同一条判据:总量不区分来源。自己写脚本反复调用同一个接口,与大量真实终端各自用一次,在报表上是同一个数。可追问的替代项是三件事:外部活跃调用方的数量、按终端去重之后的规模、单个来源的使用时长分布——真实使用一定有长尾,人造的量往往整齐。
评测分数与榜单名次是第四种口径松动。 这一条站内已经写过两次(数据污染与私有评测集),这里只补一句机制:榜单是同一批人、在同一份题上、用同一套判分做的比较。它能回答”在这份题上谁更高”,回答不了”在你要解决的问题上谁更合适”。题目一旦公开且被反复刷,名次反映的就不再是能力,而是对那份题的拟合程度。
五、尽调时真正会做的六个动作
上面都是读法,这一节是动作。这六条是洹拓科技写进供应商评估与项目准入的固定项,每一条都要求对方给出可核验的东西,不接受口头答复:
- 要原始面板,不要导出的图。 带时间戳与账号名的后台界面截图,和一张贴进幻灯片的柱状图,可信度差一个量级:前者可核对账号与日期,后者什么都可以改。
- 要同一指标的连续三个月,而不是一次快照。 单次快照挑得出最好看的那个月;连续三个月能看出季节性、也能看出有没有在某个时点被人为抬高。
- 总量与留存并列看。 只看增长会把”签得多流失也快”读成”增长快”。两个数必须同时给,缺一个就要求补。
- 开源项目跑一次真实构建,并看近 90 天的提交人列表。 构建能不能成、装依赖时会不会撞版本,这些是任何宣传语替代不了的信息。
- 合同类指标要求给出已开票金额。 开票比签约硬,比意向书硬得多:它意味着税务与财务两侧都留下了同一笔记录,伪造的代价不再是注册成本那个量级。
- 要一个可复现的演示,而不是录屏。 现场给输入、现场出结果、失败当场重跑。这条同时适用于生成类工具和数据类看板。
第 5 条和第 1 条是性价比最高的两项:一个把财务侧的造假成本抬上去,一个把展示侧的口径钉死。
六、先照自己,再谈别人
这类报道对我们更实际的价值不是”防供应商”,是把同一把尺子放到自己身上。我们对外材料里出现过的每一个数字,按这条判据问一遍:这是事实还是推断。年化、平均、增长率这三类表述最容易被写成推断却读起来像事实——只说”环比上涨”而不给统计窗口与分母口径的增长率,就是一个修辞。洹拓科技内部因此有一条硬规矩:任何年化、平均、增长率,必须同时给出统计窗口与分母口径,否则不进对外文档;给不出口径的,改写或者删掉。这条规矩同样约束我们自己的经营数据表述,宁可数字少、难看一点。
内容业务的指标是同一面镜子。做 GEO 与内容运营时,流量类指标也满足”数量型 + 主体不可验证”,所以拿第三方统计工具的第一个问题不是”这个数是多少”,而是它统计的到底是什么:PV 按请求计,UV 按设备或标识去重,两者混着报会得出完全相反的增长结论;爬虫和自动化访问如果不做剔除,会一并落进 PV 里。我们自己站点的看板把这两项分列,就是为了避免被自家数字骗。
最后把结论说直白:指标本身不是骗局,把推断当事实汇报才是。 我们评估供应商或内部项目时用的方法简单到没什么替代价值——同一指标找多个独立来源交叉,看留存而不是看总量。它便宜,但要求核数的一方愿意多花时间,而多数决策失误恰恰省掉的就是这点时间。反过来,如果一份材料里所有数字都给了窗口和口径、并愿意提供连续三个月的原始面板,这类供应商值得进入下一轮,不管它的绝对值好不好看。