
顺手用 shelve 存状态,第二个进程打开就开始报 locked file
一、shelve 的”顺手”来自哪里,代价藏在哪里
shelve 提供的东西很朴素:一个看起来像字典的对象,赋值就落盘,取值就还原。
import shelve |
三行代码,不用建表、不用连接串、不用驱动,值还是任意可 pickle 的 Python 对象。在单机、单进程、低频写的小工具里——比如 CLI 脚本存配置、单机批处理存中间结果——这个成本确实没人愿意换成别的。
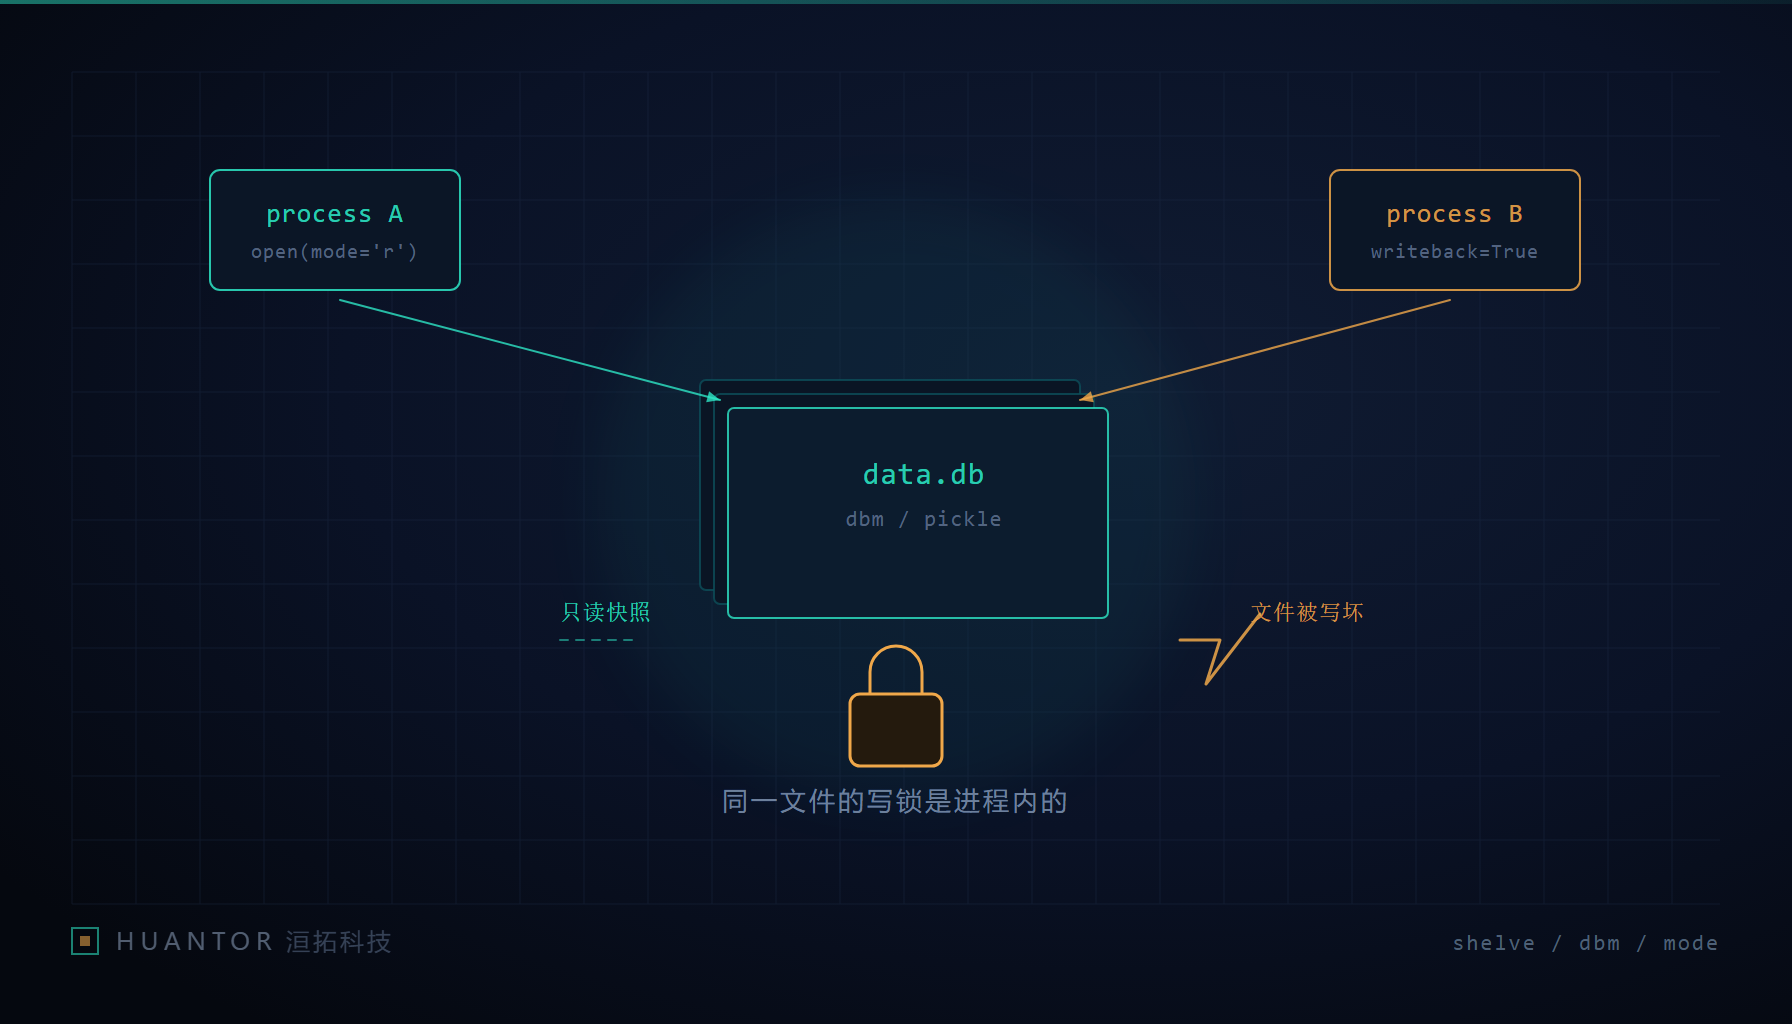
问题在于它的”轻”是套壳:shelve 下面是 pickle 加 dbm,而 dbm 又落在具体后端上,常见的是 dbm.gnu、dbm.ndbm、dbm.dumb,装的是哪个由平台和编译环境决定。这一串套壳带来三个后果,全部集中在并发上:锁由底层 dbm 施加,不是 shelve 自己的语义;值必须能被 pickle,跨版本、改类名都可能读不出来;以及最关键的——它的定位从来不是多进程数据库,官方文档对这类用法是有明确保留态度的。所以我们内部把它归到”进程内工具”,而不是”存储层组件”。
二、四个 flag 与一把别人家的锁
shelve.open() 的模式靠 flag 指定,默认是 'c'。四个取值的差别不只是”能不能写”:
| flag | 语义 | 文件不存在时 | 锁的角度看 |
|---|---|---|---|
'r' |
只读,禁止任何写操作 | 直接报错 | 不参与写锁,读者之间不互相阻塞 |
'c' |
读写,缺文件就创建(默认值) | 新建 | 要拿到写能力,会与别的写者争锁 |
'w' |
读写,文件必须已存在 | 报错 | 同上 |
'n' |
新建并清空同名旧库 | 新建 | 破坏性最强,多进程下等于抢着删数据 |
最容易踩的是 'c' 是默认值这件事。一个纯读的巡检脚本,写代码的人只调 db.get('config', {}),看起来一个字节都没改,但只要用了默认的 flag='c',底层就会去申请带写能力的句柄;同机上另一个任务也在写,两个申请撞在一起,就出锁竞争。把这类脚本显式改成 flag='r',是社区里最常被提到的第一条修法——只读打开不申请写锁,锁冲突的来源直接消失。
配套的语义还有几条:
- 一个
shelve对象对应一个打开的 dbm 句柄。必须显式close()或用with,靠垃圾回收来关,锁释放的时机是不可预期的。 - 只读句柄上调
db[k] = v,抛的是 dbm 层的错误,不会静默失败。 protocol不传时走 pickle 的默认协议;默认协议号随 Python 版本变,跨大版本读写同一个库要留意。
需要强调一句:上面这些是 shelve 与 dbm 的标准语义,但”锁到底怎么加、加多久、'r' 在什么条件下还会报错”这三点,取决于你实际用到的后端。dbm.gnu、dbm.ndbm 和纯 Python 的 dbm.dumb 行为并不一致。同一份代码在 Linux 的 gdbm 上正常、换到只有 dbm.dumb 的环境上表现完全不同,这种事不要照别人的结论直接用,先在自己的 Python 版本和后端上实测。
三、两种报错形态,指向的其实是同一件事
真出错时,一般见到这两种:
OSError: [Errno 11] Resource temporarily unavailable |
或者底层 dbm 直接抛出自己的提示,常见文案是带 locked file 字样的 fatal error(具体字符串随后端和语言环境变化)。
Errno 11 是 EAGAIN:锁被别人占着,申请不阻塞就直接失败。也就是说,这不是”你的数据坏了”,也不是”文件权限不对”,而是有一方正持有写锁且没释放。所以我们排查的顺序是这样:
- 先确认到底有几个进程/线程打开了同一个库。
ps看进程,代码里搜shelve.open的调用点,把每一处的flag抄下来——大概率能立刻看到某处是本该'r'却用了默认的'c'。 - 检查持锁方有没有正常关闭。最常见的是长驻进程开着写句柄不关,或者异常路径上跳过了
close(),with只覆盖了其中一处。 - 看锁的等待与重试策略。
EAGAIN是可重试错误,短暂退避重试通常能过;但要区分”真的忙”和”死锁”,重试次数必须设上限。 - 最后才怀疑后端本身。同一份代码换
dbm后端复现结果不同,说明问题在平台差异,不在你的调用逻辑。
顺手一个判断技巧:dbm 的库在磁盘上往往不是一个文件而是几个(后缀随后端不同)。看到只有一半文件生成、或者 .dir/.bak 残留,通常是写入方中途被杀,这时候清理前要先备份。
四、writeback:一边是”改了没生效”,一边是”整个库在内存里”
shelve.open(..., writeback=False) 是默认值,而这个默认值会让不少人愣一下:
with shelve.open('cfg.db') as db: |
db['items'] 是反序列化出来的一个新对象,append 改的是它,shelve 不知道这个对象被改过,关闭时不会把副本写回去。要生效就得自己显式赋值回去:
tmp = db['items'] |
看起来笨,于是有人把 writeback=True 打开——但这一下把代价换了个方向:shelve 会把你读过的条目全部缓存在内存里,等到 close() 或 sync() 时统一序列化写回。读得越多,驻留内存越大;一个遍历全库做统计的脚本开 writeback=True,等于把所有值同时拉进内存;进程中途崩掉,缓存里的改动整批丢失。
我们的取舍很明确:要么显式赋值回去,把每一次改动写成一次可审计的操作;要么只在一个很小的、明确知道上限的工作集上用 writeback=True,并且用完就 sync()。靠它当”自动脏标记”是不可控的。
另外 writeback 不改变并发语义。它只是决定改动什么时候被序列化,锁的争用一点没减少。
五、模式不能在运行中切换
社区里常见的问题是”能不能先只读打开,需要写的时候切成写模式”。答案是这条路不通:flag 是打开时交给 dbm 的参数,打开之后没有运行时改模式的正规方法。想要写入,就得先 close() 释放句柄和锁,再按写的角色重新打开。
由此推出一条比”切模式”更实用的分工方式:
- 写者只有一个。不管是单进程里的一个模块,还是多机部署时的一个任务节点,把写收敛到唯一入口。
- 读者一律
flag='r',并且把只读当作契约:路径上任何一处想写,就说明这个模块不该是读者。 - 真需要”读的时候要改”,不要改打开模式,改成”读者发请求、写者执行写”的消息或队列,把并发问题变成序列化问题。
六、什么时候留在 shelve,什么时候必须换
我们把判断压缩成一张表,评审时直接对着勾:
| 条件 | 继续用 shelve | 必须换掉 |
|---|---|---|
| 进程数 | 单一进程,生命周期自己管 | 多进程读写同一个库 |
| 写入频率 | 低频,能接受整值重写 | 高频、细粒度更新 |
| 查询方式 | 只用完整键取值 | 需要按键前缀、范围、条件筛 |
| 数据可见性 | 只有 Python 读 | 别的语言、别的服务要读 |
| 一致性要求 | 崩了重跑即可 | 需要事务、崩溃不丢 |
| 值体积 | 单值小、数量少 | 大对象或条目数上千 |
换到哪里,也不用纠结:需要条件查询、事务和本地文件部署,走 SQLite,键值结构就两张列(key TEXT PRIMARY KEY, value BLOB),值继续用 json 或 pickle 编码,迁移成本主要是把 db[key] = value 改成带参数的 SQL,换来的是 WAL 模式下真正的多读一写并发。需要跨机器共享、过期时间和服务间可见,走 Redis,同时把序列化格式显式定下来(JSON 优先),别让 Python 的 pickle 变成跨语言接口的私有协议。
最后一条经验:shelve 用得最爽的阶段,恰好是它最难被替换的阶段——脚本已经散落到各个环境上了。所以我们的做法是在项目起步时就给它划一个明确的边界:允许出现在单机脚本和一次性数据处理里,一旦同一个库文件需要两个以上进程打开,代码评审直接按”选错存储”处理,而不是继续加锁重试。