
从一张 Excel 到个人数据工作台:ETL、数据库、可视化三件套怎么搭
一、三件套分别解决哪一段
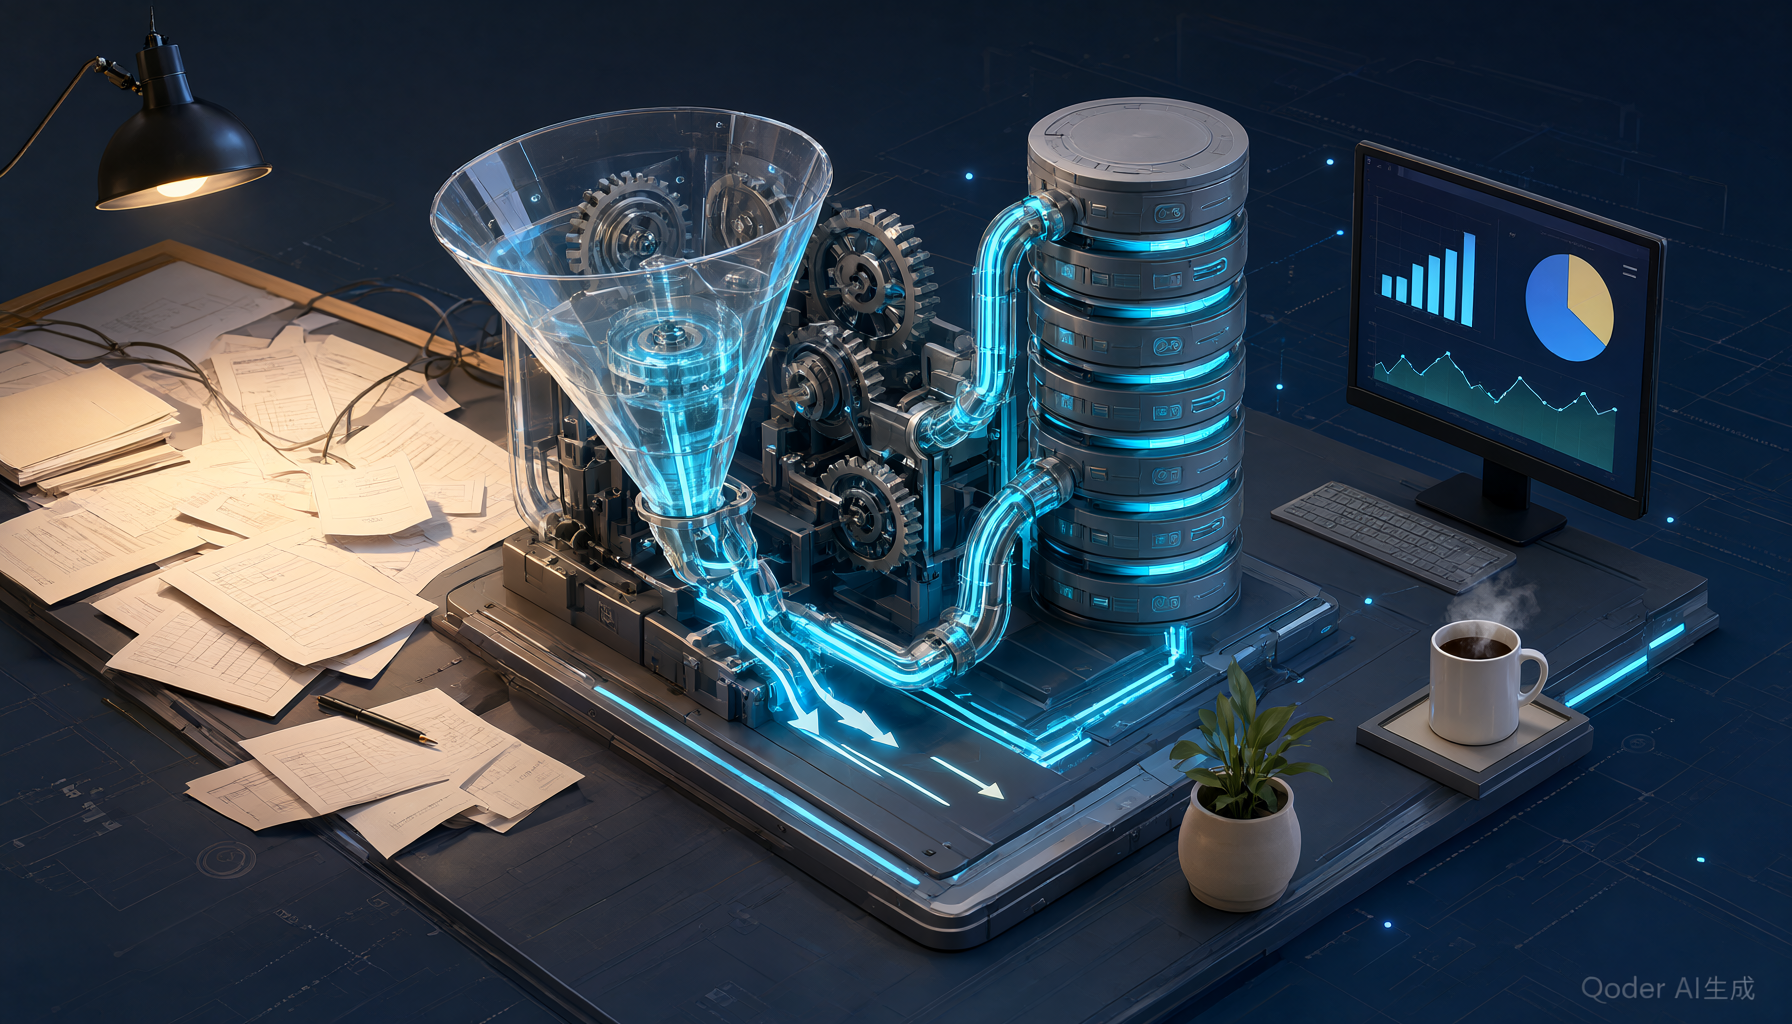
个人数据工作台的拆分逻辑,和企业级数据平台其实是同一套,只是规模不同:
| 环节 | 解决的问题 | 常见工具 |
|---|---|---|
| ETL / 数据准备 | 从 Excel、CSV、数据库、网页里把数据取出来,清洗成规范表 | Alteryx、Power Query、Python + pandas |
| 存储与建模 | 数据有唯一落地点,能写 SQL、能加约束、能被多人访问 | SQL Server、PostgreSQL、DuckDB |
| 可视化与共享 | 结果不是一张截图,而是可筛选、能自动刷新的页面 | Power BI、Superset、Grafana |
关键点是中间那一层。 大部分”数据做不动”的人,卡的是没有落地的库——数据永远在 Excel 里,每次分析都从原始表重新开始,清洗逻辑无法复用,也没法积累。一旦有了库,前面和后面的工具才好换。
二、为什么”低代码 ETL”这件事值得单独看
Alteryx 这类工具常被低估,理由是”生成的逻辑看不见”。但它在可重复的数据清洗流水线上有真实价值:
- 步骤可编排、可复跑。月度报表这类活儿,写 Python 要维护依赖和运行环境,拖拽式流程反而更容易交接给下一个人;
- 对业务人员友好。车间统计员、财务人员不需要会写
df.groupby(),但能理解”过滤 → 关联 → 汇总 → 输出”。
代价也要说清楚:流程一旦复杂到需要条件分支和循环,可维护性会迅速劣化,且很难做版本管理与单元测试。我们的判断线大致是这样:
- 步骤数在 20 步以内、无分支 → 低代码工具,收益最大;
- 有明确业务规则分支、需要复用与测试 → Python/SQL,写清注释;
- 需要调度、依赖管理、失败重跑 → 交给调度层,而不是在 ETL 工具里手点。
三、企业级往上一档,问题会变什么
我们给新乡本地制造企业做数据看板项目时,从”个人工作台”到”部门级平台”通常会遇到四个新增问题,值得提前规划:
1. 口径冲突。 两个人各自清洗出的”当月合格率”不一样,且都合理。解决方式不是讨论谁对,而是把指标定义写进字典并落到视图/物化层——只有从库里出来的那个数算官方数字。
2. 数据权限。 个人工作台不需要权限,部门级一定要。产线数据、成本数据、人员数据的可见范围必须提前划线,否则第一版上线就会出事。
3. 采集频次与数据源稳定性。 Excel 手工导出没有 SLA。上生产之后要问的是”这份数据每天几点前必须到”,答案决定了调度设计。
4. 谁负责。 个人工作台不需要责任人;企业平台必须有一个懂业务又能改流程的人。这一条比技术选型重要——我们见过太多买了 BI 工具但半年后停更的项目,原因都是无人负责口径维护。
四、我们给中小企业的起步建议
不用一上来就建数据中台。按这三步走,预算和风险都可控:
- 先把库建起来。 一张主表、一个只读账号、一个每晚自动备份,这三件事的成本极低,但把”数据在个人电脑里”这个最大隐患消掉了。SQL Server express 版或 PostgreSQL 都够用很多年。
- 把最痛的一张报表自动化。 选一张每周都要手工做、且做错的报表。这一张跑通之后,收益会被领导看到,后续投入才有依据。
- 再谈 BI 和看板。 有了库和一份可信数据,可视化工具的选型就变成成本问题而不是能力问题。
顺带说一句趋势:现在大模型接入之后,”能不能用自然语言问数”成了新的加分项。但我们的经验和当年做 BI 时的结论一致——问数质量的天花板是口径统一程度,不是模型能力。数据本身没治理,加一层 AI 只会让错误数字看起来更权威。
三层工具分工为通用实践;口径、权限、责任划分等来自洹拓科技本地数据平台项目实施记录。
新乡洹拓科技有限公司,软件开发 · AI模型研发 · 云服务与部署运维。
咨询热线:400-829-9957
地址:河南省新乡市辉县市金城百货四楼