
同期 Token 消耗涨到三倍:把上下文预算做成一等公民再谈降本
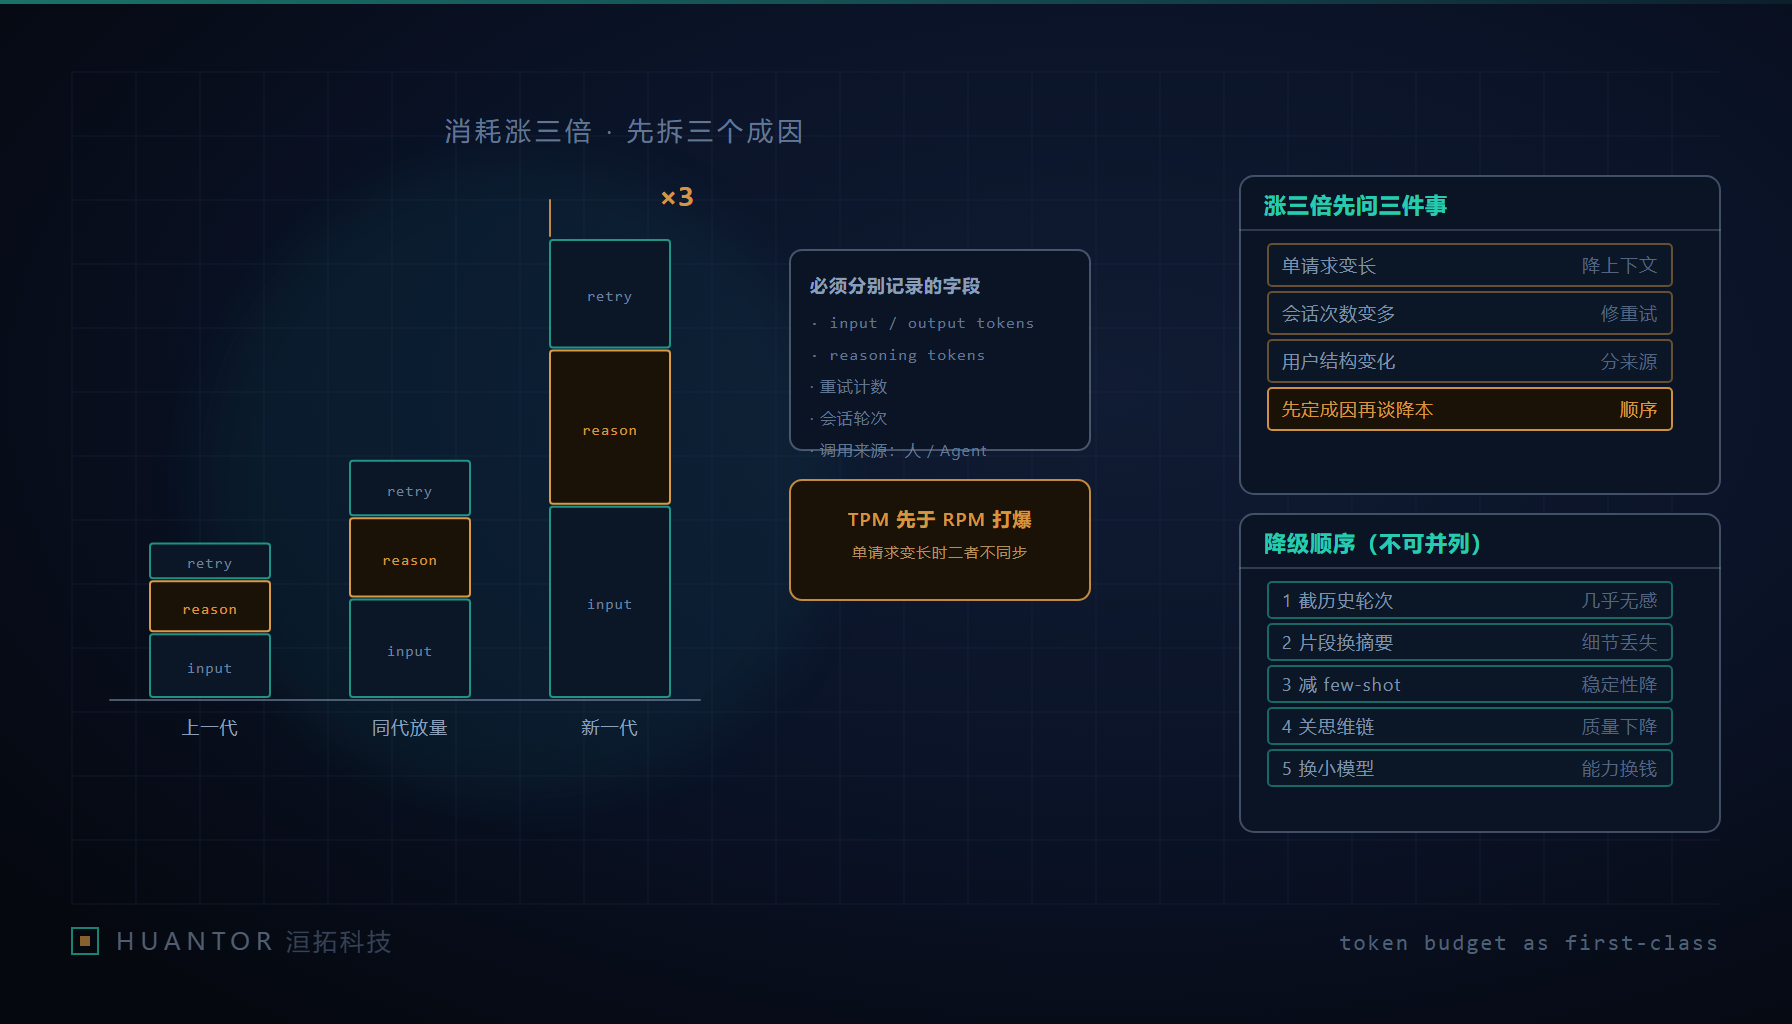
一、涨三倍这件事,先拆成三个可测的量
据公开报道,新一代旗舰模型 Gemini 4 Argon 上线 72 小时的吞吐接近 25 万亿 Token,是上一代 Gemini 3.0 同期消耗量的 3 倍,即使 Google 也不得不再次实施算力限制。同一批消息里,MiniMax 发布 M3.1 Flash 时称线上推理速度提升近 3 倍、使用成本降低 70%,并称上线 72 小时处理超过 100 万亿 Token。两件事方向相反,指向的却是同一个约束:供给按 Token 计,需求也按 Token 计。厂商怎么扛是厂商的事,下面只谈我们能在自己系统里做的那部分。
“消耗量上涨”不是一个数,是三个因子的乘积:单请求平均 Token 数、请求次数、单位时间的会话规模。三个因子的成因、归责方和解法完全不同,混在一起看只会得出”太贵了”这句没有用的话。
- 单请求变长。推理型模型的输出里带思考过程,而工具定义、系统提示、检索片段、历史消息全部计入输入侧。同一次业务问答,实际送进模型的上下文和立项时设计的那个量已经不是同一种东西。这类上涨是结构性的,与用户使用强度无关,也不会在账单上自己标出来。
- 会话次数变多。超时重发、结构校验失败重试、用户追问、Agent 自行决定再跑一步,四种都会推高请求数。前两种是工程浪费,后两种里有一部分是需求本身就没被一次满足。
- 调用结构变化。重度会话占比上升、自动化调用(定时任务、批处理、集成方脚本)份额上升。人没变多而量翻倍的时候,”人均成本”这个口径会直接骗人。
要把这三条分开测,前提是请求级记录里有字段。我们要求的最小字段集:input_tokens、output_tokens、reasoning_tokens(服务端不返回时显式记为未知,不允许补零)、重试计数、会话轮次、调用来源(人 / Agent / 定时任务)、场景标识、模型与版本标识、是否触发降级以及命中哪一档。字段齐了,趋势可以按维度切;字段不齐,后面所有降本讨论都是猜。
二、口径表:先看哪个数在动,再决定动哪个旋钮
这张表的用法是成对读:中间一列告诉你病灶在哪,最后一列告诉你手该伸向哪里。只报总 Token 数而不给下面这些切片,等于没测。
| 指标 | 口径定义 | 这个数涨了说明什么 | 该动的旋钮 |
|---|---|---|---|
| 输入侧 P95 | 一次请求进入模型的全部上下文(系统提示 + 工具定义 + 检索片段 + 历史) | 提示模板在长胖,或检索片段无上限 | 上下文组装层:字段裁剪、工具定义按需装载、片段条数设上限 |
| 输出侧 P95 | completion 全部 Token,含推理部分单列 | 模型在”想”,或输出格式退化成散文 | 推理档位、输出结构约束(要求字段化而非自由文本) |
| 推理 Token 占比 | 推理 Token / 全部输出 Token | 单看没有结论,必须与采纳率对照 | 按场景做档位 A/B,不看观感看返工率 |
| 每会话轮次 | 同一会话内的请求数 | 首轮没解决问题,或 Agent 在自续跑 | 改首轮完成度:工具描述、必填校验、示例,而不是加配额 |
| 重试率与重试深度 | 因超时、限流、校验失败而重发的比例与最大次数 | 错误本身在制造 Token | 退避策略与幂等键,重试次数设硬上限 |
| 来源分布 | 人工 / Agent / 定时任务各自占的 Token 份额 | 结构变了,人均口径失效 | 按来源分池配额,禁止共用一个额度池 |
| 降级触发率 | 命中预算阈值后走降级的请求占比 | 预算定义与实际用量脱节 | 要么重定义预算,要么砍产生上下文的功能 |
| 每有效任务成本 | 只统计结果被用户采纳的会话,折算到 Token | 唯一能拿去和客户谈的单位成本 | 前七个切片都为这一行服务 |
表里最容易被省掉的是”来源分布”和”每有效任务成本”。前者省掉了,自动化脚本的增长会被算到普通用户头上,产品侧就会得出”用户变贪婪”的错判;后者省掉了,降本动作就会打在那些确实带来采纳的长上下文上,把功能当成本砍。
三、把上下文预算写成需求阶段的一个数
预算不是在网关里配一个数字,那只是执行。真正前置的做法是:每个场景在需求评审时先定义信息集,也就是这次请求到底必须让模型看到什么。信息集分三格,必须逐格填,空格也要写明为空。
- 必带字段:缺了就无法回答的输入,例如待判定的原文、目标 Schema、当前用户诉求。这一格的数量直接决定预算下限。
- 可省字段:有了更好、没有也能干的,例如历史同类案例、附加术语表、多份参考文档。这一格是降级的靶子。
- 可摘要历史:需要连续性但不需要逐字的,例如会话前情、上一次输出结论。这一格必须写清摘要责任在谁、摘要保留几轮、摘要后的原文还能不能追回。
填完三格,把这个场景的预算写成一个式子:每请求 X Token(输入侧与输出侧分列),超出即触发降级,降级走第四节那条固定顺序。X 由信息集推导,不由”上线后再看看”倒推。配套三条规矩,缺一条这个数就会在半年内变成装饰:
- 预算写进需求文档和验收条款,和响应时间、准确率并列;没有预算字段的场景不予评审通过。
- 新增检索源、新增工具定义、新增少样本示例,必须先报预算影响。这条挡住的是”每人加一点、总量翻倍”的那种腐化路径。
- 上线前出一份上下文构成快照,取空会话、典型会话、最长会话三种情形,列出各段占的 Token 与来源字段,交出去留档。后面出问题时有基线可比,不用现场猜。
这套写法和”调温度、改提示词”的差别在于责任归属:预算是需求方和交付方共同签字的量,提示词是开发者一个人的手艺。前者能被验收,后者只能被争论。
四、降级顺序不许并列,必须排出先后
超出预算时自动做点什么,这件事本身没有争议;争议全在顺序上。我们的固定顺序如下,每一档都写清”用户能感知到什么”,因为不可感知的降质是最贵的一类事故。
- 截历史轮次。保留会话末尾的若干轮,更靠前的丢弃或换成摘要指向。用户感知:模型偶尔忘了前面提过的细节,但答复风格和结论形态不变。这是最便宜的一档。
- 检索片段换成摘要。原文片段改为压缩过的要点,出处标记保留。用户感知:答复变笼统,引用不再逐条对得上,专业用户会立刻问”依据呢”。
- 减少少样本示例。示例条数下调。用户感知:输出格式稳定性下降,偶发排版跑偏和字段缺失,返工次数上升。
- 关掉思维链输出或降推理档。用户感知最强烈的一档:答复变短、多步推理掉得多、复杂任务错得起眼。这一档之后任何动作都必须显式告知,不能静默。
- 换更小模型。用户感知:语气变了,专有名词和长文档处理能力变化,长尾任务返工。切换要带版本标识落库,否则事后无法解释同一天里为什么有两种质量。
- 拒绝并告知。明确失败,附原因与”稍后重试”的可执行提示。宁可看得见地失败,也不要静默降质——静默降质的成本是客户自己发现质量下降并且不告诉你从哪天开始的。
顺序的判据是用户可感知程度与不可逆程度都要比上一档高。前两档几乎无损且可回滚,第四档往后开始伤功能。反过来排(先换小模型、后截历史)的团队通常是因为没有把”用户能感知到什么”写进设计。
五、限流是容量问题,不是惩罚机制
按 Token 计的配额(TPM)和按请求计的配额(RPM)不同步,是这一轮消耗上涨里最容易踩到的结构问题。单请求上下文变长时,请求数没有增加,RPM 远未触顶,但 TPM 先被击穿——表现是流量看起来平稳、监控全绿,用户侧却集中报”卡住 / 重试 / 超时”。这类现象如果按 RPM 的直觉去排查,会一路查错方向。
- 两个配额要一起画在一张趋势图上,并把”输入侧均值”叠在第三条线上。TPM 触顶而 RPM 空闲,几乎一定指向单请求变长,而不是访问人数增长。
- 重试必须有退避上限,而不是靠加配额。带抖动的指数退避、重试次数设死、超限即快速失败并告知用户。加大配额只是把同样的重试风暴推到更高的水位去爆,代价是同一时间窗内被打穿得更彻底。
- 重试要带幂等键。没有幂等键的重发不只是多花 Token,还可能产生重复写入;限流期间用户手动再点一次,效果叠加。
- 配额按来源分池。人工交互、Agent 自动跑、定时任务共用一个池时,批处理会把在线请求挤到降级链上;分池之后才能做”保人、限机器”这种明确取舍。
- 超限优先排队而不是直接失败。短队列 + 明确的等待提示,把用户从”不知道有没有成功”里救出来;队列要有超时,超时后走第四节最后一档。
- 给降级链本身留容量。如果降级后的请求仍走同一条拥堵通道,第五档换小模型就换不出喘息空间。
这里有一条我们不会妥协的验收项:限流触发时必须能被事后复盘。命中的是哪个池、哪个阈值、当时输入侧均值多少、走没走降级、最终有没有成功——这些要能从请求级字段里还原出来。只在前端弹一句”当前使用人数较多”,等同于把容量问题藏起来。
六、洹拓视角:口径没建起来之前,降本降的是功能
把上面五节收成一个判断:一次消耗量翻倍里,通常只有一部分是”模型想得更多”带来的必要成本,其余是可回收的工程浪费——无上限的检索片段、没有退避的重试、共用额度池的批处理、腐化掉的提示模板。区分这两部分的唯一办法是先有请求级口径。跳过口径直接上降本手段(缓存、蒸馏、换小模型那套清单我们不在这里重复),最后砍掉的往往是功能:因为没人能证明哪一段上下文其实没有参与决策。
这件事在什么条件下不成立,也说清楚。若是调用结构变了——自动化任务本身在真实增长——那这是业务问题,工程侧的裁剪只会让任务失败率上升,正确动作是重新分池并和客户重谈产能边界;若是极小范围单场景的自用工具,建全套请求级口径的成本可能高于浪费本身,那就只保留输入侧 P95 与来源分布两项,其余靠人工抽查。洹拓科技内部把这条定成评审规矩:任何 Token 降本方案在提出时,必须同时给出它依赖的口径字段和它可能误伤的功能清单;给不出后者的,方案按未成熟处理。我们不接受”先降下来再说”,因为降下来之后再想还原哪一次答复是被哪一档降级弄差的,基本还原不了。