
给机器人办"学校":数据采集场地要先标准化的三件事
一、两件事同时出现,指向的是同一块短板
据公开报道,一方面有厂商透露计划为自家的人形机器人建造训练场地,用来支撑模型训练;另一方面,也有具身智能方向的团队负责人离开原公司创业,做的是数据采集设备。这两条新闻放在一起才有意义:当”造场地”和”造采集设备”变成两门独立的生意,说明行业撞上了同一个问题——机器人数据不是标注出来的,而是被环境和流程约束出来的。环境不固定、流程不统一,标注再精细也只是给一堆不可比的东西贴标签。
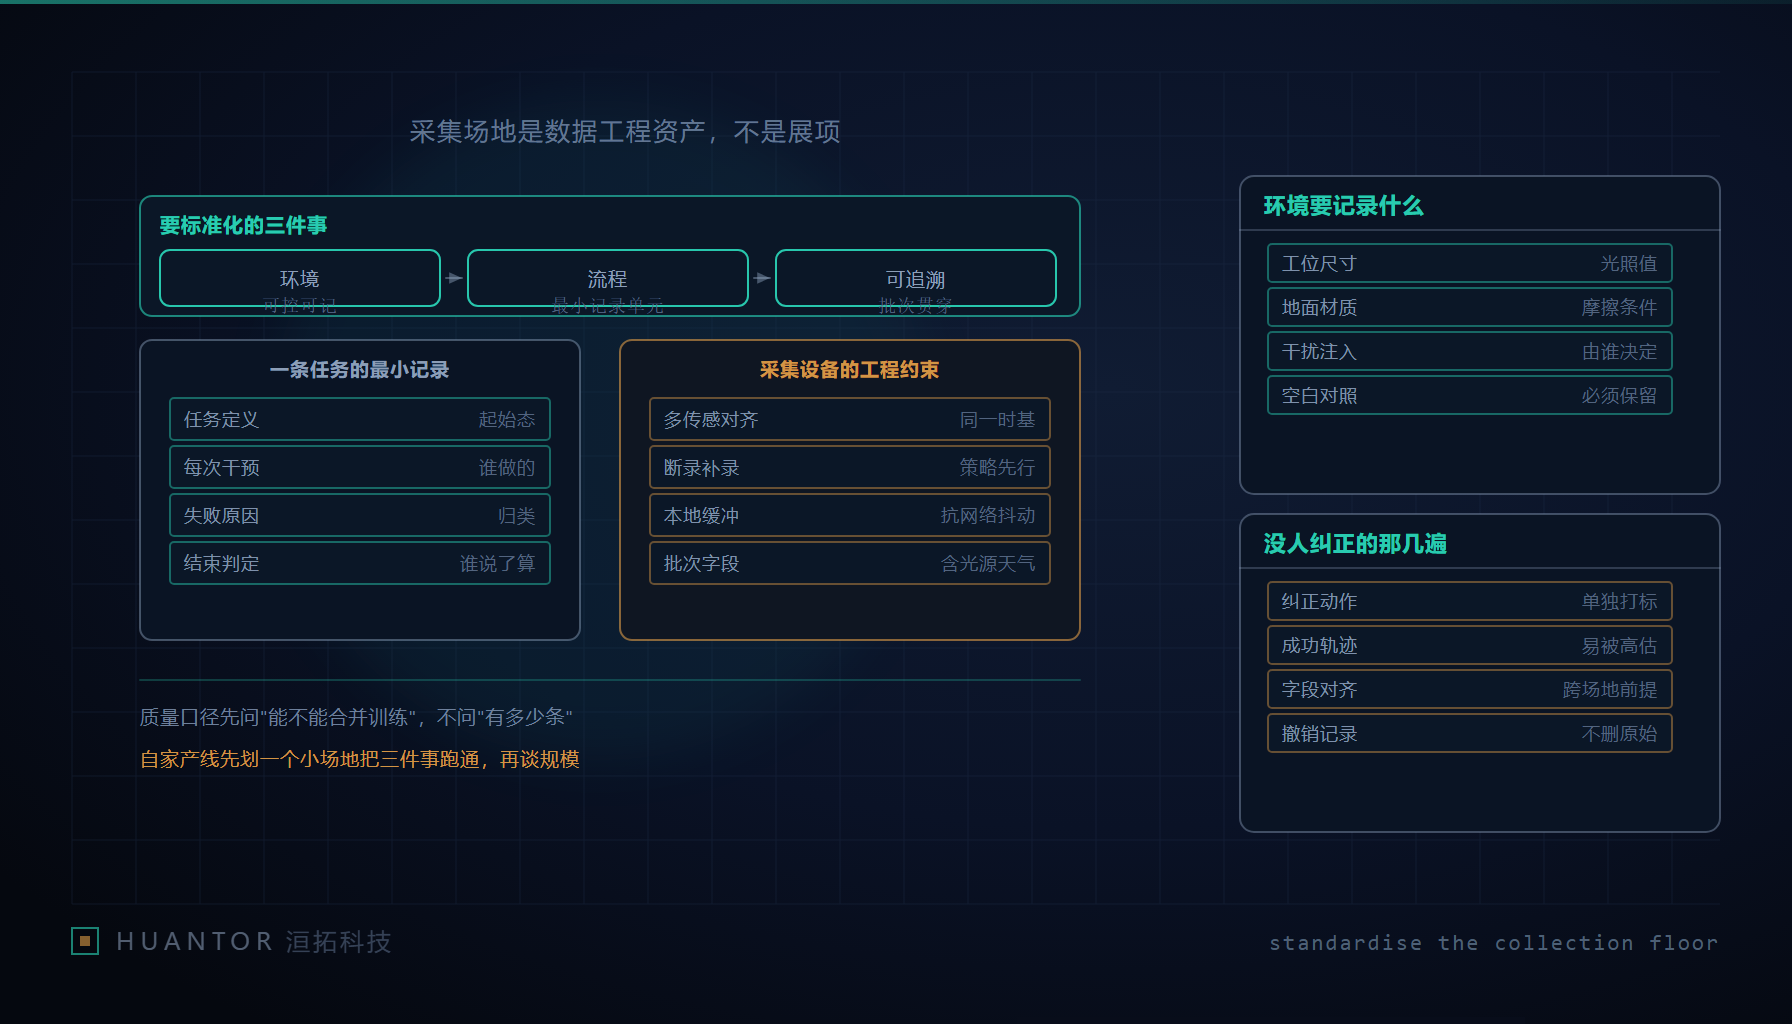
这件事对做工业 AI 的团队有直接迁移价值,因为我们的客户场地本来就在:产线、仓库、装配工位。差别只在于我们通常没有把它当成一项数据工程资产来设计。下面三件事按重要性排序:环境、流程、可追溯。三件事都没跑通之前,讨论采集数量没有意义。
必须先说明本篇的边界:不评价任何人形机器人路线的成熟度,不讨论任何公司投入规模,也不预测什么时间能量产。只谈场地该怎么建。
二、环境标准化:随机性要有主人,也要有记录
工位尺寸与光照是第一批要写死的量。这里的关键不是”要把光照做得很均匀”,而是光照要变成一个有记录的变量:每个工位的灯具型号、安装高度、色温、可调档位、当时的档位读数都要能查。同一批数据里混入了两种色温,视觉模型的输入分布就悄悄变了,而事后没人能发现。地面与材质同理,包括摩擦系数类别、反光程度、以及有没有临时铺过垫子。
第二件事比”环境多真”重要得多:干扰物由谁注入、什么时候注入、注入在哪,必须写进流程。现场最常见的做法是操作员随手把工具箱挪了个位置,或者临时站了一个人。这属于未记录的分布偏移——它让数据看起来更”丰富”,实际是让失败无法归因。正确做法是一张扰动注入表:扰动类别(遮挡、位置偏移、异物、光照变化、装载变化)、注入时机、注入位置与幅度、是否允许在同一任务里叠加。扰动本身要作为字段写进记录,这样它才是一个可控变量而不是噪声。
第三件事是空白对照。某些场景必须留一组”不干预、不示教、原样重复”的对照采集,包括:涉及力与极限的、涉及安全的、以及将来要对外说”自主完成”的那类任务。对照组的用途很朴素:如果只有人纠正过的版本,你永远无法判断这段数据体现的是策略能力还是操作员能力。场地设计阶段就要给对照组留时间和工位,否则永远排不进去。
三、流程标准化:一条任务的最小记录单元
一条采集记录如果不满足下面这个最小单元,它就没有复用价值。
| 字段 | 内容 | 为什么必须有 |
|---|---|---|
| 任务定义版本 | 目标、成功判据、允许路径、禁用动作,带版本号 | 判据变了而版本没记,同一批数据里就混了两种”成功” |
| 起始状态 | 工件位姿与姿态、夹具状态、物料数量、上一任务残留 | 失败常常来自起始状态差异,没记就只能猜 |
| 执行事件流 | 带时间戳的传感器流、动作指令与状态回读 | 只有结论没有过程的数据无法训练判断能力 |
| 每次干预 | 干预时刻、类型(接管/复位/口头提示)、干预者 | 用来把纠正帧与自主帧分开,也用来算人介入频率 |
| 失败原因 | 分类编码加自由描述,采集现场就填 | 事后补写的原因几乎全部失真 |
| 结束判定 | 判定方式(自动规则还是人工)、判定结果、判定人 | 没有这栏,”成功”是主观印象 |
| 完整性 | 帧数、时长、校验值、缺口标记 | 防止拼接出来的”完整”数据 |
在这个表之上还有一条容易被反对的规矩:必须录”没人纠正”的那几遍。理由是纠正帧会把人的收拾残局能力一起教给模型,看起来数据质量高了,实际把策略本身的失败边界掩盖掉了。纯自主片段才能定基线,而失败片段的价值往往高于成功片段——一个只有成功样本的数据集,能训练的行为上限就是”照着做”,它无法回答”什么时候该停”。采集排期要给失败留位置,不设”今天已经采了这么多条够了”的停止条件。
四、可追溯:批次号要一路贯穿到外部变量
复现失败的原因,绝大多数不是代码问题,而是批次号断在了某个环节。一个可用的批次标识至少要能查到:场地与工位编号、采集时段、设备与传感器序列号、固件与驱动版本、标定有效期、光源档位、室温与天气(若工位靠自然采光或涉及室外)、操作员与班次、任务定义版本、脚本与配置版本。
这一层真正的用处是判断两批数据能不能合并。同一任务在不同场地采到的数据能否放进同一次训练,取决于字段是否对齐而不是各有多少条:坐标系原点与朝向的定义是否一致、单位与量纲是否一致、相机的内外参与曝光设置是否可比、时间基准与采样率是否一致、成功判据是否同一版本。这些对不齐时,合并训练不会报错,只会让模型学到”两套互相矛盾的世界”,而表现退化常被误读成数据不够多。所以我们主张:采集规范以 schema 的形式发布,字段名、类型、单位、坐标系定义写进同一份文件,schema 变更要走版本号,任何批次的记录必须声明它符合哪一版 schema。做不到这一点,多场地扩产就是多份不可比的数据。
五、采集设备自身的工程约束
专门做采集设备的方向值得注意,因为设备层的坑比算法层的坑更早发生。四条硬性约束:
- 时间戳同步。多传感器融合的前提是同一时钟。所有源要同步到一个主时钟,并把偏移量作为可查询的指标而不是假设它为零;相机、关节编码器、力与触觉传感的采样率不同,必须记录各自的时钟域与换算方式,否则回放时动作与观测永远差半拍。
- 多传感器空间对齐。外参标定要有留档,包括标定板照片或标定结果、标定日期、标定后是否移动过设备。设备搬运一次,原来的外参就作废——这件事必须在记录里留下”搬运事件”,而不是靠人记得。
- 断录与补录策略。要明确允许缺口还是禁止缺口。我们主张允许缺口但必须显式标记,禁止任何形式的静默拼接:网络抖动或存储写满导致丢一段,补录时把前后两段接起来,看起来数据完整,实际把一段动作的因果链条抹掉了。这类数据在训练阶段很难被排除,在评估阶段会伪装成”模型偶发失误”。
- 本地缓冲与网络抖动。上传失败时的优先级要预先定义:保什么、丢什么。一般做法是低帧率的原始传感流与事件日志绝不丢,高分辨率影像可以降码率或延后补传;缓冲写满时宁可停止采集并告警,也不要覆盖已采集段。所有断点续传动作要在完整性字段里留下痕迹。
这四条不是”锦上添花的规范”,它们直接决定一条数据能不能被回放、能不能被核对。
六、先定能不能用,再谈有多少条;先跑通一个小场地
质量口径要前置。一批数据交付时,我们只问一句能不能用,判据是清单化的:可回放(时间戳单调、无静默缺口)、字段齐(最小记录单元无缺项)、标定有效(外参与时钟在有效期内)、失败被记录(有失败原因分类,不是只留成功)、坐标系一致(与 schema 声明一致)、能追到批次(每个外部变量可查)。全过才是可用,缺项的部分进不了训练集,只进”待补录”队列。数量口径放在后面,因为规模只会放大既有问题。
给企业客户的落地顺序,我们的建议只有一条:先在自家产线里划出一小块场地,把环境、流程、可追溯这三件事跑通,再谈扩大规模。小场地的好处是变量可控——同一个班组、同一套光照、同一批物料,此时建立 schema 与扰动注入表的成本最低,争议最小。等它成为默认做法,再复制到第二条产线,复制的对象是 schema 和记录单元,不是”把那边的设备照买一套”。反过来先买设备再定规范,几个月后一定手里握着两套字段不一致的数据,谁也合不了。
场地是资产,展项也是场地,两者区别只在这一批数据明年还能不能用。这也是洹拓在做工业数据采集方案时的第一道评审:先看 schema 与批次字段,再看相机有几台。