
从漫剧 Agent 到出海短剧 Agent:AI 视频工具链该拆成四层看
一、两条时间线说的是管线,不是模型
8 月中旬,字节内测一款面向漫剧行业的 Agent,产品名就叫”漫剧创作工具”;9 月 21 日,其海外品牌 BytePlus 上线面向海外短剧制作的 Agent。两个产品指向的是同一条链路的同一段:剧本进去,成片出来。同一批新闻里还有个背景值得并排看——国内首部拿到院线公映许可证的 AI 超写实电影上映后票房遇冷,也有传统影视机构与短剧平台合作拍真人精品短剧的动向。生成侧的产能在扩,成品在正式发行渠道里并没有被照单收下。这两件事不矛盾,它们说明瓶颈已经从”能不能生成”挪到了”生成之后那道工序”。
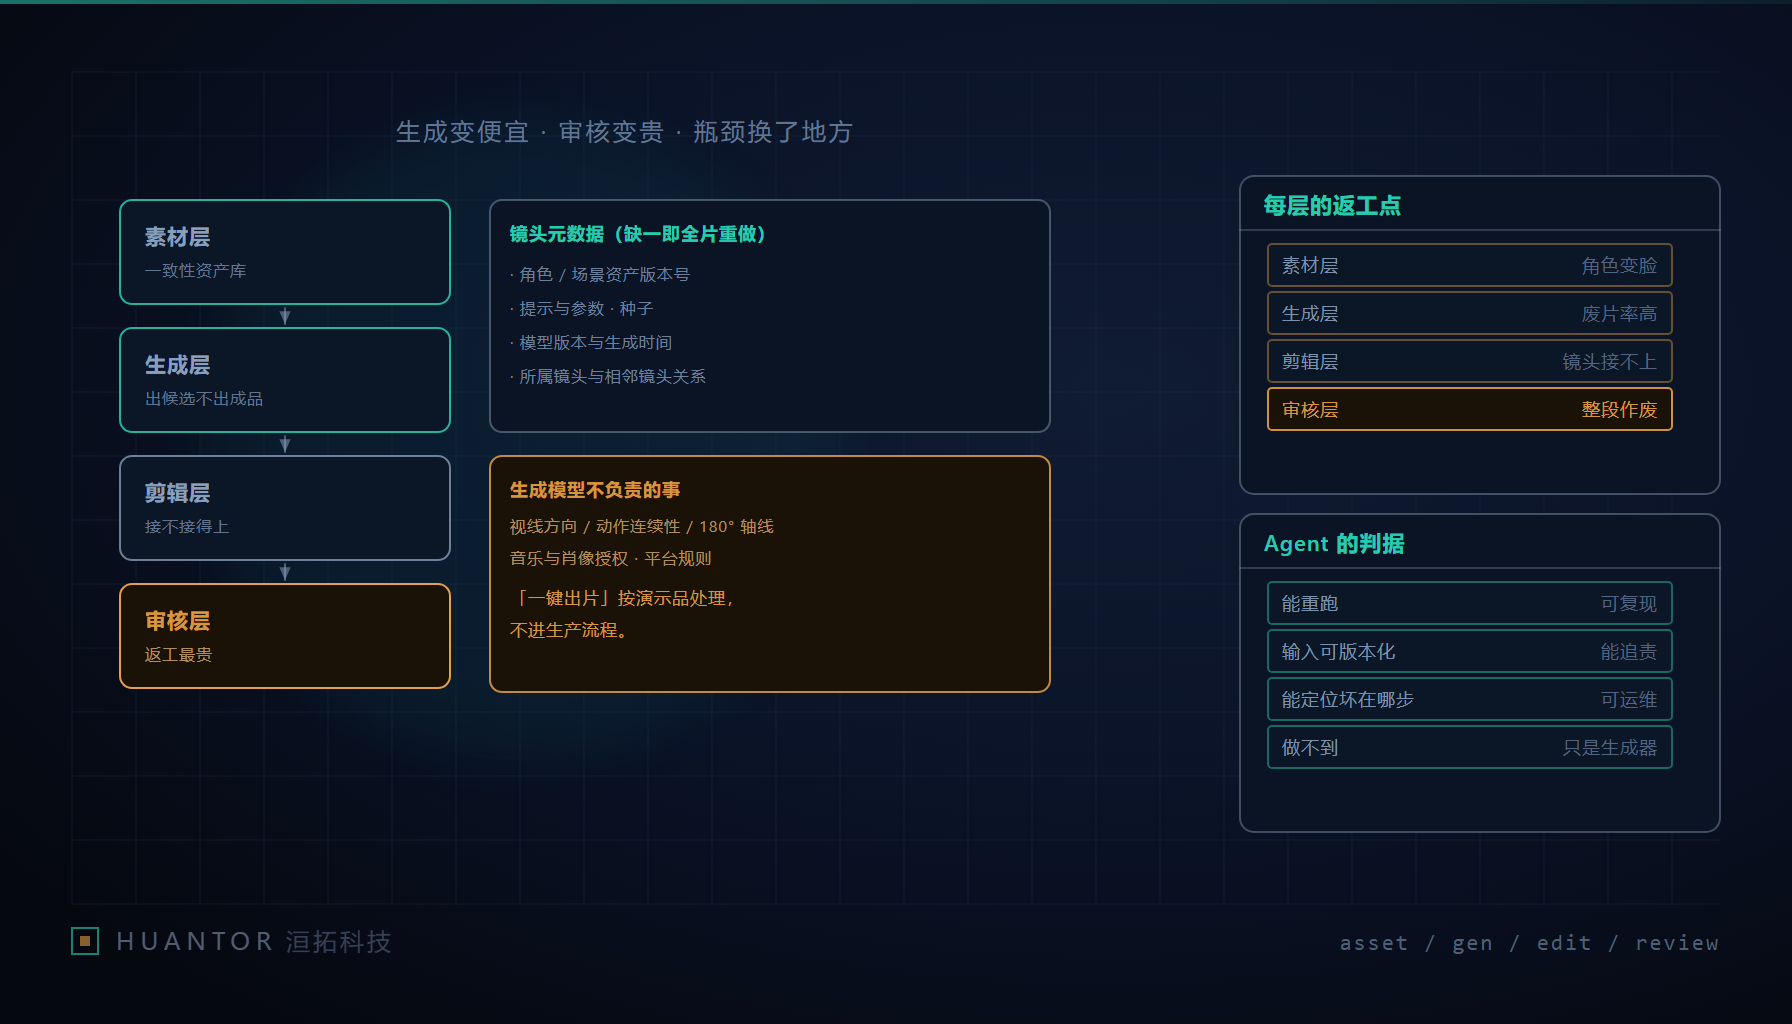
发布材料给的是能力清单,交付要用的是结构。把这类工具拆回素材、生成、剪辑、审核四层,哪一层已经能整层交出去、哪一层交出去只会把返工推到别人手上,这才谈得清楚。这句话我们说得比较谨慎:洹拓科技自己不做内容,但凡是带批量产出与人工复核环节的系统,交付时都要把”产能”和”通过率”分开算账,这两格从来不是一回事。
二、四层拆分:每层的输入输出与返工位置
| 层 | 输入 | 输出 | 当前自动化的真实水平 | 返工最常出现在这里 |
|---|---|---|---|---|
| 素材层 | 剧本、风格设定、角色与场景描述 | 可复用的角色/场景/道具资产包 | 单张能出好看的,跨镜一致要人盯 | 同一角色换了集数就换脸,整集重做 |
| 生成层 | 分镜脚本 + 资产引用 + 参数 | 候选视频片段(多条) | 可用,但产出的是候选不是成品 | 动作幅度、口型、镜头时长不合 |
| 剪辑层 | 候选片段 + 对白 + 音效 + 字幕轨道 | 成集时间线 | 最被低估的一层,自动化只做机械活 | 前后镜头接不上,节奏塌 |
| 审核层 | 成集 + 发布渠道规则 | 可发布版本或退回单 | 规则可机检的部分少,判断部分全是人 | 平台驳回、肖像与音乐授权缺失 |
素材层的核心不是”生成得好看”,是”跨镜不变”。 同一角色在两个镜头里五官不同、同一房间在两个机位下家具对不上,这类问题靠多生成几次解决不了,它要的是参考集与锁参:固定的角色参考图集合、固定的种子或等效的权重约束、固定的提示模板,全部纳入版本管理。做得好的团队,素材层产出的是一个资产库而不是一堆图。
生成层的产出物是候选集,不是镜头。 这一点必须在验收口径里写明白,否则甲方会按”出片”来算钱。这一层废片率高是常态,把它当成品看的项目,后期一定在争论”这条到底算不算交付”。
剪辑层的自动化最容易宣传、最难用。 生成模型不关心前一个镜头和后一个镜头能不能接:视线方向是否延续、动作是否在切点上是连续的、对话双方有没有越过 180° 轴线、上一集结尾的情绪能不能接到这一集开头。这些判断在人这里是直觉,在模型这里没有监督信号。所以这一层现在能自动化的只有机械部分——按时长裁剪、按模板加字幕、按响度标准归一。真正决定”看起来是不是一个团队做的”的那些活,还在人身上。
审核层是返工成本最高的一层,而且完全不能靠”再生成一次”解决。 平台内容规则、音乐授权、演员肖像、字体授权、题材限制——被驳回的原因跟画面质量无关。这一层的每一次返工都是整条链路重跑一遍。
三、”Agent” 这三个字只有三个可验证含义
把它写成营销词很容易,写成可判定的三条也不难。一个工具链能不能叫 Agent,我们只看这三条:
- 可重跑。 同样的输入重新执行一次,中间产物能逐节点比对,结果差异能解释。做不到这条,任何一次坏产出都无法归因,只能整条重来。
- 输入可版本化。 剧本、资产包、提示模板、模型标识各自有版本号,并且每一次执行记录的是”这次用的是哪几个版本”。没记录,重跑时用的模型悄悄换了,差异就说不清。
- 可定位坏点。 出问题时,能指出是素材层的角色资产坏了、生成层的这条候选本来就不行,还是剪辑层的对齐错了。这条决定了返工是重做一段还是重做一集。
至于批量——一次跑出一批候选再人工挑少数可用的——那是这三条成立之后自然拿到的收益。三条里缺任何一条,这个产品就是带界面的生成器:过程不可复现,结果不可归因,坏一次全片重做。这类工具我们在方案评审里的处理方式和”一键出片”的宣传品一样,可以试,不进生产流程。
四、一致性资产与镜头元数据:字段怎么设计
真正的工程难点在资产和元数据,不在模型。下面是我们认为一个能长期跑的漫剧/短剧项目必须落库的最小字段集合:
- 角色资产标识与版本:角色 ID、版本号、参考图集合的清单、锁参方式(固定种子、专用权重或等效手段)、生效区间(哪几集用的是这一版)。
- 场景锚点表:同一场景的机位列表、每个机位的朝向与可见物、锚点之间的对齐参照物。没有这张表,同一房间的多个机位必然对不上。
- 镜头元数据:镜头号、所属集、时长、画幅、所用角色版本、所用场景版本、上游与下游镜头号、入点出点的动作描述。
- 生成参数快照:完整提示文本、负面提示、模型标识与版本、生成时间、参数集指纹。这一条是重跑的前提。
- 资产引用反向索引:每个角色版本、每个场景版本被哪些镜头引用。改一版资产时,先查这张表算影响面,决定重做范围。
- 筛选结论与理由:每条候选谁选的、按什么标准选的、落选的原因。这决定了下一批候选的提示怎么改。
- 授权状态位:素材里出现的音乐、肖像、字体、第三方素材,逐项标注授权来源与可用范围,缺项就不允许进入发布队列。
第 5 条和第 7 条是最常被省掉的,省掉的后果很具体:没有引用关系,改一版就得全片重做——这才是这类项目”越做越贵”的根因;没有授权状态位,返工发生在上线之后,损失的不是工时而是整条片子下架。至于第 3 条里的上下游镜头关系,它是把剪辑层从”人肉试错”变成”按图索骥”的唯一办法。站内《AIGC 内容需要一本创作手册》讲过发布标准的条目化,这里不重复那份清单,只说字段设计这一件事。
五、返工后移:前期变便宜,后期与审核变贵
这类工具改变的是成本结构,不是把成本削平。前期制作的边际成本明显下降,因为一条提示可以换一批镜头;后期和审核的成本反而上升,因为候选量大幅上升,而人工筛选与审核的能力没有同步上升。省下来的钱没有消失,它只是从”生成”这一格挪到了”挑”和”审”这两格。
所以立项时该算的账不是”一天能生成多少条”,而是:产能 = 生成能力、人工筛选能力、审核带宽三者里的最小值。拿生成速度当产能来承诺,是这个品类里最常见的算术错误。判断一个团队有没有真的跑通过,问一句就够:你们一集片子从剧本到可发布,卡在哪个环节、返工几次、谁在做返工。答得出返工分布的团队,四层是拆开的;答不出来的,四层在脑子里是一层。
还有一个反向效应值得写清:审核返工是整链路重跑,素材返工是局部重跑,生成返工只是一条候选。返工的单位成本沿着”生成 < 剪辑 < 素材 < 审核”的顺序涨。工具链设计的方向应该是把问题尽量拦在左边,而不是把右边做得更快。
六、三条准入建议,和我们只承诺的两层
给准备上这类工具的客户,我们的建议只有三条,都能直接写进采购条件:
- 先跑一条完整样片再谈批量。 这条样片必须走完审核与发布,而不是停在”生成了一个视频”。走完一遍才知道驳回原因落在哪一层。
- 要求供应商说明素材授权链,并且拆成三段问。 模型的训练数据授权、模型输出的商用许可、输出里可用到的第三方素材(音乐、字体、肖像)可用范围——这三段互相独立,供应商经常用第一段的答案回答第三段的问题。
- 把失败回收写进验收条款。 不合格镜头由谁重做、按什么标准判定不合格、重做的计费方式,三条都要落到文字。没有这几条,返工的成本默认由甲方承担。
至于我们自己的边界:这四层里,洹拓科技只承诺把素材一致性管理和元数据可复现做成可交付资产——也就是第四节的字段设计、引用索引与权限状态位,加上第三节那三条判定能力的落地。审核层里能规则化的部分(授权状态校验、必填项检查、发布规格校验)可以做工具,判断本身不做。
最后把话说完:把”一键出片”当卖点的工具,在方案评审里按演示品处理,不进生产流程,这个判断不会因为出现了更多 Agent 产品而改变。但这条判断有明确的适用边界——如果项目要的是生命周期只有几天的投放素材、后续完全不复用、也没有正式发行渠道,那四层可以压成生成加人工筛选两层,元数据只需要记模型版本和提示,一致性资产也可以不做。那种场景下把流程做重,是交付方在给自己加成本。