
AI 用在防守侧到底能不能扳回一城:先看三类可用面
一、先承认那半句不好看的话
据公开报道,有议题复盘指出 AI 在软件业的多个环节确实见了效,但在安全领域的表现一直不算理想,而 AI 生成代码本身还多带来了一层隐患。来源没给具体案例、漏洞编号与厂商动作,本篇不补这些;值得讨论的是”防守方要不要上模型”这个问题该怎么问。
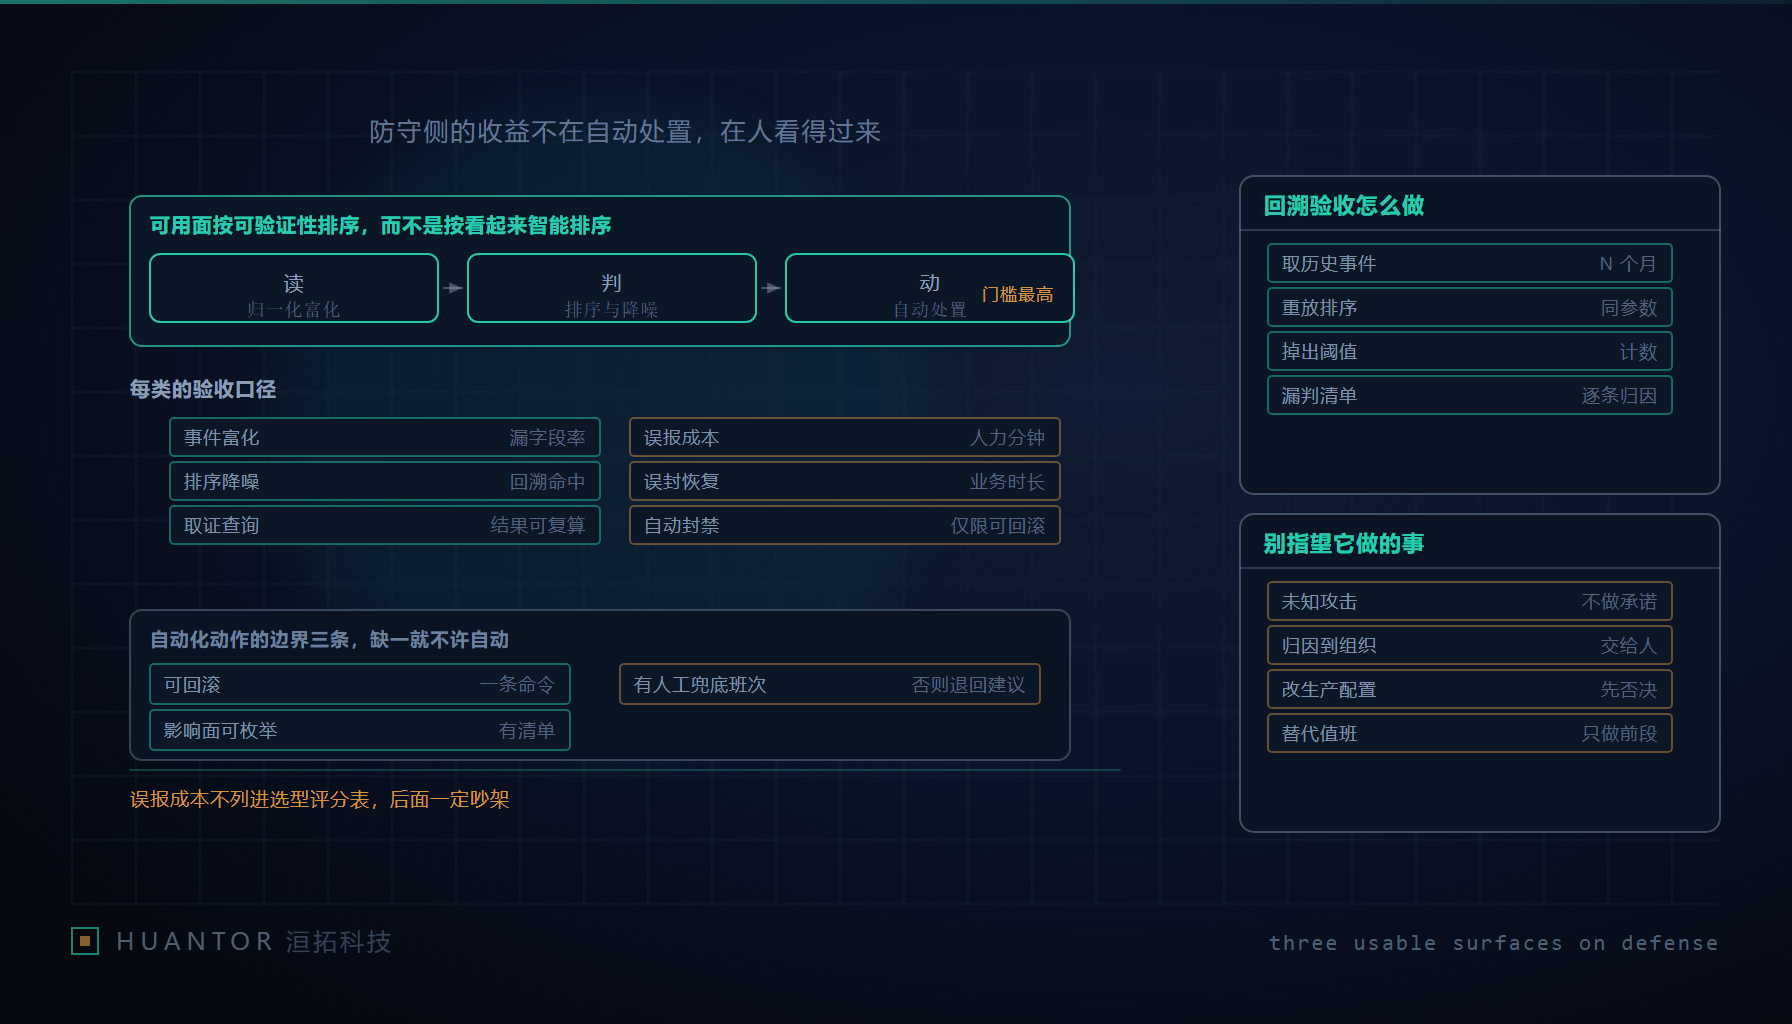
多数讨论问的是能力:”模型能不能发现攻击”。这个问题答不清楚,因为防守的失败方式太多,任何肯定回答都会被下一次事件推翻。工程上更好用的问法是:在这条链路上,模型能让哪一段变成人看得过来的。防守链路大致三段:可读(把原始信号拼成一条人能看懂的事件)、可判(在几百条事件里决定先看哪条)、可动(决定看完之后立刻做什么)。我们的结论是:前两段能拿到可验收的收益,第三段的收益大部分是名义上的,风险是实际的。排序按可验证性来,不按看起来有多智能来。
二、可用面一:归一化与富化,验收只看漏字段率
安全运营最消耗人的部分往往不是判断,而是凑齐上下文:一条告警只有 IP 和时间,要自己去查资产台账、查归属应用、查变更记录、查同类工单。模型在这里的价值是把四五个来源拼成一条可读事件,这件事确实省人。
但它的验收口径不能是”生成得顺不顺”。通顺的拼接最危险,因为它可以把没有的字段编得看起来有。可用面一的验收只看一个指标:漏字段率,也就是拼出来的事件里,本该有值却缺失或被瞎填的比例。
- 先定义每条事件的必需字段与可空字段,比如资产归属、暴露面、来源系统、时间源、关联变更。可空字段要有明确的空值表达,不能用空字符串。
- 富化结果逐项标注来源系统标识与取到值的位置,没有标注的字段视为未通过。
- 抽样核对时问三句话:这个值是从哪条原始记录来的;同一条记录用规则引擎拼能不能拼出同样的值;拼不出来是数据缺失还是模型填的。
- 上线后持续统计每个字段的缺失率与错填率,把它做成一张按来源系统维度的表,因为漏字段通常集中在某一两个接入质量差的数据源上,平均值会掩盖它。
这一段的好处是它的产出是可核对的中间物:一条事件不对,可以定位到某个字段错。这让后面所有的判断有一个共同的起点。
三、可用面二:优先级排序与降噪,验收必须用回溯口径
降噪是需求最硬的一段,也是最容易被做坏的一段。做坏的原因很具体:评估用的是”这条告警看起来该不该排低”,而真实需求是”被排低的那条里有没有漏掉的真实事件”。前者靠观感就能通过,后者必须回放。
可用的验收口径只有一条:把历史数据当作考卷。取过去若干个月已定性的真实事件(不是告警,是事后确认确实出过事的记录),连同同期全部噪声一起喂给这套排序,看有多少真实事件掉到了阈值以下。掉下去的数量除以真实事件总数,就是这套排序的漏判代价。
配套要盯的几件事:
- 分时段统计,不要只看总体。真实事件常出现在夜间与假期,而噪声模型在周末的分布完全不同,平均值会掩盖这段。
- 分来源统计,某几个数据源的告警长期被整体压低,可能是字段缺失导致排序没有可用输入,而不是它们真的不重要。
- 阈值调整要有留痕:把阈值往下压一次,漏判数会怎么变,这个曲线应当在评审桌上摆出来,而不是等出事后再调。
- 给排到最低的那一档留一个抽检口子,按固定比例随机抽人复核,抽检结论回流到排序规则。
这一段的收益是真的,但收益的表达方式要说清楚:它不是”减少了多少告警”,而是”同样的人手能看住多大的量”,或者”同样的事件量需要的值守人数”。拿降噪率当唯一指标,最后多半会把真实事件降没。
四、可用面三:自然语言查询与取证辅助,判据是可复算
调查阶段用自然语言问”这台机器这三天登录过哪些异常账号”很省心,但它的风险直接:查出来的东西会被当成事实。判据因此只有一条——结果必须可复算。
- 每次自然语言查询要落两条东西:生成的等价原语句(或者等价的查询计划),以及命中记录的位置标识。没有这两条,这个结果不能进任何报告。
- 取证辅助的产出应该是”证据坐标”而不是”证据摘要”。摘要会让人停止往下查,坐标则把下一步交给工程师。
- 空结果要能区分”没有命中”和”查询没能执行完”,这两种情况用同一种表达是这类工具最坑的地方:一个调查人员因为超时得到的空结果,会当成”确实没有”写进结论。
- 跨来源的查询要有时间口径:不同系统的时钟基准、时区与采样粒度必须在结果里说明,两份记录差一点点是不是同一件事,取决于这个而不是取决于模型怎么想。
这三类可用面放在一起看,判据的差别一目了然:
| 可用面 | 唯一硬判据 | 不能作为验收依据的东西 |
|---|---|---|
| 归一化与富化 | 必需字段的漏字段率与错填率 | 生成文本是否通顺、格式是否漂亮 |
| 优先级排序与降噪 | 历史真实事件掉到阈值以下的比例 | 降噪率、看板上的告警条数下降 |
| 查询与取证辅助 | 结果能否用等价查询复算并定位到原始记录 | 一次问答看起来像不像专家回答 |
五、可动那一段:自动处置的准入条件只有三条
自动封禁、自动改配置是采购讨论里最抢眼的一段,也是验收最难的一段。我们的边界写得非常简单:**同时满足三条才允许自动化,缺一条一律退回”给建议”**。
- 可回滚:动作能在无人介入的情况下撤销,且撤销本身不需要审批链。
- 影响面可枚举:动作作用在哪些对象上,在动作发出前能完整列出来并给出数量级。封一个 IP 影响几个业务方,这件事必须事先算得出而不是事后复盘。
- 有人工兜底班次:这个动作触发后,存在一个明确的、被排班的、有权撤销它的人。没有当班的人,”可回滚”只是纸面能力。
三条都在的例子里,自动化才谈得上收益。任何一条不在,系统就应当只做建议,并且建议里要带上”如果要人工执行,需要哪几步”。把不可回滚的动作自动化,是把一次事故升级成一批事故的捷径。
六、误报要计价,不写进评分表就一定吵架
防守侧所有指标里最容易被省掉的是误报的成本。省掉的结果是一定吵架,而且吵架没有共同语言:算法侧说降噪效果很好,业务方说我被误封了一次花了半天恢复。两边说的都是真的,但没有任何一张表能把它们放在一起比。
两个口径就够,但要真的算:
- 内部人力分钟:一条误报从产生到关闭消耗的人力时间,包括安全工程师判断它、找人确认、写回复。按动作类型分开统计,因为”确认一个误封”和”确认一条低危告警”的耗时差得很远。
- 外部恢复时长:被误动作影响的业务方,从受影响恢复正常花了多久,以及这段时间是不是落在了业务高峰。
有了这两个数,自动化阈值、抽检比例、值守排班才有共同的分母,选型评分表里也必须有一栏是这两项,而且要由业务方而不是安全方填。洹拓给客户做这类评审时,把这条列为硬性评分项:没交误报成本口径的供应商,方案写得再好也扣掉一轮,因为后续所有争论都会落在这个口径缺失上。
回到”能不能扳回一城”这个问题:把模型放在可读与可判这两段,收益能在一个季度内被验收;把它放在可动那一段,收益取决于你是否愿意为每一次误动作计价。大多数团队卡住,不是因为模型不行,而是因为从没打算为误报付账。