
“点踩”被收起之后:显式反馈变少时排序读什么
一、显式负反馈是标注,动它就等于减少标注
有视频平台就”隐藏点踩按钮”的传闻澄清:并未对普通用户测试隐藏,只是换了个位置,并计划调整创作者查看自己数据的界面。评价它对谁的收入有影响不是本文的事,具体界面细节来源也没给。我们只取其中一条能普遍成立的工程含义:显式反馈,尤其是点踩这种负向显式反馈,本质上是用户免费替系统打的一份标注。显式负反馈本来就稀有,任何让它更难被给出的改动,第一后果不是”用户少点了一下”,而是排序模型能拿到的监督信号变薄了。
这件事值得每个做推荐、搜索、排序的同行读一遍,因为它的教训不依赖那个平台:反馈采集是一个有因变量的人机接口,控件位置、可见度、点击成本都会改变信号分布,而模型的指标口径常常假装这些不变。下面按三个层次把它拆开:先给现有信号排一个可信度的序,再说清位置为什么会污染这个序,最后给出显式变稀之后的补救和一条必须落地的治理动作。
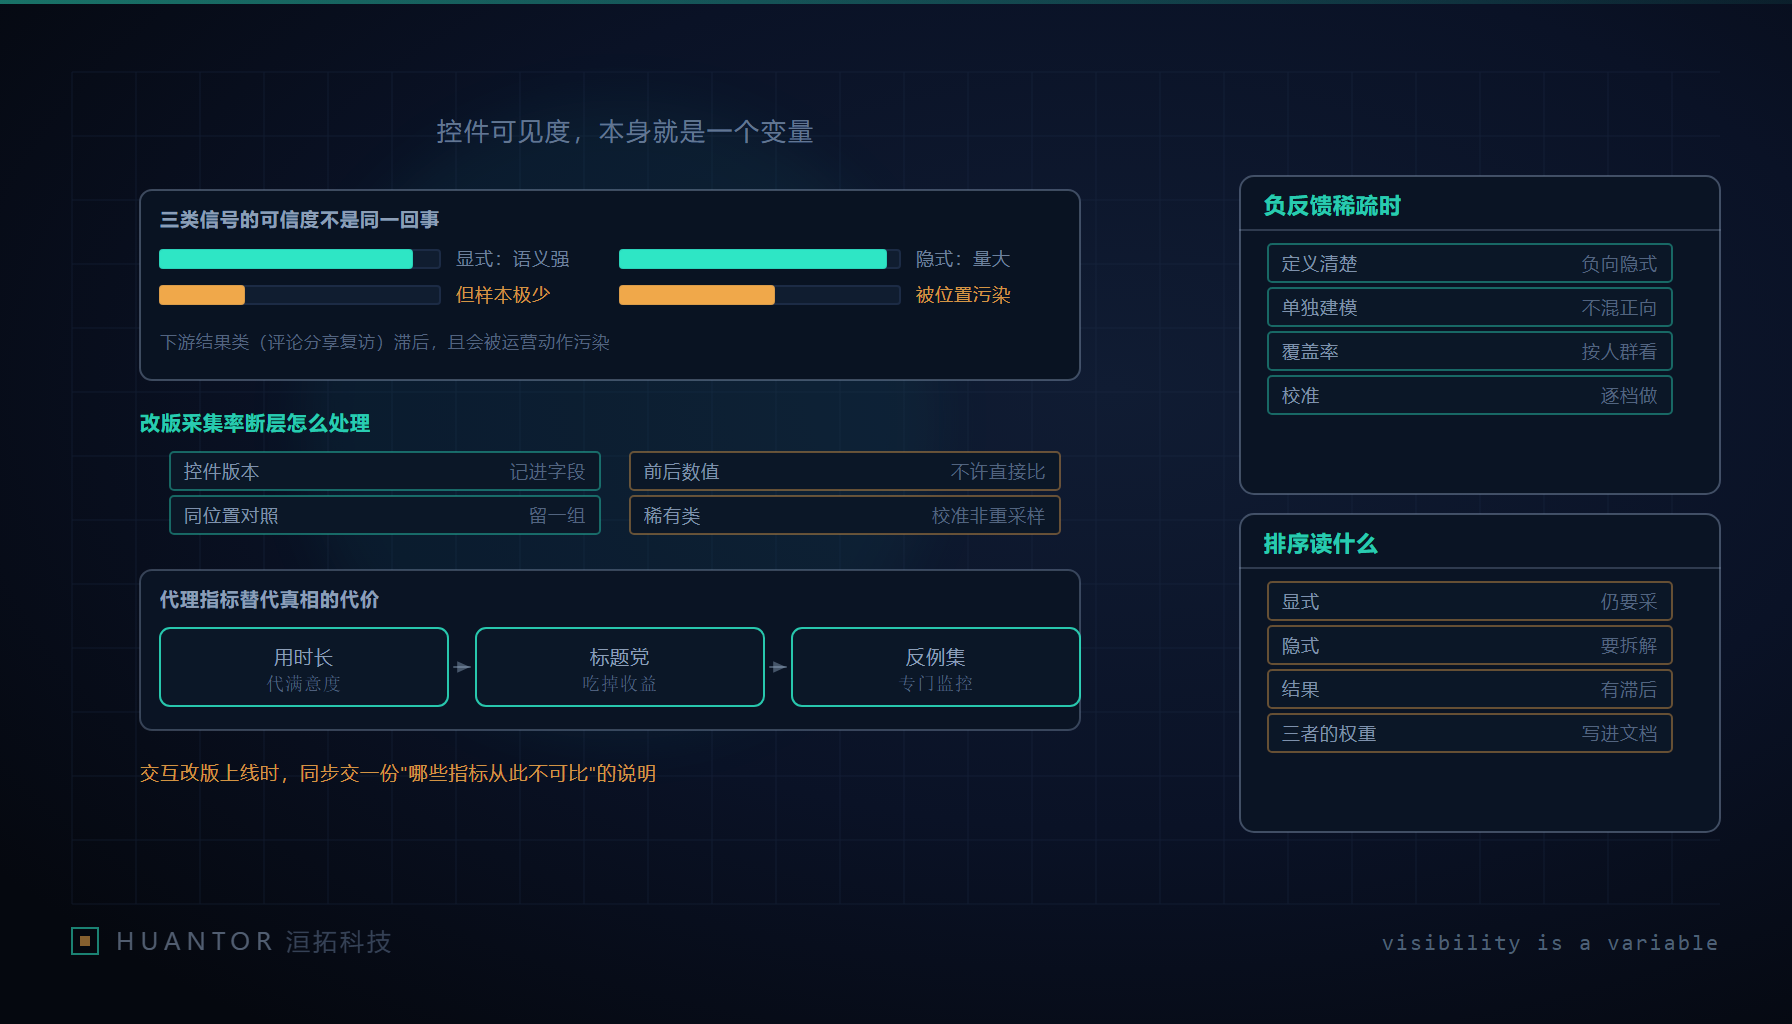
二、三类信号各有各的偏差,不能平铺着一起喂
排序能读的信号大致分三类,可信度不是平均分布的,偏差来源也各不相同。把它们平铺成一张”都是反馈”的清单直接加权,是最常见的错误。
- 显式点赞与点踩:样本稀少,但单条语义强、意图明确。它的偏差在于分布不是随机的——愿意主动点的人偏向情绪被激起的两端,也偏向少数高度活跃群体,点踩尤其容易被当成表达不满的出口,而不是”这条对我没价值”。用之前要清楚:它标记的是”想表态的人”,不是”全体观众”。
- 行为隐式:完播、回看、退出、跳过。量大、覆盖广,但被位置、时长和主题三重混淆。排在第一位的内容天然完播高,短内容天然完播高,这些和”喜不喜欢”没关系。跳过是最像负反馈的行为,却也最容易是”刷到了不相关”而非”反感”。
- 下游结果:评论、分享、复访。它最接近真实价值,但滞后、稀疏,而且极易被运营动作污染——一条置顶引导就能把评论数抬高,这不是内容质量的信号。
排序读哪一类,取决于你愿意为哪种偏差买单。我们要的口径是:显式负责”定方向”,行为负责”补密度”,下游负责”验证”,三者不能互相冒充。冒充的典型样子是拿完播率当满意度的替身去做全局排序,结果系统整体把”不容易划走”的内容顶上来,而用户对它的态度根本没被问过。判断一个信号能不能进模型,我们固定问三句:它是不是用户主动给的、它的采集条件改版前后稳不稳、它和要预测的目标之间隔了几层混淆。三句里有一问答不上来,就只能当弱信号降权用,不能当监督目标。
三、控件位置本身是一个变量,改版前后不能直接比数值
这是全文最该记住的一句:同一个点踩按钮,放在首屏和折叠进二级菜单,采集到的不是一种分布。可见度和点击成本直接改变采集率,位置一挪,负反馈的绝对量会掉,掉下去的那部分还不是”用户变满意了”,而是”懒得翻了”。所以任何改版前后拿点踩率做趋势对比,如果不加处理,就是把一个采集口径的变化误读成用户偏好的变化。
对策不是”别改版”,而是把控件版本当成一个正经字段管起来。上线时要在实验平台里记录这几项:
| 记录项 | 作用 |
|---|---|
| 控件版本与位置 | 让每条反馈都能回溯到它是在哪一版界面下采集的 |
| 同位置对照组 | 新旧界面并行时保留一组维持原位,用来量出”位置本身”造成的差 |
| 采集率基线 | 改版前先把该控件的单位曝光点击率存成基线 |
| 指标断点标记 | 在报表上明确标注”此处起口径不可比” |
有了同位置对照,才能把”下降里有多少是位置造成的、有多少是内容质量真的变了”这两件事分开。缺了这一步,你只会得到一个既无法归因也无法复用的数字,还会顺手把它当成一次”用户满意度提升”写进复盘,这是最坏的结局。
四、显式变稀之后,负向信号怎么补才不把代理当真相
点踩少了,负向监督变稀疏,常见的冲动是”那就用跳过、快速划走当负反馈”。方向对,但有两个坑。
第一,负向隐式信号要先定义清楚再单独建模,不能和正向混在一个”互动分”里。把”曝光后极短时间内退出”和”看完一半划走”当成同一件事,模型学到的其实是时长而不是反感。给稀有类别的正确处理是校准(calibration),即校正它输出的概率和真实比例对得上,而不是简单重采样把少数类硬拉成多数类——重采样会扭曲分布,让模型对”到底有多少人不喜欢”给出系统性偏高的答案。同时按人群分层看覆盖率:如果负反馈主要来自少数活跃用户,那么它对沉默大多数的外推是不可靠的,这一点要在评估里显式承认。
第二,代理指标替代真相是有代价的。用”停留时长”替代”满意度”看着合理,但停留时长会立刻被标题党和制造争议的封面吃掉,因为它们在短周期里就是能把人留住。每引入一个代理指标,都要配一个反例监控集:一批人眼确认”质量差但停留高”的样本,专门用来盯代理指标什么时候开始说谎。监控集本身也要版本化,否则它自己也会随内容池老化而失效。
五、一条治理动作:改版上线要同步交一份”哪些指标不可比”的说明
技术上的补救再多,也顶不住流程上没人打招呼。所以我们主张把一条治理动作固化进发布流程:任何改到反馈采集的交互改版上线时,必须同步向数据侧提交一份变更说明,写清动了哪个控件、位置怎么变、预计影响哪些指标的采集率、对照组怎么留、从哪个时间点起哪些指标跨版本不可比。这份说明不是给数据团队”求个情”,它是指标定义的版本记录——没有它,数据侧只能从曲线上看到一个”莫名下跌”,然后花两周去排查到底是不是内容出了问题。
这条动作对洹拓自己交付的推荐与搜索类项目是硬要求:口径变更和代码变更必须同批交付,谁先上线谁就制造一段不可解释的数据。说明里最容易漏的一项是”预计影响方向”——控件越难给负反馈,点踩率下降几乎是确定的,如果不提前写明,等数据团队看到下跌时,模型评估已经用这批被污染的负反馈重训了一轮,回滚代价比补写一份说明大得多。把这一步做扎实,显式反馈变少就不再是”排序突然看不懂用户了”,而是一次有对照、有版本、可归因的正常口径迁移。