
播放视频时黑屏几秒:驱动级回归的定位与回退基线
一、一条现象会跨三行日志
有一条消息值得当作定位案例来读:据公开报道,某显卡厂商承认其一个显示驱动版本存在缺陷,在浏览器与播放器播放视频时出现画面冻结或短暂黑屏,数秒后自行恢复且无需重启,边播放边启动游戏也会触发;系统事件查看器里能看到该驱动来源的事件记录,以及显示超时与崩溃恢复一类的内核事件;厂商在收集崩溃转储,用户回退到前一个版本后现象消失。具体版本号、型号与我们对任何厂商的评价都不在本篇范围。要谈的是这套现象背后的定位方法。
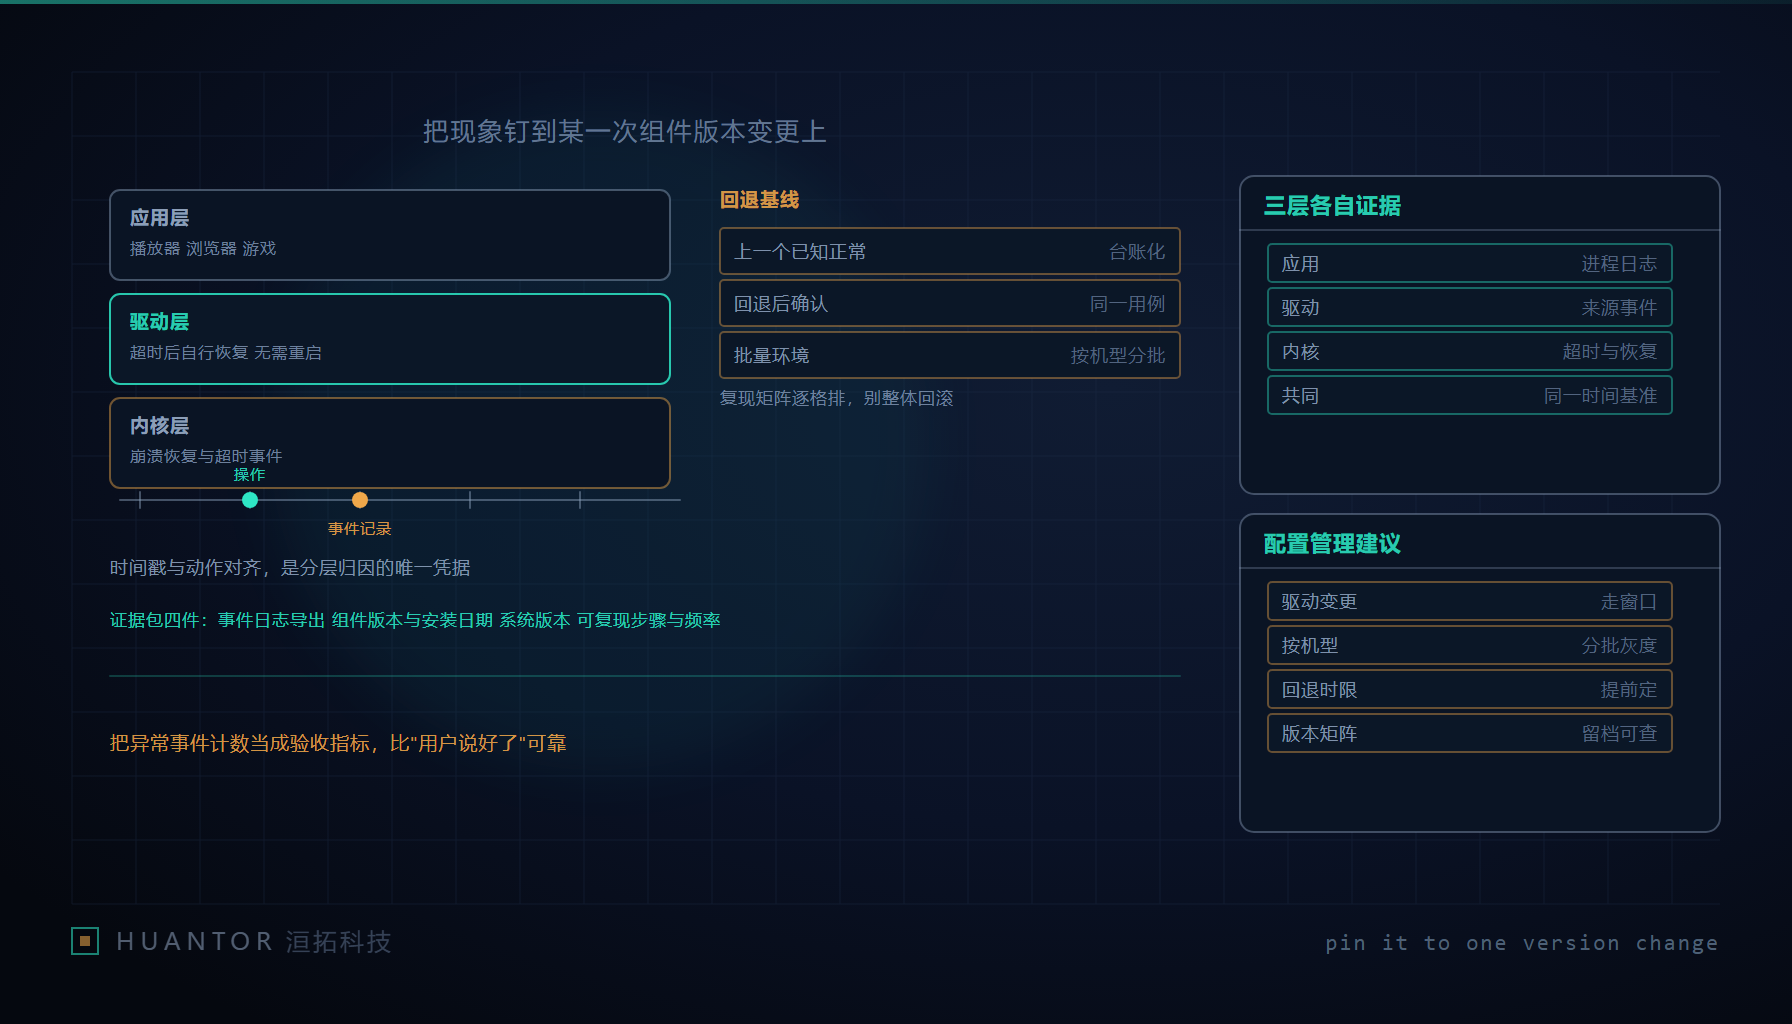
这类问题的难处在于它同时出现在三个层:用户看到的是浏览器里的画面坏了;应用日志里什么都没有;系统事件里却有一条带来源的记录。把它归给“应用不行”或者“系统坏了”都会走偏。我们的经验是,跨层定位靠三件东西,缺一件就会退化成重装系统试运气:能对齐的时间戳、带来源的事件记录,以及一份写着“上一个已知正常版本”的台账。第三件最常被忽略,因为它不属于某个故障,属于配置管理,而恰恰是它决定了你能不能在十分钟内回到可用状态。
二、核心交付物:现象、层级、可见证据与下一步动作
| 现象 | 最可能的层级 | 可见证据 | 下一步动作 |
|---|---|---|---|
| 画面冻结数秒后自行恢复,无需重启,应用进程还在 | 驱动级,内核超时恢复路径 | 系统事件里同一时刻有驱动来源的记录,伴随显示超时与恢复类事件 | 记录时刻,按来源过滤事件;比对组件版本变更时间 |
| 窗口消失、应用退出 | 应用级 | 应用自身崩溃日志、异常退出码 | 抓应用侧堆栈,与系统事件时间对齐 |
| 整机黑屏后需要重启才恢复 | 内核或硬件层 | 内核错误记录、意外关机记录、转储文件 | 采集转储与完整事件导出,先隔离负载再复现 |
| 只在播放视频时出现,静态页面无现象 | 解码与硬件加速通路 | 关闭硬件加速后现象消失的对照结果 | 建立开关对照矩阵,而不是整体回滚 |
| 播放并发其他图形负载时触发 | 资源争用与时序 | 事件频率与并发场景相关,同类记录成簇出现 | 列出并发组合逐格排除 |
| 回退一个版本后不再出现,升级又出现 | 版本回归 | 版本台账上两个版本的对应现象记录 | 冻结版本、把证据包提交给厂商并留追踪编号 |
表格里的第二行与第一行差别只在“进程是否还在”,但排查方向完全不同:自行恢复且进程健在,说明被重置的是图形子系统而不是应用;这类“秒级自恢复”的表现,指向的是超时后重置与恢复的机制,而不是崩溃。把这两类分开,能省下大量重装与清配置的时间。
三、事件记录的正确用法
事件查看器不是用来“看看有没有红叉”的。有效的用法有四条。
按来源过滤,而不是按时间扫。系统日志里噪声很多,把来源限定到显示驱动、显示相关服务与内核这几个,剩下的才有信息量。区分等级不等于区分严重性:警告级的记录重复出现,往往比一条孤立错误更能说明问题,因为规律性本身指向同一个通路。时间戳要与用户动作对齐,这就要求排查时先做一件事——把系统时间与记录用的时间源核对一遍,并准备一份动作时间的手写记录:“我开始播放”“画面冻住”“恢复”,这三行时间和日志对上,才能确认因果而不是巧合。同类事件要聚合看频率:单条记录说明不了什么,五分钟十条和一天一条是完全不同的问题,频率是后面判断阈值的依据。
还有一条容易被忽略的:要记录事件发生时的负载上下文。同一类事件在播放视频与在整机空闲时出现,指向的原因并不一样;不带上下文的日志只能证明“出过事”。
四、复现矩阵是逐格排除,不是整体回滚
这类问题的复现要按矩阵列,而不是靠反复点播放。我们通常用四个轴:软件与解码方式(浏览器与本地播放器、不同的容器与编码);硬件加速开关(开启与关闭各跑一遍,这是最有价值的一格对照);显示配置(显示器数量、分辨率与缩放组合);并发负载(同时运行图形密集型任务、后台是否有其它应用在用图形接口)。
矩阵的目的不是穷举,而是找到最小复现组合:能稳定触发的那一组条件,往往比任何解释都值钱。找到最小组合后,再单独把“加速开关”这一格翻掉一次,确认是通路相关而不是内容相关。整体回滚的问题在于它一次改了五个变量,即使现象消失,你也无法回答“下次升级还敢不敢装”。
最小复现要写成步骤:前置配置、操作顺序、发生概率、恢复方式。写不出这四件事的复现,到了支持渠道那边只会得到一句“请收集日志”。
五、回退基线、证据包与“厂商在收集转储”的含义
回退基线的核心是一份台账:每台机器上每个组件(显示驱动、固件、系统版本、关键运行库)都记一条“上一个已知正常版本”和它的安装日期,以及确认正常的依据。有了这份台账,回退是照表执行;没有它,回退是猜。回退之后要有确认动作,而不是“看起来好了”:按最小复现步骤重跑一遍,确认事件记录不再新增,并把回退前后版本号记进同一张单子里。批量环境里还要做两件事——版本锁定,避免自动更新把回退掉的版本又装回来;分批推进,回退后的稳定观察要先覆盖一个小组。
证据包的清单是固定的六项:事件日志导出(按相关来源过滤前后的完整版本)、转储文件(如果系统生成)、涉及组件的版本与安装日期、系统与内核版本、可复现步骤与发生频率、以及前面提到的手写动作时间。证据包要在现场收一次就收齐,不要指望事后补——事件记录会被轮转覆盖,复现条件也常常在下一次更新后改变。
“厂商在收集崩溃转储”这句话的含义要读准:它说明问题在受理,不说明已经定位,更不说明何时可用。中间的等待期对用户侧来说是不可用期,所以要留三样追踪信息:受理编号与提交内容的清单、可联系到人的渠道、以及本地锁定的版本状态(什么时候回退的、回退到哪个版本、什么条件下会再次升级)。这三样决定的是几周后你还能不能把这条线接上。
六、企业侧的配置管理,以及同一套路在移动端与云主机上的样子
个人用户靠临场排查,企业环境要靠流程。我们的建议是四条。驱动与固件变更走变更窗口,不允许在办公时间由更新程序自行推送;按机型分批而不是全量同时升,同一批里保留一定比例的观察机;把异常事件计数作为验收指标——升级后一段时间内某来源的事件新增数量与升级前基线比较,超过阈值即触发回退;约定回退时限,明确“多长时间内没能定位就回退”,避免问题卡在“正在分析”状态里出不来。这三条写进配置管理规范之后,此类问题的处理时间会明显缩短,因为决定变成了流程而不是临场判断。
同一套方法并不只适用于桌面。移动端要跑同样的逻辑:系统版本升级之后,特定应用的渲染或解码出现规律性异常时,先看系统侧日志中对应组件来源的记录,再确认是应用问题还是平台问题——移动平台上没有回退驱动的选项,可用手段是版本锁定与灰度开关,所以台账更重要。云主机上的等价场景是内核与驱动版本矩阵:镜像里预置的图形与网络驱动、客户侧应用版本、宿主机内核三者组合出来的兼容矩阵,任何一侧单独升级都可能引入新的回归。这类环境里最有价值的产物不是排查报告,而是一张“哪个组合验证过、哪个组合不能上”的矩阵表。
洹拓科技在给客户做终端与云环境的运维规范时,会把“每个组件都要有一个已知正常版本”当成一条基本要求。它听起来像多余的记录,但在跨层问题面前,它是唯一一个能让你在半夜做出正确决定的东西:不是猜哪里坏了,而是知道退回哪里是安全的。