
响应头赢了控制台:CDN 配置要按生效顺序排一遍
一、先排生效顺序,再谈配置项
内容分发这类服务最常见的故障不是配错,而是同一个值在两处都能配,而只有一处生效。缓存过期时间是典型:分发控制台上写的规则,会被源站响应里的 Cache-Control 盖过去。运维在控制台反复加规则、改数值、提交工单,页面行为一点没变,因为改动的那一层根本不参与最终决策。
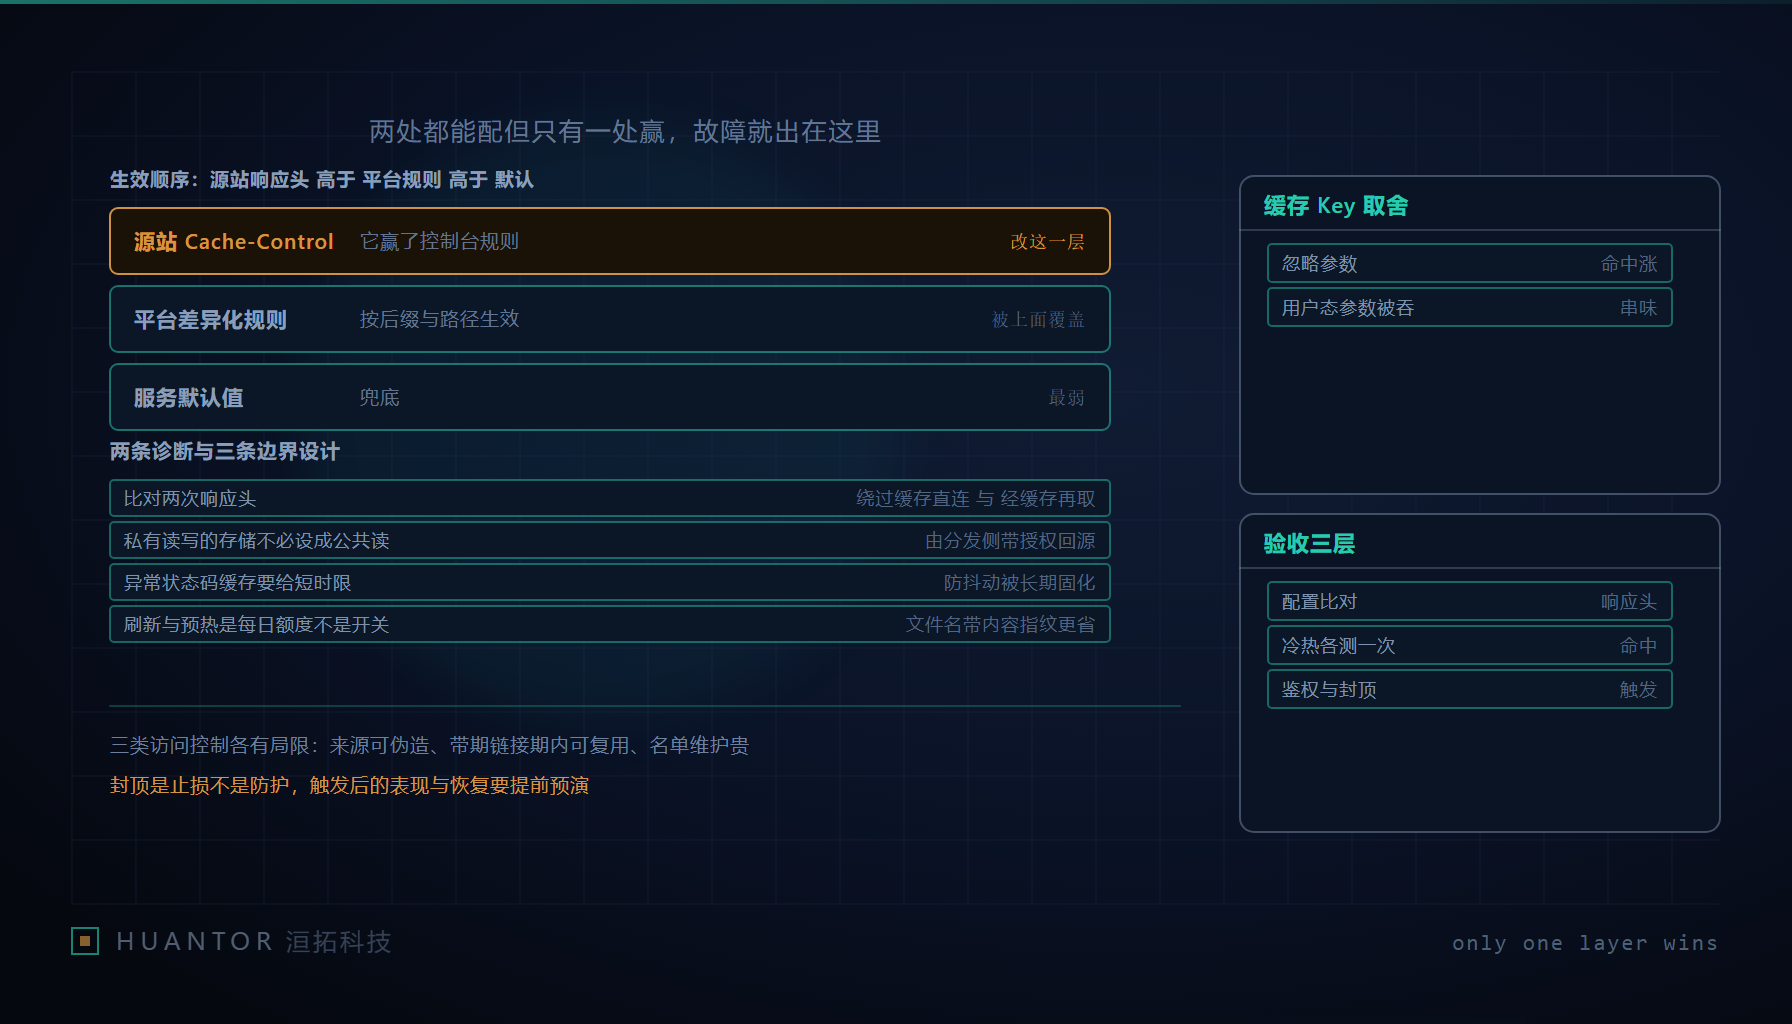
顺序要背下来:源站响应头优先于分发服务上的配置规则,两者都缺位时才落到服务默认值。诊断方法也因此是固定的两步,而不是凭感觉猜。
- 绕过缓存直连源站,取回一次响应头,记下缓存相关字段的原样。
- 经分发节点请求同一资源,再取一次响应头,逐字段比对。
- 两处一致且行为不符合预期,说明要改的是源站输出;两处不一致,说明分发层的规则或键设计在起作用。
第 3 步的结论很关键:不改响应头而在控制台反复加规则,属于典型错法。反过来说,把缓存策略写进源站响应头也不意味着分发层无事可做,差异化过期、键的构造、异常码处理这些仍然在分发侧。分工要写进交付文档,否则接手的人会按控制台的显示值来推断线上行为。
二、缓存 Key 决定命中率,也决定会不会串味
忽略 URL 参数能显著提升命中,因为它把同一资源的多种查询串合并成一份缓存。但合并是有代价的:如果参数里有用户态、语言、分组标识,把它们吞掉就等于让不同人拿到同一份响应——这是内容串味,不是性能问题,是正确性问题。
所以键策略要按路径和后缀分档,不做全局一刀切。
- 静态资源路径:图片、脚本、样式这类按后缀设长过期,参数可以直接忽略,因为它们的语义里不携带身份。
- 带渲染的页面路径:参数若参与生成,就不能忽略;确实要缓存,就把影响结果的那几个参数显式保留进键,其余剔除。
- 接口路径:默认不缓存,只对确认幂等且不随用户变化的读接口单独开。
至于用 Vary 头还是把用户差异显式写进键:Vary 把分组维度交给缓存层,命中会按维度数成倍分裂,运维上要接受容量与刷新成本;把身份参数并进键,逻辑直观,但每个新维度都要改一次配置。两种都不是免费的,选择依据是这个维度有多少取值——取值为二值或三的适合并进键,取值多的用 Vary 并限制组合。无论选哪种,都要确认分发侧真的透传了这个头,很多服务的透传需要显式声明。
三、异常码与大文件:两处容易被漏掉的策略
404 与 500 这类异常状态码应该被缓存,且 TTL 设得很短。理由有两层。一层是止损:源站抖动时,同一个不存在或报错的路径会被反复回源,等于让故障期间的流量把回源带宽和源站并发都吃满,雪上加霜。另一层是风险:错误一旦被长期缓存,源站已经恢复正常,用户仍然拿到一张错误页,而且此时排查线索是断的——节点上是命中,控制台看不到源站日志。
错误被缓存时的排查线索固定三条:响应里的命中与回源标识、资源在节点上的剩余存活时间、异常码自身的缓存规则。看到命中就直连源站比一次,如果源站已恢复而节点仍返回异常,就是异常码缓存在起作用。把 TTL 压到很短,是在止损与固化之间取的折中。
大文件与音视频是另一类。不分片回源,就意味着一次请求要拉完整个对象,任何一次网络中断都得从头再来,节点侧的等待与重试都会堆积。分片回源把请求切成区间,代价是缓存的粒度变了:区间请求要能落到同一份缓存上,否则每个偏移都算一个新键,命中率反而塌陷。所以分片策略要与键规则一起定,并在验收里覆盖断点续传与部分命中这两种情形——部分命中是命中率统计里最容易被漏算的一类,因为它一半新内容一半旧内容。
预热常被当成加速手段,实际作用是把回源压力前移。上线瞬时的高并发如果都靠回源承接,源站在最脆弱的时刻承受最大压力;预热把这部分需求提前摊平。前移就意味着它消耗真实资源,与刷新共用额度,这留到第六节说。
四、回源链路:主备、HOST、协议端口与请求头改写
回源段有四个配置点,每一个都能独立制造一次事故。
主备源站自动切换的前提是健康判定标准配得对。判定看什么、连续几次、超时多久,这三个值决定了切换是救急还是抖动。阈值过松,源站真出问题时不切;过紧,一次慢响应就触发切换,把备用侧压垮。这里要有意识的验收动作:人为让主源站不可用一次,观察切换发生与回切是否都符合预期,回切尤其容易被忽略,因为多数人只测切换方向。
自定义回源 HOST 在虚拟主机与多域名共享源站的场景里不是可选项。源站按域名路由,分发侧带错主机名,回源就拿到默认站点或错误页,而用户在分发域名上看到的现象是无法稳定复现的,因为部分路径可能恰好能命中。
回源协议与端口要和源站实际监听一致。这里最坏的情况是循环回源:分发域名的回源目标被写成自身或同层的另一分发入口,请求在链路里绕圈,最终表现为超时而不是明确错误。排查时看回源目标解析出来的地址是否落在自己名下,这一步能立刻定位。
回源请求头改写用于携带内部鉴权,让源站只接受来自分发侧的请求。要点是这条鉴权值本身要能轮换,且改写的头不能透传到浏览器侧。源站只信任带签的请求,这个边界成立之后,第五节的桶权限问题就基本消失了。
五、私有回源与三类访问控制:别用放宽权限来解决问题
源站是私有读写对象存储时,把桶改成公共读是常见但错误的解法。它把存储侧的鉴权整层撤掉,任何知道路径的人都能直连访问,攻击面从一条分发链路扩大到存储域名本身。正确解法是私有回源授权:由分发服务在回源时自动携带签名,桶保持私有,权限判断留在请求级而不是资源级。这一条属于边界设计的原则——遇到问题先看能不能在不放宽权限的前提下解决,而不是先问怎么让权限检查闭嘴。
顺带把两条访问路径的差异说清楚。对象存储外网直连与经分发服务,是两套不同的计费与访问面:直连少一跳,但存储侧的外网流出、请求次数各自记账,且每个对象都可被独立寻址;经分发则多一层缓存与鉴权边界,账单里会出现回源流量与分发流量两个不同名目。有资料称分发侧单价比存储外网流出更低,这是文档口径,不构成本篇的结论——要判断成本,就按自己账单里的分发流量、回源流量、请求次数、存储流出四项分别拉一遍,很多看似便宜的结论会在结构对比里翻掉。
三类访问控制各有适用与局限。
| 手段 | 解决什么 | 局限 | 工程上要额外做的 |
|---|---|---|---|
| Referer 白名单 | 挡掉无来源的批量盗用,成本极低 | 来源头可由客户端伪造,挡不住非浏览器请求 | 只当降噪,不当防护;配一条真被绕过的观察项 |
| URL 鉴权 | 给链接加签名与过期时间,缺失返回拒绝 | 有效期内泄露的链接仍可复用 | 配一次一签与设备或网络绑定,才能对单用户泄露生效 |
| IP 黑白名单 | 处理已知来源的集中滥用 | 维护成本高,移动网络出口地址经常变 | 定清单归属与过期时间,避免名单只增不减 |
带宽封顶不是防护,是止损。触发后表现为限流或直接拒绝服务,影响的是全部用户,而不只是异常来源,所以必须预演两件事:触发时业务侧看到什么现象,恢复条件是什么、由谁确认恢复。没有预演过的封顶,等于给自己埋了一个不可预期的自主断路器。
六、把刷新与预热当预算管,把验收分成三层
刷新与预热各有每日任务额度,这是运维预算而不是免费按钮。最该戒掉的动作是发版后全站刷新:额度被一次性消耗,缓存集体失效后的瞬时回源压力全部砸回源站,命中率在这一时刻塌陷,而这些后果都要靠别人来承担。
替代做法是把缓存长期化,让刷新退居应急。
- 静态资源文件名带内容指纹,内容一变文件名就变,旧文件可以放心设长过期,浏览器与节点都不用刷。
- 引用关系由构建产出,HTML 或清单文件本身设短过期或协商缓存,其余一律长缓存。
- 刷新只用于紧急撤错与合规下架,并记录工单号、影响路径与执行人。
- 额度用尽时要有应急预案与审批口径:谁能批、批什么、临时降级走哪条路径,事先写在预案里而不是当场讨论。
协议层要单独验一次。关掉老旧的 TLS 套件是应当做的,但它会立刻暴露还在用老协议栈的客户端,包括一些嵌入设备与老旧浏览器;这类兼容问题在测试环境里看不到,因为测试机都够新。兼容 HTTP/3 与 QUIC 同理:某些网络路径上不通是真实存在的,回退表现必须实测而不是假定。验收动作按三层展开,逐层留证据。
- 配置层:抓取源站直连与经节点两条响应头做逐字段比对,确认改动落在生效的那一层。
- 命中层:分别测冷请求与热请求,含大文件的区间请求与部分命中,确认键策略符合预期。
- 安全层:构造缺失鉴权参数、鉴权过期、来源头伪造、名单内外来源这几类请求,确认各自的返回符合约定;封顶触发与恢复要单独演练一次。
这三层的顺序不能颠倒。洹拓在给客户做分发链路梳理时,遇到最多的是只做了第三层就宣布上线的系统——鉴权配好了,但没人比对过响应头,于是控制台上的过期时间从一开始就没生效过。生效顺序这件事,说到底不是功能问题,而是谁来负责确认改动落到了哪一层。