
会自己改学习规则的模型开源了:复现它先要锁住四个可变量
一、跑通和能比较是两件事
据公开报道,有团队开源了一个能自行修改学习规则的视觉骨干网络,思路取自人观察陌生事物的过程,公开后短时间内聚集了大量关注。仓库热度和各类名次我们不当作能力证据,它们衡量的是传播不是正确;至于它内部如何改写规则,报道没有给出细节,我们也不做猜测。这篇只谈工程问题:复现这类训练过程本身可变的工作,和在固定架构上跑一遍训练,完全不是一回事。
普通模型的复现,失败原因通常能收敛到环境、数据、随机性三类,逐项排查总能对上某个解释。而当学习规则会在训练中被模型自己改写,两次运行之间就多出了一个不受你控制的变量:同一份代码、同一个种子,规则被改写的时机也可能不同,网络沿着两条不同的路径演化下去。这时可复现的定义要收紧,不是能把训练跑起来,而是两次跑出的结果可以被证明处在同一条演化路径上、因此可以比较。复现开工之前,先把可比的条件定下来,比急着跑第一轮重要得多。对做交付的我们来说,这件事还有一层现实含义:客户验收时问的是你给我的模型和论文里那个是不是同一个东西,回答这个问题靠的是记录,不是运气。
二、四个传统可变量,加一本新账
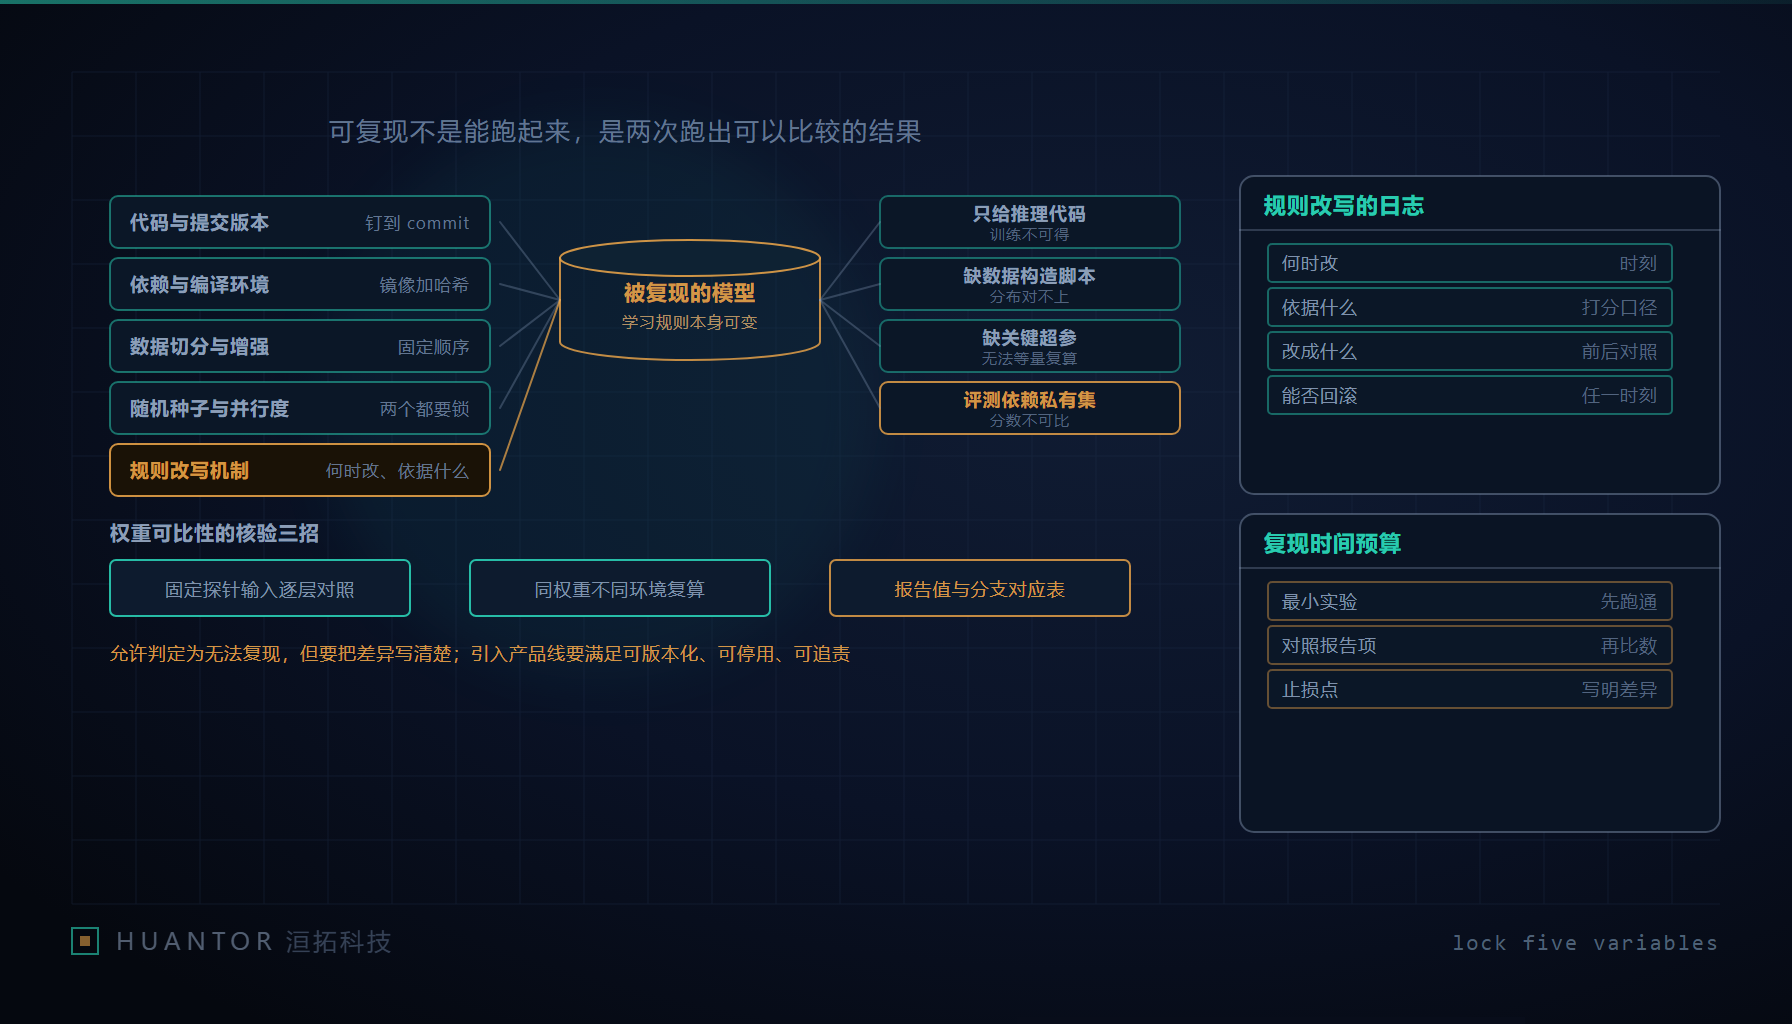
标题里说的四个可变量,是传统深度学习复现的账:代码、环境、数据、随机性。这类工作在这四样之外追加了第五项,规则改写的产生与记录。五项都要锁,缺任何一项,后面的对比都失去意义。
| 可变量 | 漂移方式 | 锁定做法 | 留证形态 |
|---|---|---|---|
| 代码与提交版本 | 主分支每天都在动,示例代码与发布版不一致 | 钉死到具体提交号,子模块一并固定 | 提交号写入每条实验记录 |
| 依赖与编译环境 | 换一种显卡、升级一个次版本都会改数值结果 | 依赖锁文件加容器镜像加编译选项全记录 | 环境指纹哈希 |
| 数据切分与增强顺序 | 增强流水线的先后顺序改变实际喂入的样本流 | 切分文件固化并记哈希,增强顺序纳入种子体系 | 切分哈希与顺序说明 |
| 随机种子与并行度 | 并行度改变梯度累积顺序,结果随之变化 | 分层记录种子,声明并行规模与批大小 | 训练配置全文存档 |
| 规则改写机制 | 何时改写取决于训练过程中的动态评分 | 改写事件全量落日志,评分口径固定不变 | 规则时间线文件 |
我们在给客户做模型研发的复现实验时,前四项的检查清单早已是标准动作,第五项是这类新工作逼出来的新要求。它难在无法完全外置锁定:改写时机由训练动态决定,你能锁的是它的记录是否完备,而不是让它不发生。
三、改写事件要成为日志里的一等对象
规则可变带来最直接的审计问题:训完的模型里,学习规则已经不是当初写下的那一条,你无法只靠代码仓库回答它是按什么规则学出来的。日志至少要满足四条。何时改:每一次改写发生在训练的哪个时刻,用步数与样本位置双重定位。依据什么改:驱动改写的评分是什么、当时的读数是多少。改成什么:新旧规则的全文对照都要存下来,只存新规则等于无法复算决策过程。能不能回滚:取出任一时刻的规则版本,应当能重建当时的训练状态。第四条最检验工程成色,只记录改了、不记录改前是什么的日志,等于没有日志。补充一点:规则改写日志无法用代码差异替代。代码仓库记录的是人写下的规则,而这类工作里生效的规则是训练中产生的,仓库里永远看不到它,改写事件日志是唯一的原始凭证,事后从结果反推等于重新做一次实验。
四、权重可比性的三项核验
复现出权重不等于复现出结论,可比性要主动核验,我们建议做三件事。第一,固定探针输入:准备一组不进训练集的探针样本,把复现权重与官方发布权重的逐层输出做对照,看差异的分布层在哪里,这比只比最终精度诚实得多。第二,同权重换环境复算:同一份权重在量化前后、并行度前后各算一遍评测,把环境造成的差和训练造成的差拆开,否则两个来源的差异会混在一个数字里。第三,报告数值与代码分支的对应表:论文或说明里的每个数字,对应哪个提交、哪套配置、哪个评测集,逐项对上;对不上的数字,降级为未能核实的宣称,不参与结论。
五、开源可用的四个常见缺口
热度再高,开源仓库的实际可用性通常绕不开四类缺口:只给推理代码不给训练代码,权重能跑但训练过程无法复算;缺数据构造脚本,论文描述的流水线只能凭文字重建,重建出来的数据和原始数据不是一回事;缺关键超参,那些不影响讲故事的参数往往恰好决定复现成败;缺评测脚本,或评测依赖作者私有的数据集,报告数字无法在本地重算。开工前先把缺口盘点清楚,每个缺口都意味着一段重建工作量,盘点结果应当原文写进复现报告的缺口与假设一节,让读者知道哪些部分是照做的、哪些部分是我们替作者补的。要提醒的是,靠重建跑出来的结果严格说不是复现,是仿制,结论必须和原样复现分开表述,不能混在一张表里。
六、复现预算、失败记录与上线前三条硬约束
时间预算建议分三段:先用小模型小数据跑通最小实验,验证的是管道不是效果;再对照论文报告项逐条复算;最后留出判定时间。要允许判定结果为无法复现,这不是失败,没写清差异才是失败。复现失败时的记录要固化成字段。
| 记录字段 | 写什么 |
|---|---|
| 差异现象 | 哪个报告项对不上、差多少、在什么条件下观察到 |
| 环境指纹 | 提交号、依赖锁哈希、硬件型号与并行度全文 |
| 尝试变量 | 逐项改动与对应读数,排除过哪些解释 |
| 结论定性 | 缺口导致、机制不明导致,还是数值噪声导致 |
最后是把这类可变训练机制引入产品线之前的三条硬约束:可版本化,规则每一次改写都有独立版本号,能指认线上模型用的是哪一条规则;可停用,改写的开关必须真的能关掉,而不是名义上可关;可追责,任何一次改写都能对应到日志与代码路径,出问题时说得清整个过程。三条里有一条做不到,这类机制就只适合留在实验环境里继续观察。洹拓把这份记录字段表当作研发复盘的固定模板,新项目从第一次复现实验就开始填,而不是等到出了差异再补记。