
分支已经停止安全更新:这时讨论“打完补丁”没有意义
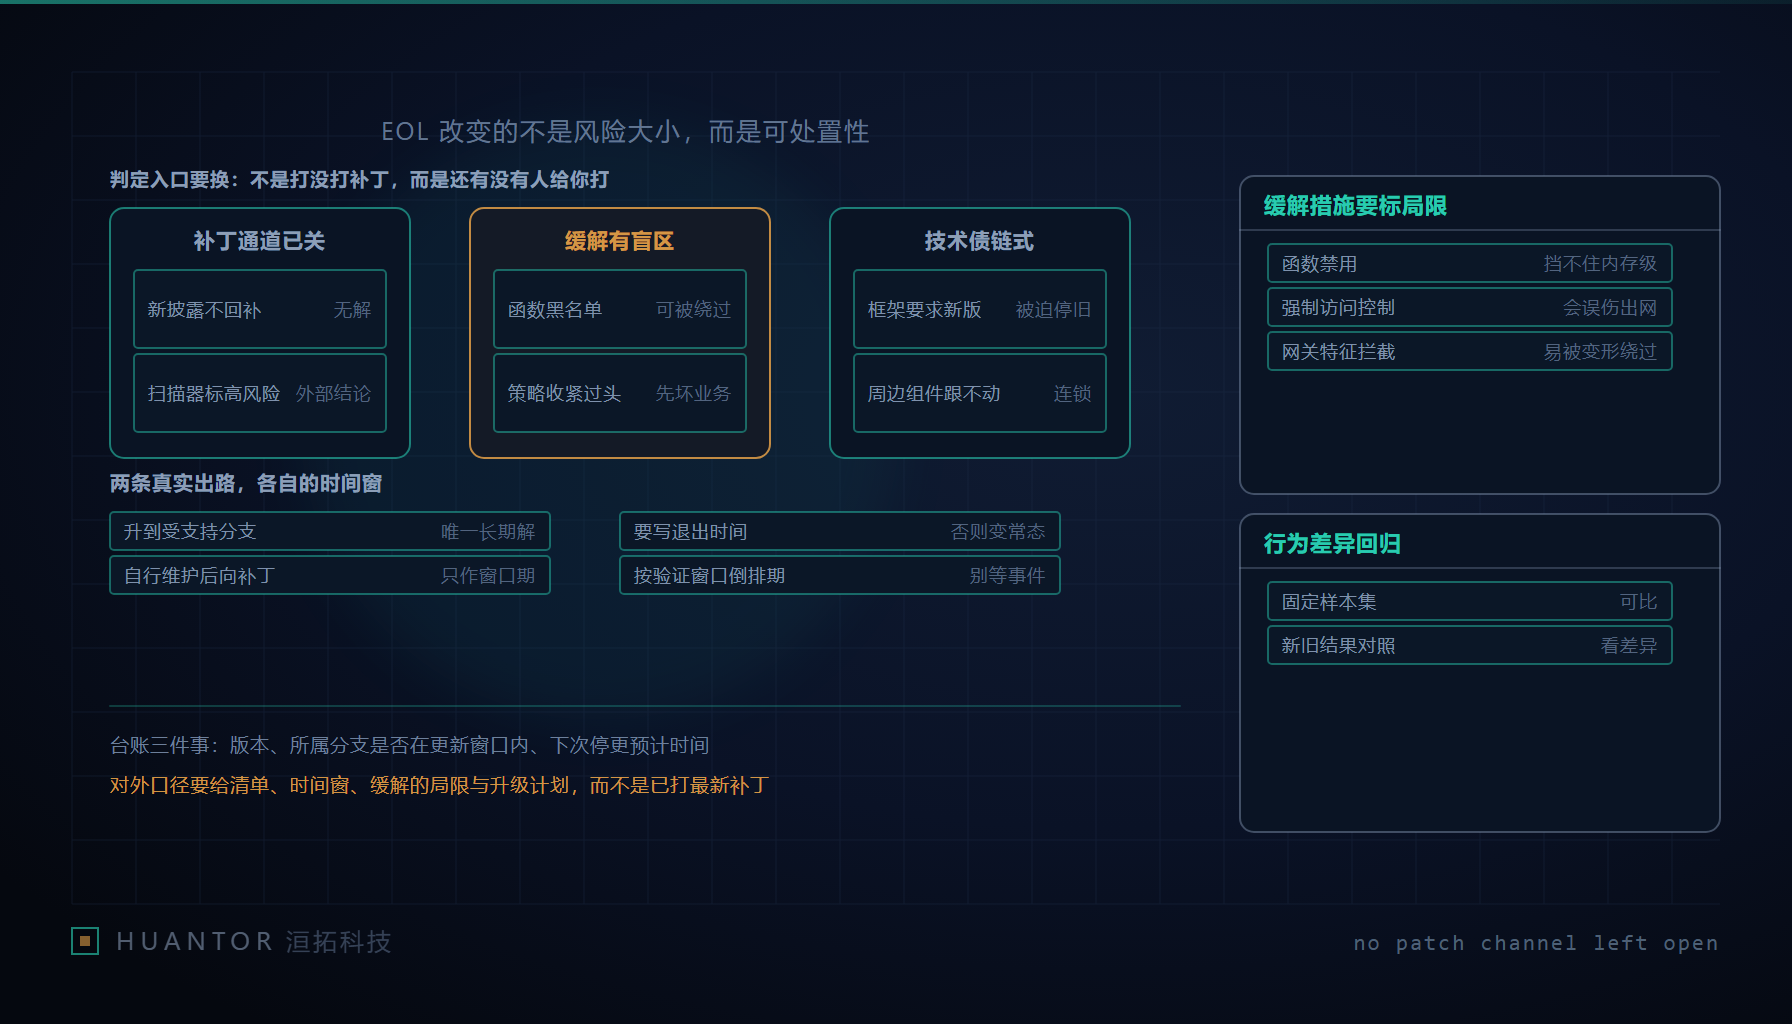
一份分析把话说到了一件不太好听的事上:某个仍被大量部署的运行时分支,早已不在官方安全更新范围内。它指的是 PHP 8.1 这一分支已经进入 EOL,而这次公开的两个高危远程执行类漏洞,只对仍在支持的 8.2 至 8.5 四个分支出了补丁,具体补丁版本以官方发布为准。也就是说,停在更早分支上的那些版本,无论做多少轮加固,都不存在“把这次补丁打完”这个选项。分支停止安全更新改变的不是风险大小,而是可处置性——补丁通道关掉之后,剩下的是隔离、收缩暴露面和升级三条路,而这三条都要预算和窗口。判定入口因此得换:从“打没打补丁”换成“还有没有人给你打”。
一、台账要记的三件事,把“有没有补丁”单列出来
多数资产台账只记到版本号,这就够不上做判断。至少三件事必须成文:组件版本、该版本所属分支是否仍在安全更新窗口内、下一次停止安全更新的预计时间。第三项最常被漏,因为它今天还“有效”,但停止更新的时间是官方公开排期,属于可预知事件;把它写进台账,风险评级才有一个随时间变化的触发条件,而不是等漏洞通报来了才回头查。
在此之上,把“是否存在可用补丁”从综合风险评级里单列成一个字段。原因是这两件事的处置路径完全不同:有补丁时,动作是排窗口、打补丁、验证;没有补丁时,动作是限制暴露面、决定升级还是自行维护、以及对外怎么讲。混在一个“高危”里,就会得出“已处理”的错误结论——补丁装上去了,但装的是给别的分支出的补丁,或者干脆没有可用的包。
二、扫描器把你的分支标成高风险,不是误报问题
部分主流漏洞扫描器已经把这类停止安全更新的分支默认标成高风险组件。这件事的分量比看上去重:客户侧的安全评估、审计侧的合规检查、供应链侧的准入门槛,都会拿同一份扫描结论对待你交付的系统。你无法用“这一条是版本策略问题不是漏洞”去申诉,因为结论的来源不是某一条具体缺陷,而是“这个组件此后不会再收到修复”。
应对方式不是去解释扫描规则,而是把这份结论当成沟通起点:在交付材料里主动给出该组件的支持窗口状态、你打算用什么方式承接风险、以及升级计划。被动等人问到再解释,通常会被记成一项整改;主动写明,则是一个可跟踪的已知项。这两者在同一份报告里的处理路径差别很大。
三、缓解措施要按“可绕过性”分级评估
常见的临时缓解有四类,每一类能挡什么、挡不住什么、收紧过头先坏哪件业务,都得成文,否则“上了缓解”会被当成“风险已消”。
| 缓解层级 | 典型做法 | 能覆盖的面 | 局限 | 收紧过头时先出问题的动作 |
|---|---|---|---|---|
| 函数级禁用 | 在配置里关掉命令执行类函数 | 直接调用该函数的路径 | 内核级缺陷可借运行时内部机制达成执行,不经过被禁函数 | 依赖这些函数的合法任务与报表导出 |
| 强制访问控制 | 限制 Web 服务进程调用解释器与 shell | 进程能派生什么 | 策略写得过宽等于没写,过窄则打断正常功能 | 插件更新、对外发信、需要出网的回调 |
| 网关特征拦截 | 按请求体标记拦截 | 已知特征的流量 | 特征依赖,变形后不再匹配;对加密与内部东西向流量无效 | 长请求体的正常提交 |
| 网络分段与最小暴露 | 只放开必要端口与来源 | 可达面 | 不改变组件本身的缺陷,只改变谁能够到它 | 跨系统的运维通道与备份链路 |
分级评估的意思是:给每一项缓解标注它依赖的前提,前提一旦被破坏它就失效。函数级禁用挡不住不经过被禁函数的执行路径,这时真正兜底的是分段与暴露面收缩。另外必须单独验证那几件“需要出网”的业务:插件更新、对外发信、第三方回调。这些功能在收紧访问控制后最先失败,而失败通常在上线之后才被发现。
四、“没有补丁”的两条真实出路
第一条是升级到受支持的分支。第二条是自行维护:接受后向补丁并自己承担可维护性评估。第二条要写清退出时间。后向补丁通常只能作为窗口期方案——它要求你有人能读上游改动、能构建、能在每次新披露时重新判断是否适用,这套能力一旦断人,组件就落到“只有你知道它被改过”的状态,审计与接手成本都会反弹。
判断能不能走自行维护,看三件事:改动是否集中在少量文件、是否与你自己的代码有交叉依赖、上游同类改动有没有可对齐的版本轨迹。三条里有一条不成立,就应当把资源投向升级排期,而不是继续加缓解层。
五、为什么停止更新之后升级反而更难
EOL 时点上升级变难,不是因为版本差得远,而是三件攒了很久的东西一起到期。周边框架与扩展对运行时的最低版本要求已经变了,你可能需要同时换框架次版本;迁移与验证被压缩成一次紧急动作,本来该分两轮做的事挤在一轮;旧分支上积累的兼容代码——针对宽松编码处理写的判断、依赖已废弃但仍在静默执行的过滤函数的那部分逻辑——到这时才集中暴露。
行为差异这一类风险尤其容易被漏。更宽松的非法编码处理会让前端的过滤假设不再成立;非严格模式下编码声明被忽略,使宽字节类问题残留在数据里;已废弃的函数仍在执行但不再起作用;类型与返回值的严格化让过去能吞掉错误的写法变成异常。这些都不会以“报错”的形式通知你。处置方式是用静态检查加一组固定的回归样本,在新旧两套行为下对比输出,把差异列成清单逐条判定,而不是只看流程跑不跑得过。
提前排期的判据应当是倒推而不是事件驱动:把一次升级所需的验证窗口、周边组件跟进窗口、业务变更冻结期叠起来,得到从“决定要升”到“能上线”的总时长,再要求排期起点不晚于剩余支持窗口减去这个总时长。事件驱动的排期永远在紧急状态里做,质量必然打折。
六、五条线的支持窗口,与对外的沟通口径
技术债是链式失效的。运行时、框架、扩展、依赖库、部署工具这五条线都各有支持窗口,必须放在同一张表上,因为最窄的那一条决定这套东西的实际可维护期。洹拓在给客户整理交付物时,把这张表当成必交件之一,字段包括:组件与版本、所属分支、更新窗口状态、停止安全更新的预计时间、受它约束的上层组件、替代计划与责任方。只记运行时的表,会给出一个过于乐观的结论。
对外沟通的口径也要提前定。客户问到“这个 EOL 组件怎么处理”,要给的是一份结构化的回答:当前状态与影响面的清单、时间窗、已经上的临时缓解以及它们的局限、升级计划与里程碑。不能给的是一句“补丁已经打过了”——在一个没有补丁可用的分支上,这句话要么不真,要么答非所问。把“可处置性”讲清楚,比把“风险等级”讲轻更要紧:前者是客户可以和你一起排动作的东西,后者只是同一份事实的另一种说法。