
医疗设备售后 AI 客服:SaaS 还是私有化,先按场景拆开再选
一、这不是二选一,而是一张场景清单
很多厂商在立项时把问题写成”要不要私有化”,结果要么被销售话术推着做全量私有部署,要么图省事整体搬上云,两种都容易在上线之后返工。真正需要先做的,是把 AI 客服要承担的任务逐条列出来,再判断每一条能不能在外部环境里跑。
分界其实不模糊。只依赖公开文档和标准政策的知识问答、故障现象初判、保修政策查询、报修入口指引,这些内容本身对外可披露,放云端不增加额外风险。一旦要读到工单系统、备件库存、远程诊断记录、客户设备档案,性质就变了:这些库里通常带着设备的安装位置、运行配置、维修历史,也可能带着终端使用者相关信息。同一套客服系统里,这两类请求的部署约束往往并不一致,把它们揉进一个结论里讨论,才是选型失败的根源。
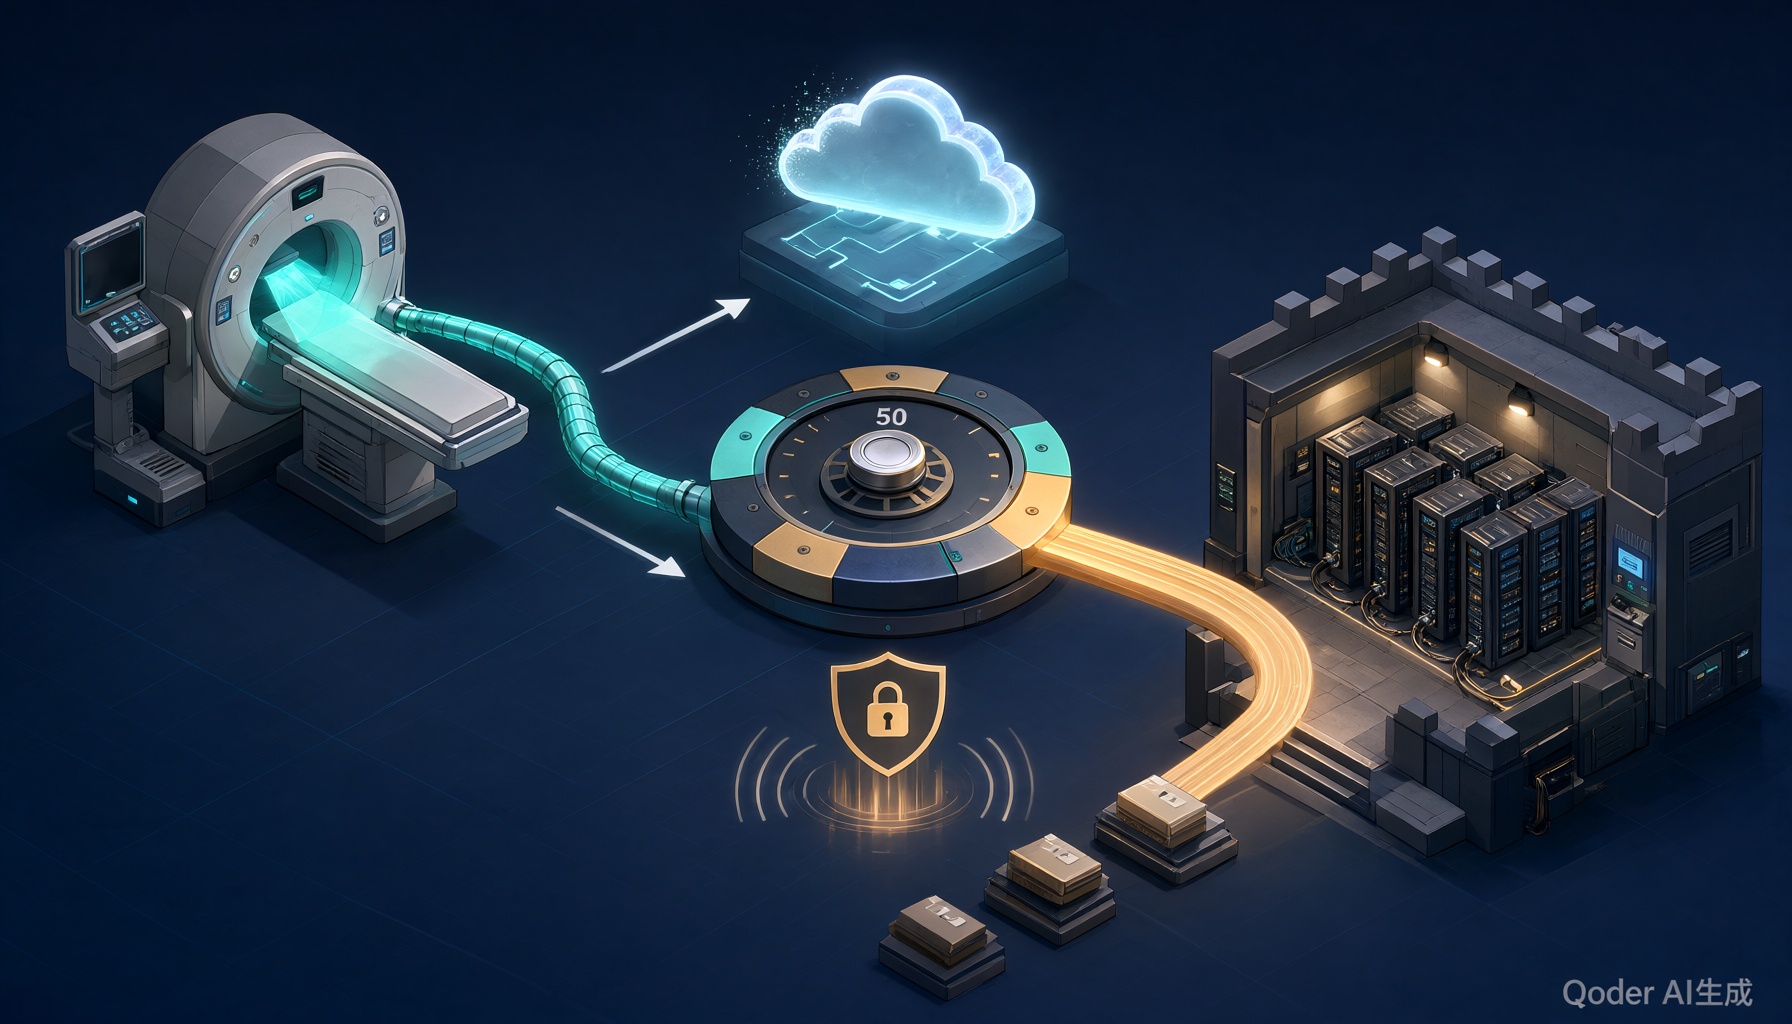
二、四条判据,逐条问自己
判据一,数据敏感度。别问”我们数据敏不敏感”,要问”这次请求经过的字段里,有没有个人信息、患者相关信息、设备位置与配置”。只要有,就得给出这些数据离开内网之后的处置说明;说明写不清楚,就默认按敏感处理。
判据二,与业务系统的连接深度。只读一个知识库,和需要调用内部业务系统接口,是两个量级。读操作暴露的是信息边界,写操作(建工单、改派工、更新设备档案)意味着把内部系统的凭证交给客服平台,风险从”能看到什么”变成”能改成什么”。
判据三,AI 可执行权限的大小。如果 AI 只负责回答,答错了人还能兜住;如果 AI 直接执行动作,就必须配套权限分级、操作范围白名单和可回滚路径。权限每上一档,选型就往可控环境偏一格。
判据四,企业自身的 IT 运维能力。这一条最常被低估。私有化不是买断就结束:模型版本更新、推理算力保障、监控告警、故障响应、知识库同步,都需要有人长期负责。确实存在这样一类机构,买了私有化之后由一名兼职人员接住,最后系统在线但没人敢改,功能停在交付那天。
三、中间形态常常比两端更实用
真正做下来的厂商,多数落在混合形态上:推理放在本地或自有环境,知识库按敏感级分层,非敏感的公开资料走云端托管与更新,敏感的档案与工单数据留在内网,只对内网服务暴露。另一种切法是按功能降级——联网时启用完整能力,断网或凭证失效时退回离线知识问答,至少不影响一线工程师查手册和走报修流程。
选哪一端,关键不在于预算多少,而在于能不能接受改造周期与架构复杂度。混合形态要维护两套环境和一条同步链路,代价是链路的日常维护;纯 SaaS 省掉了这部分,代价是能力上限由供应商的接口开放程度决定。这两笔账都要在选型阶段摊开算,不能只比单价。
四、洹拓视角:判断表与采购前必问的六个问题
四列判据对三种形态的适配,建议按下表逐项对照,看当前场景整体落在哪一列,而不是任何一条不满足就一票否决。
| 判据 | SaaS | 混合 | 私有化 |
|---|---|---|---|
| 数据敏感度 | 低:仅公开文档与保修政策 | 中:敏感字段不出内网 | 高:全量数据留在自有环境 |
| 系统连接深度 | 只读知识库 | 内部系统以只读为主,写操作受控 | 可读写核心业务系统 |
| AI 执行权限 | 只答不做 | 回答加受控提交,动作需人工确认 | 可建工单、改派工,全程留痕 |
| IT 运维能力 | 无自建运维也能运行 | 需要专人维护同步链路与监控 | 需要专职团队负责模型与算力 |
其中运维能力这一行是决定性的:没有稳定运维却选了私有化,一年后的实际交付质量通常比 SaaS 更差。
采购前建议以书面形式问供应商六个问题,并把回答放进合同附件。
- 我方会话与文档数据的留存周期是多久,服务结束后如何删除,能否出具删除凭证。
- 是否使用我方数据训练通用模型或行业模型,该开关能否单独关闭,默认状态是哪一档。
- 模型与方案的版本号如何标识,效果出现退化时能否回滚,回滚需要多长流程。
- 审计日志的粒度到什么层级:会话级、接口调用级还是数据字段级,保留多长时间,谁能查看。
- 断网或云端不可用时,系统能降到哪些功能,哪些功能完全停用,降级是否需要人工配置。
- 私有化交付之后运维责任边界怎么划:模型更新、算力扩容、故障响应分别由谁负责,响应时限是多少,费用如何计。
这六个问题的答案,比任何一份产品白皮书都更能预测一年后的使用体验。答得含糊的供应商,通常意味着这些能力确实不存在。