
两层服务之间的 socket 路径:升级后 502 最先对不上的就是这一行
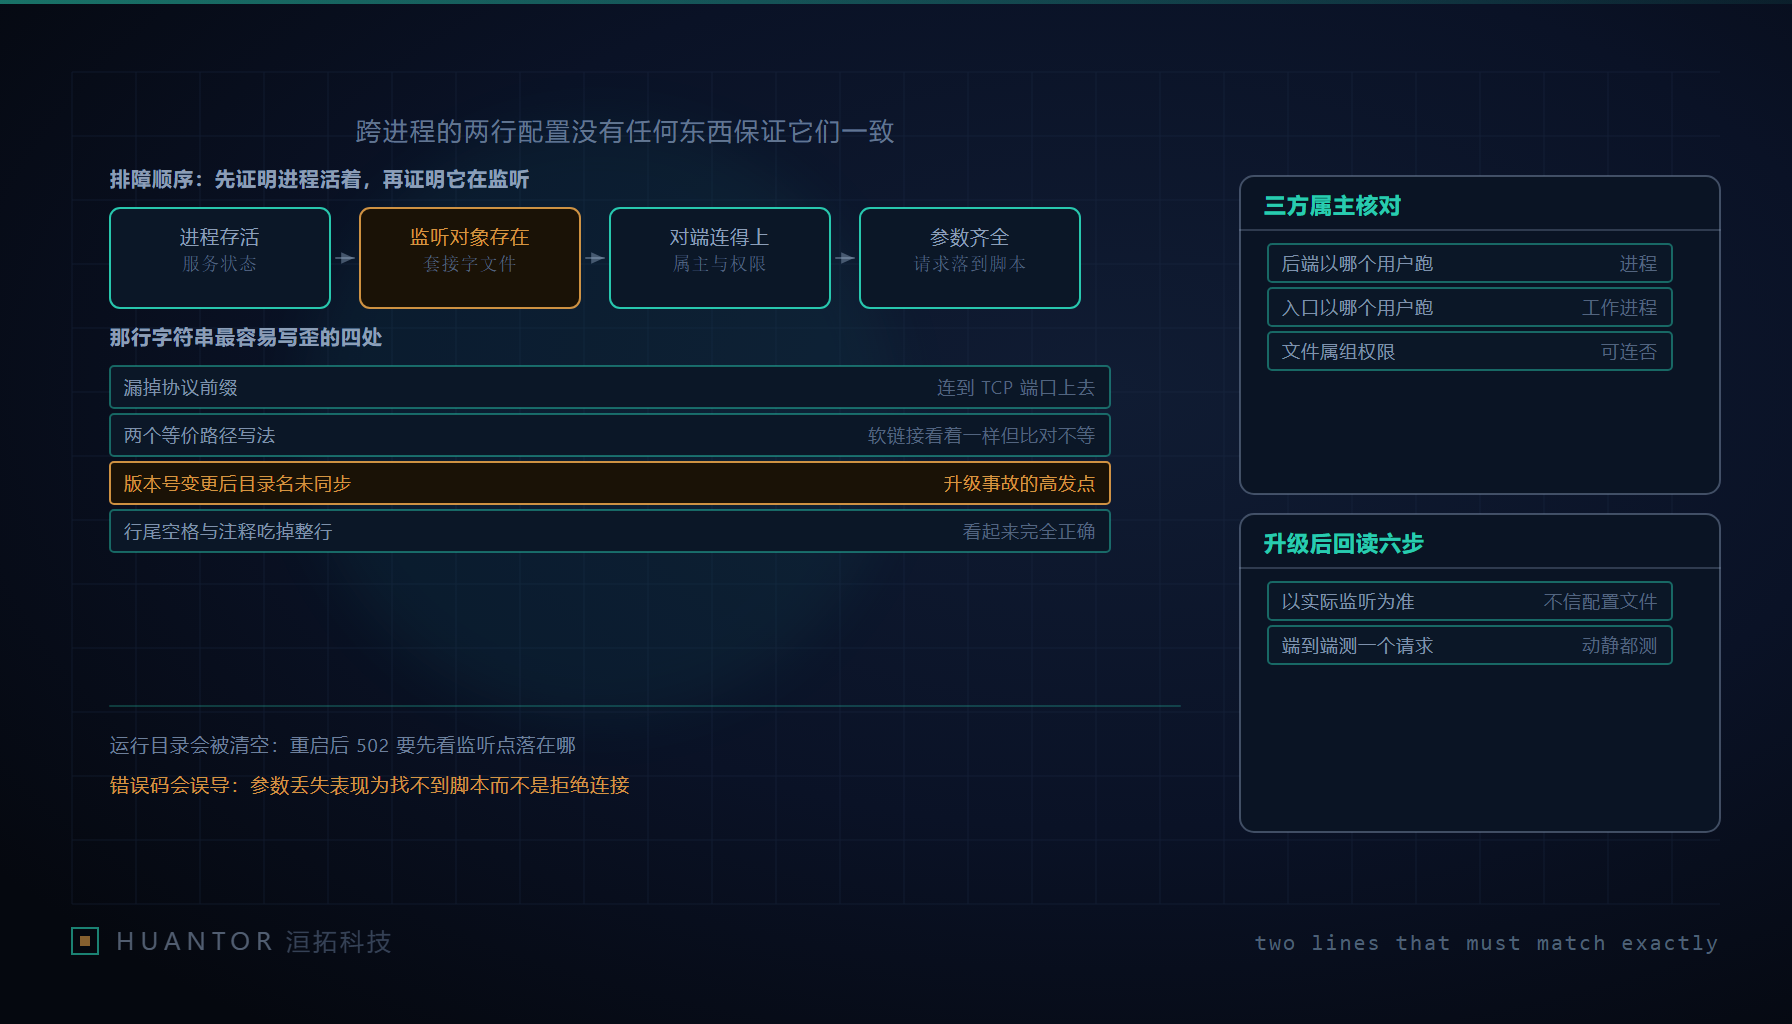
一、排障顺序:从“进程活着”到“对端连得上”,不许跳步
网关返回一个“上游连接失败”的状态码,很多人的第一反应是查负载、查应用代码。但在 Nginx 加 PHP-FPM 这种独立部署(没有 Apache、没有面板、没有容器)的环境里,这类错误很常见的一类根因其实朴素得很:两层服务之间的那条通信链路断了。链路只靠两行配置维系——FPM 在哪监听、Nginx 往哪转发。这两行分属两个进程、两份配置文件,没有任何约束力保证它们永远逐字符一致。平时没人看它,一到手动升级版本,最容易漏的就是这一行。这是配置漂移的教科书样本,而修复办法不是“下次更细心”,是把一致性变成一个可自动检查的项。以下命令与路径按实测转述,不能据此断言所有同类故障都是这一因。
链路排障的价值全在顺序上,跳步会让人一头扎进应用日志里空转。正确的推进是四级递进:先证明后端进程活着,再看它在不在监听,再看对端连不连得上,最后才轮到应用层。
对应到命令上是这样一条链:先确认 FPM 服务处于运行状态,形如 systemctl status php8.2-fpm 要给出 active 且 running;如果活着,去看它的 socket 文件在不在,用 ls -l 看 /run/php/ 下那个 .sock;文件不存在,就回头查池配置里的 listen = 这一行,它必须指向那个 socket 路径,而不是写成 127.0.0.1:9000 那样的 TCP 监听;文件在,再核对它的属主与权限允许不允许网关的 worker 进程去连;这几层都通了还没好,才去看应用配置和参数。顺序反了,你会拿着一个“连接被拒绝”的报错去翻业务代码,那是白翻。
二、socket 不是端口:多出来的是整套文件系统语义
选 Unix socket 还是 TCP,是这条链路的第一个岔口。socket 少了端口冲突的麻烦,代价是多出一整套文件系统语义:它有属主、有权限、所在目录会被清理、进程重启后要重新生成。最要命的一点是,/run 这类目录通常是重启即清空的临时文件系统——所以“重启之后才出现的 502”,第一个要看的就是监听路径是不是落在一个会被清空、或者重启后权限会变的位置。TCP 就不吃这一套,这也是为什么同一个应用换个传输方式,故障形态完全变了。
属主和权限要做三向核对,缺一向都可能留下隐患:FPM 以哪个用户身份跑、Nginx 的 worker 以哪个用户跑、socket 文件的属组和权限允不允许后者连。在常见发行版里,网关进程用户 Debian/Ubuntu 是 www-data、CentOS/RHEL 是 nginx,socket 属主要对上它,权限形如 srw-rw---- 这一类。对不上的直接后果就是那个“连接被拒绝”的错误。这里有个陷阱:只调权限、不调属组,看着能连了,实则把一个更隐蔽的授权问题留在了系统里——能连不等于连得合规。
三、路径字符串的四种不一致:“看起来对”从来不够
链路通不了,很多时候不是路径错,是两边“看着一样、逐字符不一样”。我们见过的不一致有四种典型:一是 Nginx 转发时漏掉了 unix: 前缀,或写成带前缀而 FPM 侧的语义对不上;二是 /var/run 和 /run 之间的软链接差异,肉眼觉得是同一个地方,字符串层面却不同;三是版本号变更后,路径里的目录名或文件名没同步——这也是升级后 502 最常见的来源,装了新版本却忘了把两份配置里的版本串一起改;四是行尾多了空格、或者一行本该生效却被注释掉了。
正因为这四种不一致,“看起来对”是没有用的,判定标准只有一条:两边配置里的监听字符串要逐字符比。FPM 的 listen = 值和 Nginx location 里 fastcgi_pass 的目标,必须是同一个字符串,不多一个空格、不少一个前缀、不走那个“看着等价”的软链接写法。
四、先分清是哪一段没通,而不是盯错误码
有一类故障会被误判方向,因为它根本不是 502。当参数丢失型问题出现时——比如那段公共的 fastcgi 配置 include 缺失或被注释、关键的处理脚本相关的参数少了几行——链路是通的,但后端“连得上却找不到脚本”,表现出来往往是 404 或一片空白页,而不是拒绝连接。这时候你要是按错误码去找,方向就错了。要按“哪一段没通”来分层:连不通是链路层(前面几节),连得上但行为不对是参数层。那种处理脚本相关的参数,宁可补全那几行也不要留空,缺哪一段就往哪一段找。
资源限制和超时也要和 502 区分开。子进程数上限这类参数受内存和进程数约束,慢请求把子进程占满时,表现是排队和超时,而不是拒绝连接——排查时去看 FPM 日志里到底是进程池耗尽还是连接被拒,是两种完全不同的处置方向。把 502、404、超时三者混为一谈,是这类排障最常见的浪费。
五、升级动作清单化:把一致性变成上线前的自动检查
既然根子是“两行配置没有约束力保证一致”,那治本就是把“手动核对”换成“清单加脚本比对”。升级应当是一条固定动作链,而不是一次即兴操作:
- 新版本装完,先把池配置与 Nginx 配置里的版本串同步改到位。
- 对 Nginx 做语法自检,确认改动没写坏。
- 按顺序重启服务——后端先起来、监听点先生成,再让网关连它。
- 回读实际监听点,而不是相信配置文件:进程和配置都可能对不上,以
ss或lsof或那个 socket 文件的实际状态为准。 - 用一个真实请求做端到端验证,确认真的走通了这条链路。
- 静态资源和动态请求都要测一遍,避免“动态好了、静态坏了”这种半拉子成功。
上线前再跑一个比对脚本,专门对比两边配置里的监听字符串。更关键的是把三个值写进交付基线表,让它们从“每次现场看”变成“记录在案、可比对”,这也是洹拓每次交接这类环境时的固定动作:
| 基线项 | 含义 | 回读方式 |
|---|---|---|
| socket 路径 | 两边必须逐字符一致的监听字符串 | 从池配置与网关配置各读一次并比对 |
| 属主 | socket 文件属主要等于网关 worker 用户 | ls -l 读实际属组 |
| 权限 | 允许 worker 连接且不过度授权 | ls -l 读权限位 |
同一台机器上跑多个站点时,还要写明站点级配置与全局配置的覆盖关系——哪个赢,得写在基线里,不能靠记。
六、容器与面板:先找到配置的真相源在哪一层
上面所有做法都建立在“配置文件就是真相”这个前提上,而这个前提在面板和容器环境里恰恰不成立。那里的 socket 路径很可能由环境变量或面板生成,你手动去改那个文件,下一次同步或重建就把它覆盖回去了。所以在这种环境里,动手之前先回答一个问题:配置的真相源到底在哪一层——是文件、是环境变量、还是面板里的那条记录。找到那一层再改,否则改得再对也会被覆盖,第二天 502 又回来了。环境不同,处置的落点就不同,这一点不能一概而论。回到最初:这条链路的可靠性,不取决于你升级时有多仔细,而取决于你有没有把“两行一致”变成一条机器能在上线前替你确认的检查项。