
批量插入返回的到底是成功还是没成功:三种语义要分开判
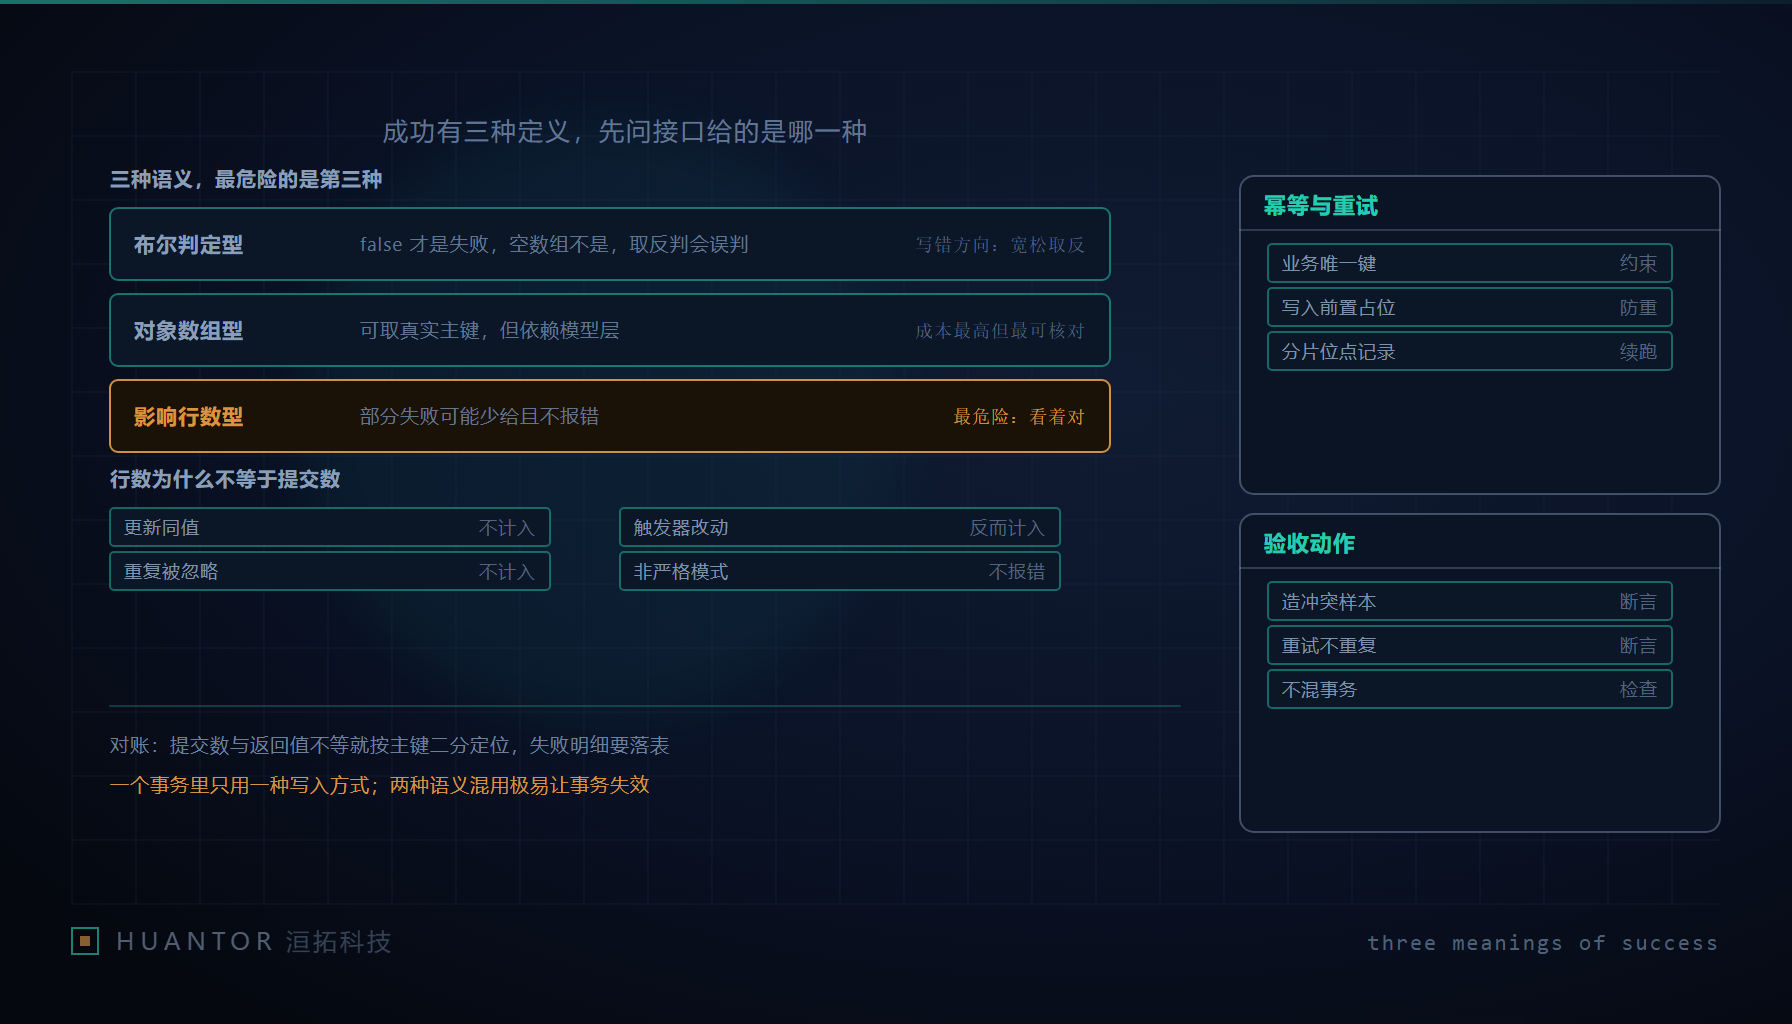
一、先分清接口返回的是哪一种“成功”
我们在给客户做数据导入、日志归档、批量补数这类功能时,几乎都会碰到同一个动作:一次提交一批记录写进库。写完之后要回答“成没成”,很多人下意识去判返回值真假。问题在于,同一个框架里往往并存着两条甚至三条批量写路径,它们返回的东西根本不是一个语义。判错语义,最坏的后果不是报错,而是你以为全写进去了、实际少了一部分且没有任何声响。这一篇讲的就是怎么先认语义、再对账、最后验收。
“成功”这三个字,在批量写接口上至少能被定义成三件事:请求没报错、返回值不为假、写入条数等于提交条数。接口给你的是第一种还是第三种,直接决定你要不要自己再补一层对账。我们实测过的 ThinkPHP 场景里,走模型层的 saveAll() 会触发验证、自动填充与事件,失败时返回的是 false(不是空数组、也不是 null),必须用严格判等去认这个假值、而不是宽松取反;成功时返回一组模型对象,数量与输入一致,每个对象还是实例、可以从中取到真实的自增主键,失败原因要从模型上再取一次错误信息。而绕过模型、直连数据库的 insertAll() 不做验证,返回的是一个整型的“影响行数”,失败时默认也不抛异常。这两种返回放在一起判,用同一套 if (!$result) 的写法必然出错。
下面是我们内部对齐用的语义对照表,字段就按“返回什么、失败长什么样、能不能逐条拿到明细”来列。
| 语义类型 | 代表接口 | 失败时的表现 | 能否取真实主键 | 主要坑 |
|---|---|---|---|---|
| 布尔判定型 | 模型层批量保存,失败返回假值 | 返回布尔假值,需向模型再取错误信息 | 可,返回对象数组每项含主键 | 空数组不是失败,宽松取反会把“没有数据”误判成失败 |
| 行数型 | 直连库的批量插入,返回影响行数 | 默认不抛异常,可能只写了部分而无声 | 否,只给一个总数 | 部分冲突静默、行数不等于新增数、不同库与驱动语义不同 |
| 对象数组型 | 模型层成功返回的实例集合 | 失败时不产出集合而是假值 | 可,逐项取主键 | 依赖模型层,成本高于行数型 |
第一行的坑最常见:布尔型必须用严格判定去认那个假值,一旦用了宽松取反,一个“提交了空集合、返回空数组”的正常场景会被当成失败。这一层限定要写清楚——以上是实测框架里的行为,不能拿它去断言所有框架、所有版本都遵循同样的返回约定,迁移时得重新确认。
二、行数型为什么最需要警惕
三种语义里,把“没成功”藏得最深的就是行数型。原因有三点,每一点都能单独造成静默的少写。
其一,非严格模式下部分失败不报错。实测里,提交一百条、其中五条撞上唯一键冲突,非 strict 模式的底层驱动可能只返回九十五条受影响、并且不抛任何异常——调用方看到“有个正数返回”就以为成了,实际少了五条,且这五条是无声消失的。这不是比例结论,而是“部分成功会伪装成全部成功”这一类故障的样本;主键或唯一约束冲突会抛完整性约束类错误、查不到数据另有一类异常,这些标识要能区分开。
其二,影响行数不等于新增条数。行数统计的是“被数据库改动的条数”,而不是“新增了几条”。更新一个值没变的字段、被忽略掉的重复行、由触发器连带改动的行,都会让行数偏离你提交的业务条数。把行数当新增数记账,账一定对不上。
其三,不同数据库与驱动的语义本身就有差异。同样是“受影响行数”,更新操作到底返回“匹配到的行数”还是“真正改动的行数”,取决于连接选项;换一种数据库、换一个驱动,这个语义就可能变。所以我们不写“所有行数型都如何”,只写“这一处的语义要以它自己的连接配置为准,落地前先测一次”。
三、判定与对账要写成动作,而不是靠运气
认完语义,接下来的核心是“写完自己核对”。判定不能停在“返回值不为假”,要一路做到“写入条数等于提交条数”。
提交条数与返回值的显式比对是第一步:把这次提交了多少条记下来,和接口给回来的数做减法,只要不等就当成异常处理,按批内主键做二分定位,找出到底是哪一段没写进去,而不是整批回滚了重跑——整批重试既浪费,又会在非幂等路径上制造重复。定位到具体行之后,写入结果还应按业务键回查库里的存在性,用“这条数据在不在”来最终确认,不依赖返回值单方面说法。
失败明细一定要落表,不能只打日志。日志会滚掉、会漏看,落表才能被后续流程消费。我们要求失败明细表至少含这几个字段:原始行内容、失败原因、错误码、已重试次数、终态。异常类型也要留可辨识的标识,比如找不到数据、主键或唯一约束冲突各自对应哪一类错误,便于事后区分“数据问题”和“并发撞键”。这套字段就是本篇要交付的“写入后对账与失败明细落表字段”。
四、幂等:批量任务被重试时不能写出重复
批量任务迟早会被重跑——网络抖了、进程被杀了、运维手动重试了。重跑不产生重复,靠的不是“祈祷这次别再撞”,而是设计上的幂等。
手段是三件叠在一起:给业务上不该重复的记录建唯一键,冲突时走“忽略”或“更新”语义;写入前先落一个占位状态,标记这一批正在处理;任务侧记录分片位点,重跑时从位点续而不是从头再来。这里要区分两种“处理冲突”的原生写法:INSERT IGNORE 把冲突直接吞掉当作没发生,ON DUPLICATE KEY UPDATE 把冲突转成一次字段更新。两者都会让“影响行数”更难解读——吞掉的那种,行数里少了被忽略的;转更新的那种,行数可能把更新也计进去。所以统计口径必须明确拆成“新增、更新、忽略”三档分别计数,而不是给一个笼统的行数。需要逐条拿到新增主键时,insertAll() 本身不支持返回每条标识、也不支持跳过重复,要么走模型层、要么拼这两种原生语法,不要用“上一条主键加偏移”去推算——自增步长不是 1、有并发插入、事务回滚过,任何一种都会让推算偏掉;实测里那种靠最后插入标识推算的做法仅在自增步长为 1 的特定数据库上勉强可用,不足以当通用方法。
五、事务边界:一个事务里只放一种写入方式
事务这一层有个不太显眼但会致命的坑。两条语义不同的写路径——一条走模型、一条绕过模型直连——混在同一个事务里,模型层内部可能另有自己的连接或提交动作,绕过模型的那条语句又不一定参与同一个回滚单元,在版本混用的环境里极易导致整个事务失效,你以为的原子性其实不存在。结论很简单也很硬:一个事务里只用一种写入方式,无论统一走 Db::transaction() 还是 startTrans/commit/rollback。要批量又要在事务里,就选定一种路径,别图省事混着写。
再一个取舍是事务粒度。整批放一个大事务,好处是原子、坏处是锁持有时间长、并发下容易锁等待,一旦失败要回滚的量也大;切成多个分片小事务,好处是可恢复、锁轻,坏处是不再整体原子,得靠上面那套对账来兜完整性。数据量大、能容忍分段就分片小事务;必须整体成败一致才用大事务。无论哪种,每个批量动作之后都显式核对条数、不等就主动抛出,是我们写进代码规范里的硬性动作。
六、验收清单与跨栈迁移
最后把“怎么确认这套逻辑真的可靠”落成验收动作,洹拓交付这类批量功能时这几项必测。
- 造一批含冲突的样本,断言“返回行数 = 提交条数 - 冲突条数”,验证部分失败被如实反映而非静默。
- 跑完后检查失败明细表确实有条目落进去,字段齐全(原始行、原因、错误码、重试次数、终态)。
- 同一任务重跑一次,断言不产生重复记录,验证幂等确实生效。
- 故意把两条不同语义的写路径放进一个事务,验证会被拦下或按约定处理,确认没掉进混用失效。
- 小批量(几十条以内)时改走逐条保存更省调试成本,逐条写要设一个耗时上限判断,超过上限再考虑合并成批量。
把这套判定搬到其它技术栈,口诀不变:任何批量接口,接过来先问三件事——返回的是什么类型、部分失败怎么表现、有没有逐条明细可取。语义认清了,对账就有落点;对账有了,“成没成”才是一个可以回答的问题,而不是一个赌注。