
官方给出下架日历:模型退役倒计时的依赖盘点与迁移排期
一、下架日历不是采购问题,是资产清册问题
据公开报道,有厂商把旧版接口何时退出摆到了明面上,给出了一个明确的下架倒计时。这件事容易被读成一条采购提示——“该换新版了,去看看新版贵不贵”。但从后端交付的角度看,日历给得越清楚,考验的反而越不是选型,而是你到底知不知道自己在用什么。一个把模型当依赖来跑的 systems,先要回答的三个问题是:哪些系统在调它、分别是谁在负责、每个系统依赖的是它的哪一种行为。这三个问题一个都答不上来,”什么时候能迁完”就没有意义,因为你连要迁多少个点都不知道。
这一篇不评价任何厂商的退役政策是好是坏,也不推断别家会不会照此办理,只把”倒计时已经给定”当成一个既定约束,谈在这个约束下,一次可控的模型退役迁移该怎么做。核心就一句话:先把资产清册列全,再谈排期。下面从清册字段开始。
二、依赖清册必须到的字段
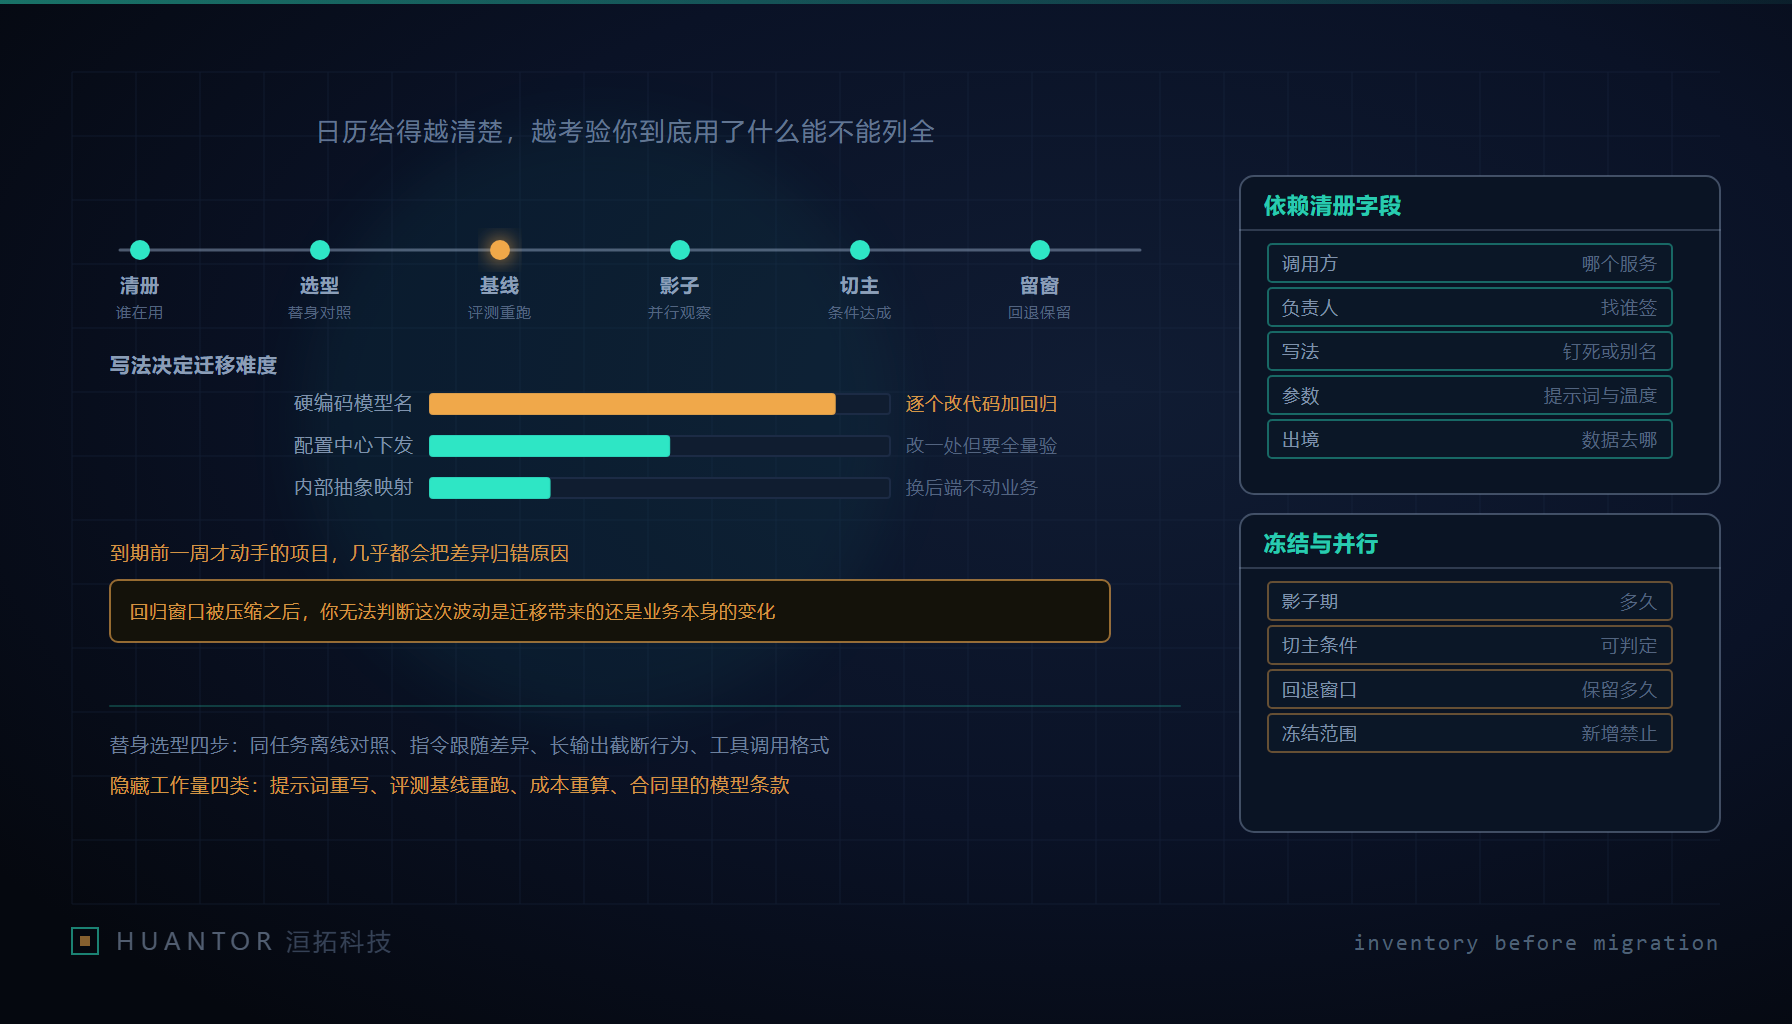
清册不是”我们用了某某模型”一句话,它要细到能被逐项核销。我们内部推动这件事时,坚持每一行都要填满下面这些字段,缺任何一列,后面的排期就会出现”迁到一半才发现还有个调用方”的事故。
| 字段 | 为什么要这一列 |
|---|---|
| 调用方服务 | 定位到具体的服务或进程,而不是”业务线”这种含糊单位 |
| 负责人 | 迁移要有唯一的责任人,不能挂在一个部门上 |
| 环境 | 生产、预发、测试、离线批处理各自可能用不同模型标识 |
| 模型标识写法 | 钉死的具体版本,还是走别名(latest、stable 一类),迁移策略完全不同 |
| 是否含提示词与参数 | 有没有自带的提示词模板、温度、最大输出长度、工具定义,这些是要一并搬的资产 |
| 下游业务 | 这个调用出错会打断哪条真实业务,决定优先级 |
| 数据是否出境 | 调用时把数据送到了哪个区域,替身选型时要匹配同样的驻留边界 |
其中两列最容易被低估。”模型标识写法“决定了工作量:钉死了具体版本的服务,迁移时是显式改一处配置;用别名的服务,你以为它跟着平台自动升级、其实行为早就在你没察觉时漂过,下架只是把最后一次漂移推到台前。”是否含提示词与参数“决定了这件事到底是不是”换个名字就能跑”:提示词、采样参数、工具 schema 都是绑在旧模型行为上的,换个模型这些往往要重写,光改标识符是不够的。
三、三种标识写法,迁移难度差一个量级
把”用了什么”写在哪里,有三种常见做法,它们在倒计时面前的表现差别极大。
- 硬编码模型名:版本标识直接写死在代码里。迁移时最痛——每个调用点都要改代码、过评审、发版,数量一多就必然漏掉某处,等到那处报错才知道它在。
- 配置中心下发:模型标识放在配置或环境变量里,代码不感知。迁移时只需改配置项,但要小心配置项散落在多个服务、由不同人维护,改完还得确认所有环境都同步到。
- 内部抽象层映射:业务代码只引用一个内部别名(如”对话主力”),别名到真实模型的映射集中在一处。这是唯一一种能把迁移变成”改一张映射表”的做法,但代价是要有一层稳定的抽象,而且别名下的行为差异要能被这层消化。
统一后的最小改造其实很清楚:把所有调用点从”写死模型名”迁到”引用内部抽象名”,把真实版本集中到一处映射。这一步本身就是迁移工程里最值钱的一次重构,洹拓在服务按量调用外部模型的客户时,几乎每次都把它排在倒计时之前先做,因为它把”下架要改 N 处代码”变成”下架改一处映射加一次回归”。赶在倒计时之前做这件事,永远比临到头再补划算。
四、替身选型的四步与藏在排期里的四类工作量
新版或替身不是”看着参数差不多就换上”。选型至少要走这四步,每步都可能翻车:
- 同任务离线对照:拿一批有标准答案的真实任务,让新旧两个模型在同一套题上跑,看结果差距,而不是看演示。
- 指令跟随差异:同一份提示词,两个模型对格式、长度、拒答、追问的遵循程度可能不一样,这直接决定要不要重写提示词。
- 长输出与截断行为:最大输出长度、超长时的截断方式、停止符处理,旧模型的行为往往被下游依赖着。
- 工具调用格式:结构化输出与工具调用的 schema、参数类型、错误码,是迁移里最容易静默出错的一类。
而真正让排期崩掉的,通常不是选型,是四类被漏算的隐藏工作量,它们很少出现在最初的估算里:提示词重写(新模型不吃老提示词,得逐条调)、评测基线重跑(换模型后原来的通过线全部要重新标定,否则回归无从判定)、成本重算(单价、计费口径、缓存策略一变,下游预算和限流都要跟着改)、以及客户合同里的模型条款——有些交付合同白纸黑字写了用哪个模型或某档能力,换模型不是纯技术动作,是要和客户重新确认的。漏了这四项里任何一项,项目都会在自己以为的”已经迁完了”之后继续出血。
五、冻结与并行策略:六个里程碑才叫一条排期
倒计时给的是终点,不是路径。把它落成可执行的排期,我们按六个里程碑走,每个里程碑都有明确的”完成判据”,不接受”差不多了”这种状态。这张表是本文交付的第二件东西:
| 里程碑 | 这一段要做完什么 | 完成判据 |
|---|---|---|
| 一、清册冻结 | 依赖清册列全并复核,标识全部改成内部抽象名 | 无一个调用点仍写死旧版本;清册逐行有负责人 |
| 二、替身定型 | 四步选型跑完,确定目标模型与映射 | 离线对照结论存档;提示词与工具 schema 差异清单成形 |
| 三、并行影子 | 新版本以影子方式接同样的真实流量,只记录不生效 | 新旧在同类请求上的结果差异被量化并分类 |
| 四、切主 | 满足条件后新版本转正、旧版本降为备用 | 差异在可接受范围、下游业务灰度通过 |
| 五、回退窗口 | 保留一段可随时切回旧版本的窗口 | 回退被真正演练过一次,而非只在文档里存在 |
| 六、旧依赖退场 | 移除旧映射、清理提示词与配置残留 | 清册里对应行被标记为已核销,无残留调用 |
三个要点值得单拎出来。影子要跑多久不由日历定,而由差异是否被解释清楚定——不是”跑够一段时间”,是”每一类差异都能归因到提示词、参数或行为,而不是未知”。切主的条件必须是可判定的:预设一个通过线,达标才切,不达标就继续影子,而不是”感觉差不多就切”。回退窗口要保留多久,取决于旧接口什么时候真正下架,窗口必须明显长于”发现问题到确认问题”这段时间,否则等发现不对时回不去。
六、为什么临到期才动手,几乎一定出问题
最后回到那句最反直觉的判断:一个把迁移压到倒计时快见底才启动的项目,几乎必然出问题,而且问题不是”没迁完”这么简单。真正致命的,是它把回归窗口压没了。
迁移最怕的不是差异,是无法归因的差异。当你有充裕的并行期,新版本一旦让某条指标动了,你能比较有信心地说”这是这次迁移带来的”,因为这段时间里没有别的变量。可当你临到期才动手,迁移上线、缺陷修复、配置变更、甚至业务本身的季节波动全挤在同一时间窗里,指标一变,你根本分不清是模型换的、还是别的什么改的。判定不了一次迁移是好是坏,就等于蒙着眼睛切主,而切主又是不可逆动作——一旦切过去发现不对,旧接口也已经下架,回退窗口被你亲手压没了。
所以倒计时的正确用法,不是卡着那条线去赶工,而是倒推:从下架点往回,先扣掉回退窗口,再扣掉切主与灰度,再扣掉影子并行,再扣掉选型四步,剩下的才轮给清册整理和抽象层重构。把这套时间倒排一次就会立刻发现——真正该在今天就开始的,是那份依赖清册。列不全它,后面所有里程碑都是排在一个看不见的洞上。能不能在倒计时面前保持从容,取决于你手里那份清册是不是早就是全的;等到只剩一条硬期限时才第一次认真清点,就只剩下赌运气了。