
只开放前两段的视频模型:从人类视频学到动作还差哪一段
一、”部分开源”要按段来读
据公开报道,有一支具身智能团队把机器人完成一项操作的过程分成三段:先预测任务接下来会怎样发展,再把较长的过程压缩成视觉规划,最后学习机器人动作;这次开放的是前两段的权重。团队名称、模型版本、参数规模与评测分数在这里都不重要,本篇不使用它们作为任何判断依据。值得接过来的是一个读法:分层的能力描述配合分层的权重开放,意味着”开源了”这三个字必须逐段解释,否则很容易把前两段的成熟度误当成整条链的成熟度。
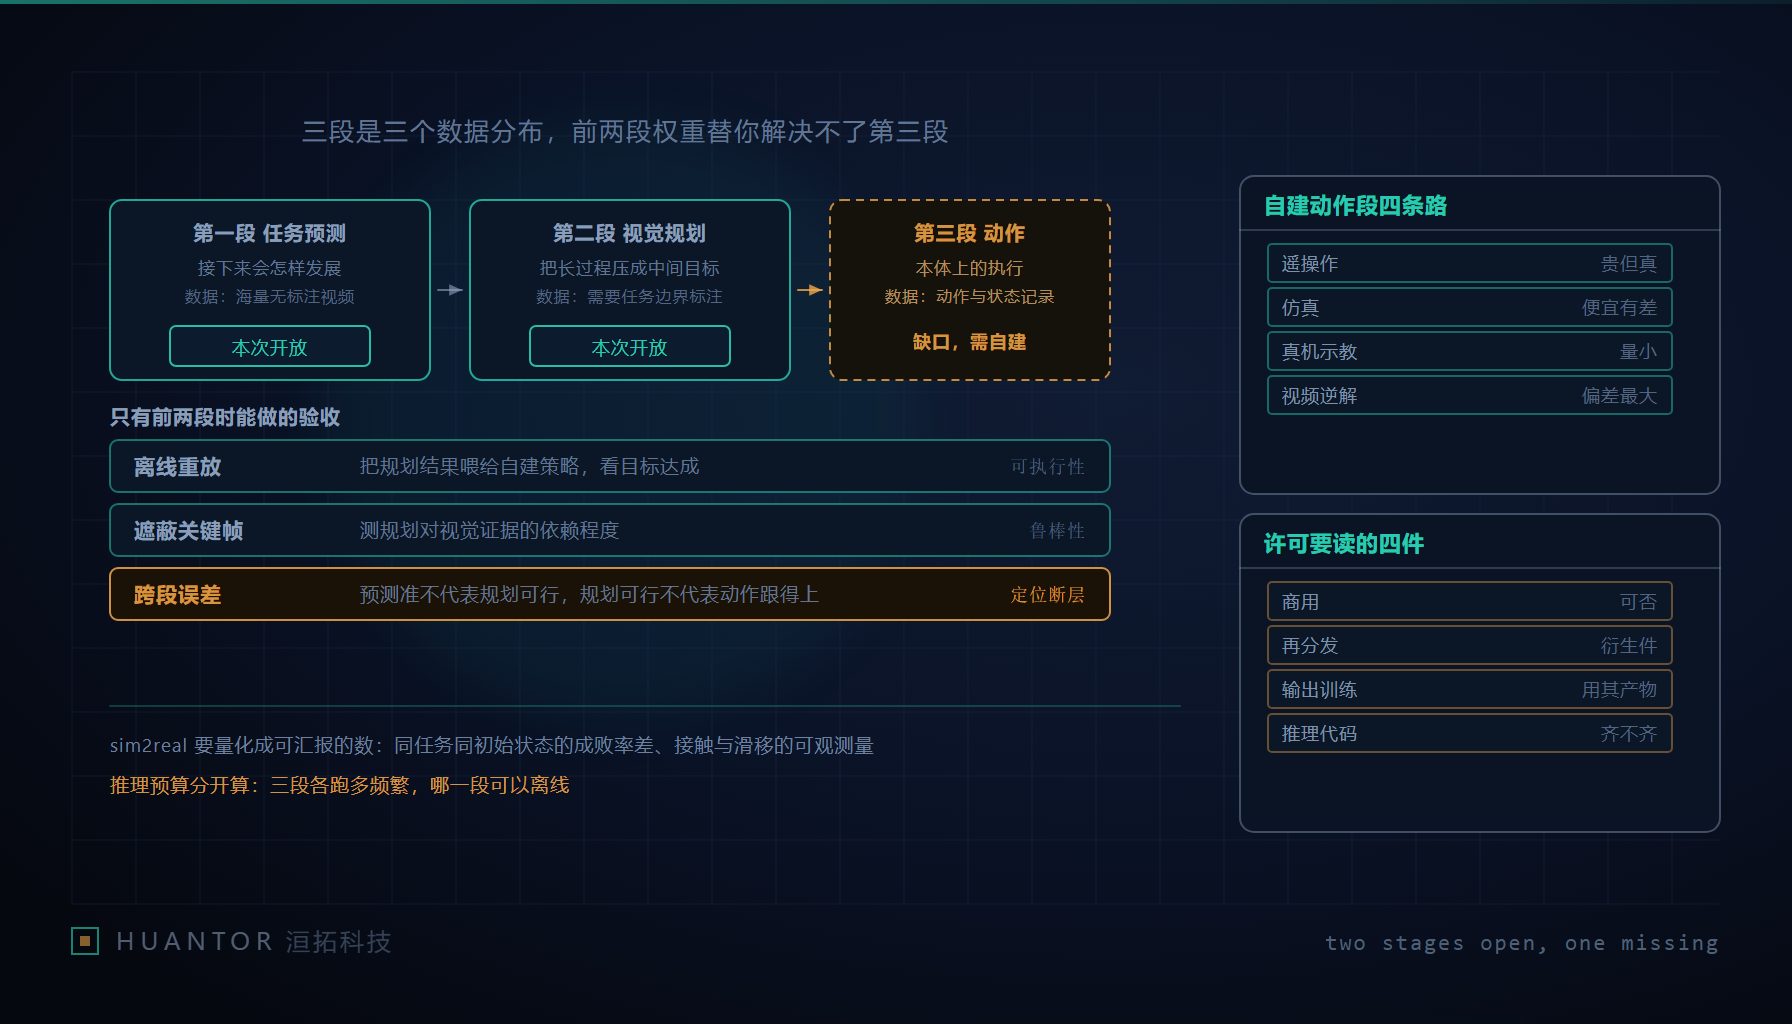
三段不是三个模块,是三个不同的数据分布。前两段能从海量人类视频里学到东西,因为视频天然是它们的监督信号;第三段的监督信号在视频里根本不存在——画面不告诉你关节角是多少、夹爪闭合到多少力、接触发生在哪一帧。缺的不是算法技巧,是可用的标签。所以我们评估这类工作时,第一个问题从来不是”效果好不好”,而是”我拿到的这两段,能在我自己的系统里复现到哪一步,第三段我自己有没有数据补齐”。
二、三段各自的数据来源、可复现范围与验收方式
把三段并排列出来,缺失位置会很直观。下表是我们做选型评估时的固定形状,右两列按自己的任务填。
| 段 | 监督信号从哪来 | 标注与获取成本 | 拿到权重后的可复现范围 | 能单独验收的方式 |
|---|---|---|---|---|
| 预测任务如何发展 | 无标注视频,靠画面自身的前后关系自监督 | 视频量大而便宜,缺的是动作与意图标签 | 可在自建数据上重跑预测,观察发展轨迹是否合理 | 给定起始帧,比较预测结果的物理合理性与一致性 |
| 长过程压缩为视觉规划 | 需要任务边界与中间目标的标注,通常要人工切分与命名 | 中等偏高,贵在定义”中间目标”这件事本身 | 只能复现”给出目标后产出规划”的行为,无法复现规划是否可达 | 把规划结果作为条件输入接自建策略,看能否驱动完成 |
| 学习机器人动作 | 本体真实或仿真的动作与状态记录,含关节、末端、接触信息 | 最高,要场地、设备、时间与逐条质检 | 完全不可复现,本次未开放 | 只能在真机或高置信仿真上按任务测成功率 |
第三列的差别需要强调一句:前两段的成本问题主要是”标签定义”,第三段的成本问题是”物理世界必须真的发生一遍”。这两种成本不可互相替代,也就决定了只拿到前两段的人无法靠堆算力追平。
三、跨段误差是传递的,三种失败长得不一样
分层结构最容易骗人的地方在于:每段单独看都能跑,接起来不对。三种失败各有各的样子,把它们分开描述,才能在报告里不说含糊话。
预测段的失败是”想得不合常理”。它可能给出一个视觉上流畅但物理上过头的轨迹,比如把一个不稳的堆叠预测成自然倒塌,或者忽略了人手在中间的重新抓取。这类失败在离线视频指标上未必显眼,因为它预测的是画面,不是接触。
规划段的失败是”分步看似合理但不可达”。中间目标定得太粗,动作段无从下手;定得太细,就把环境的不确定性当成了确定性。典型表现是规划里出现”把某物放到一个当前机械臂够不到的位置”,或者两个中间目标之间的顺序在真实约束下无法成立。
动作段的失败最常见也最难看:接触丢失、滑移、力过大导致形变、对遮挡的鲁棒性崩塌、成功一次换个初始状态就失败。前两段再准,也不会替你解决这一段——这是本篇的核心判断,也是所有”看视频学会操作”的说法在工程上必须打折的原因。
四、只有前两段时,能做的三项验收
拿到前两段权重之后,有价值的验收不是去跑一遍宣称的任务,而是确认它在你的环境里到底贡献了什么。我们固定做三项。
- 规划输出的可用性验收:把规划结果当作条件输入,喂给自建的简单策略(哪怕是规则策略),看任务完成率相对”无条件输入”提升了多少。提升接近零,说明规划在你自己的数据分布上没有信息量。
- 离线重放验收:用自己采的历史片段,只给起始观测,让模型给出发展与规划,再对照当时真实发生的过程。这项验收的产出是”偏差类型清单”,不是分数,重点看偏差集中在哪一类环节。
- 遮蔽鲁棒性验收:遮挡关键帧、替换背景、改变视角与光照,观察预测与规划在什么程度开始失效。工业场景里这项比准确率更贴近真实风险,因为产线视角是被机构挡住的。
三项都不需要动作段,因此可以在决策前做完。反过来,任何要求”在真机上跑通任务”的验收,都必须先回答第三段用什么数据,否则会退化成一次昂贵的演示。
五、自建动作段的四条数据来源与各自的偏差
第三段只能自建。四条路各有固有偏差,选路的时候选的是偏差类型,不是快慢。
| 数据来源 | 固有偏差 | 必须额外标定的量 |
|---|---|---|
| 遥操作 | 人的操作策略远优于机器人闭环能力,数据里含大量人凭直觉做的中途修正 | 人机执行速度差、修正动作是否可被策略复现 |
| 仿真 | 接触、摩擦、形变与传感器噪声被简化,成功的策略对参数区间敏感 | 物理参数随机化范围、渲染域差、失败样本的保真度 |
| 真机示教 | 覆盖状态窄,任务被少数场景与少数操作员风格主导 | 状态覆盖统计、跨场景重采成本 |
| 从视频反推动作 | 缺少真实动作标签,估计误差直接变成监督噪声,接触与力信息缺失最严重 | 与真值的对齐误差、可用于训练的置信阈值 |
我们的经验是:这四条不是竞争关系,而是配比关系。仿真负责覆盖广度和失败样本,真机示教负责锚定真实分布,遥操作负责给出接近任务上限的示范,视频反推只在数据规模确实起不来时补位,且必须用最严的置信过滤。把任何一条当成唯一来源,都会在自己的验收报告里留下无法解释的失败类别。
至于仿真到真机的差距怎么量化成可汇报的数,口径要窄:同任务、同初始状态下两侧的成功率差;接触相关可观测量(滑移发生比例、法向力峰值分布、抓取后位移)的分布差;同一策略在两侧的首次失败环节。这三个口径都能给出可信的相对变化,且不需要声称任何绝对能力水平——这一点在具身项目上尤其重要,因为绝对数字很容易被读成部署就绪度。
六、推理预算与许可范围:两件常被跳过的核对
最后一组核对是两件很朴素的事。
第一件是三段各自跑多频繁。预测与规划天然是低频的,一次任务里可能只需要若干次;动作策略必须高频闭环。两段的调用频率相差极大,放在同一台机器上跑就会互相拖累。工程上要把可离线的那两段明确挪出实时链路,把实时链路的算力留给动作段,并把”哪一段可以离线”写进系统边界而不是留给现场调试决定。洹拓在工业侧的项目里把这条列为强制项,因为产线上的实时预算没有讨论空间。
第二件是把”开源”读成许可范围,四个问题必须逐条落到书面:能否商用;能否再分发与二次分发;能否用前两段模型的输出去训练我们自己的第三段;训练数据的来源与授权是否可追溯。这四条决定了技术评估里”要不要自建”的成本边界,比权重文件本身更要紧。许可含糊时,正确的做法是把它当作不可用处理,先问清再动手,不要等集成做完才发现用途受限。
读到这里结论其实很窄:看得懂会发生什么、规划得出下一步,和真能动手之间,隔的不是模型规模,是那一整段必须物理发生才有标签的数据。开放到哪一段,能复现的边界就停在哪一段。