
把跑六小时的任务当训练材料:先解决等待、配额与失败样本
一、难的不是算法,是等待
据公开报道,有团队介绍了一个面向超长程智能体任务的在线强化学习框架,论文已提交到预印本平台,描述里给出的困难是这类任务包含数百轮相互依赖的模型与环境交互、任务结束时间差异很大、需要等待。这组说法里的训练规模、评分和提升幅度都没有给出可比口径,所以我们不拿它当判断依据。真正值得工程侧反复琢磨的是最后那两个字:等待。
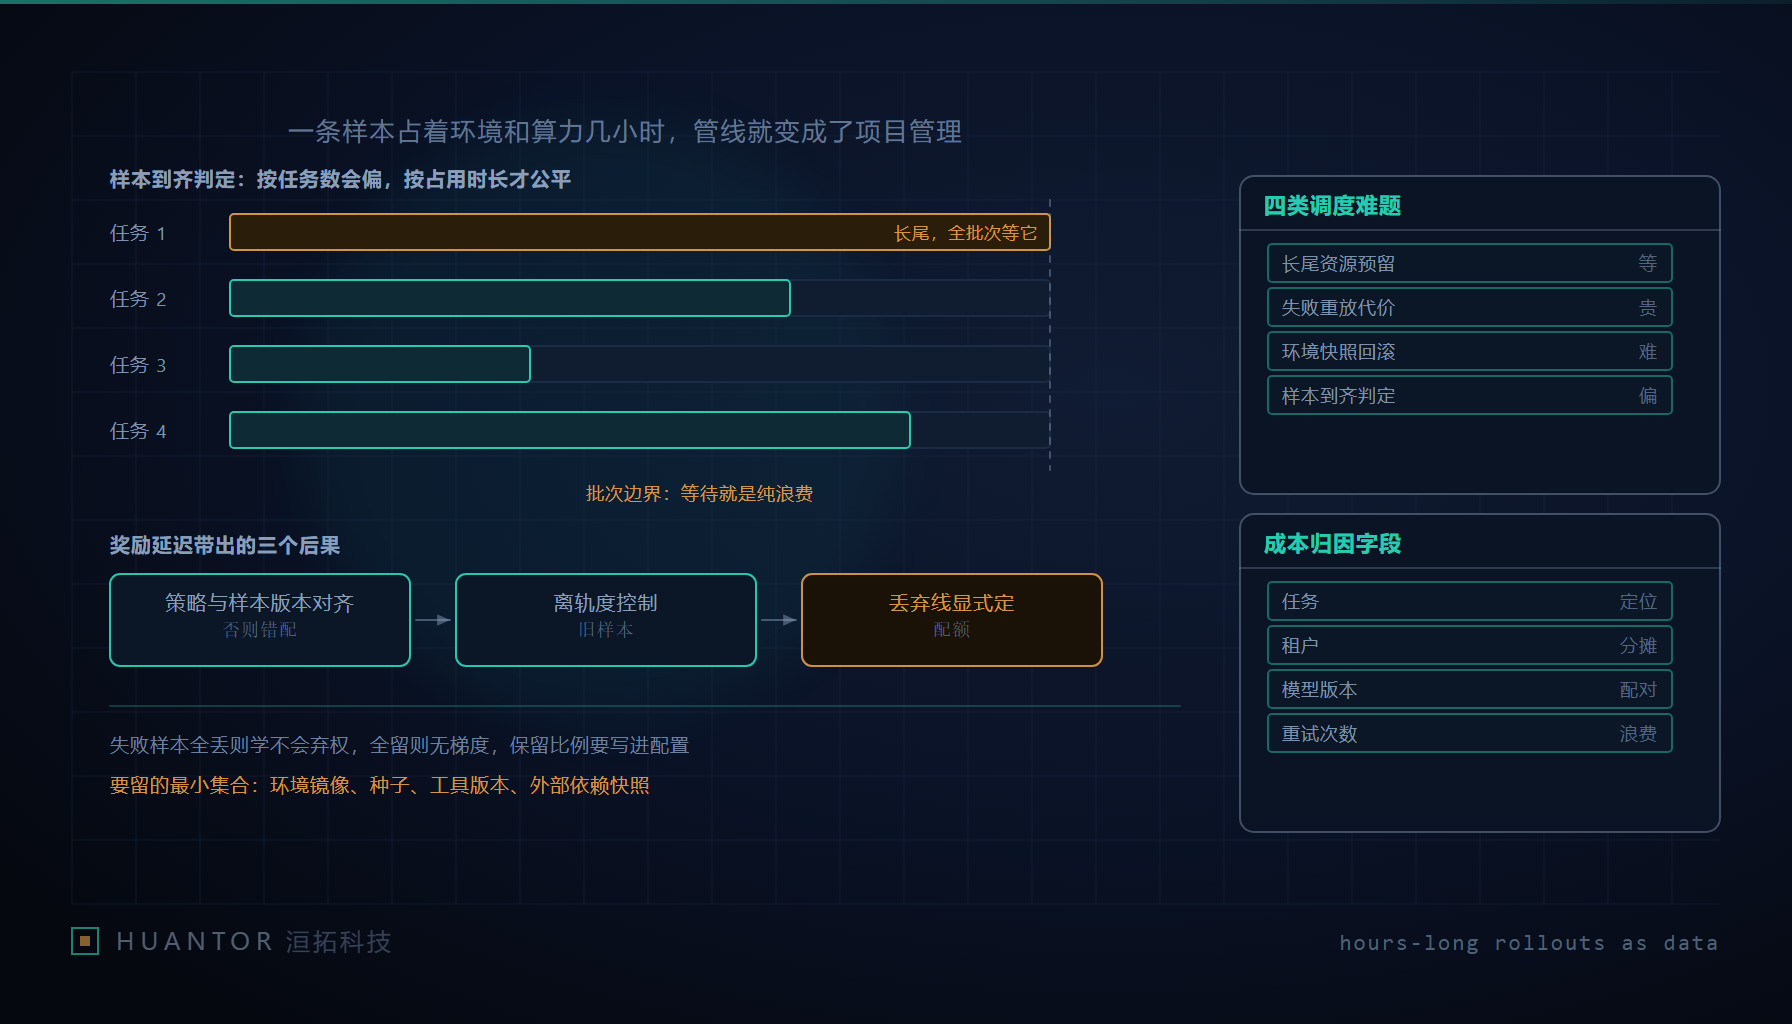
常规训练管线的隐含假设是”样本来得比消耗快”。数据是死的,读一批算一批,处理速度由算力决定,慢了加机器就行。小时级的交互式 rollout 把这个假设推翻:一条样本在产出之前要占着一个环境、一份算力配额和若干外部服务的调用额度,几个小时不能回收;它什么时候结束谁也不知道,可能是三分钟,也可能是六小时。于是训练管线从”喂数据”这件事变成了”管一批并发项目”这件事,瓶颈从吞吐转移到了调度和回收。
这一点对我们的客户尤其现实。很多做工业软件、做研发工具的客户想把自家那种”改一整仓代码””复现一套环境”的任务变成后训练材料,问的第一句通常是显存要多少。实际要回答的第一句是:这些任务在训练期间能不能被安全地挂起、快照、续跑和作废。答不上来,算力买够了也只是把等待变得更贵。
二、异步 rollout 的四类调度难题
第一类是长尾任务的资源预留。如果按最长任务预留,队列平均成本被尾巴拖高;如果不预留,短任务源源不断进来,长任务永远排不到,出现饥饿。可行的做法是显式分池:按预估时长把任务分成几档,每档有独立的并发上限与排队上限,并给等待时间加上随龄提权,让”任务被拖着不动”变成一条可查询的曲线而不是偶发抱怨。
第二类是失败任务的重放代价。交互式任务里一次失败往往不是纯计算错误,而是外部依赖变了:接口返回结构改了、镜像层拉不到、下游服务限流。整条链路重放一次的耗时和成本接近重新采样,而且重放出来的轨迹和原来不可比,因为它面对的世界已经不同。所以重放要记账,要区分”同一环境快照上的重放”和”新环境上的重新采样”,两者的用途不一样,不能混进同一批。
第三类是环境快照与回滚。崩溃了从哪儿继续,取决于能不能把环境状态外置。文件型环境好办;带进程状态、带外部会话环境只能靠录制,也就是把工具调用的输入输出落盘,回放时按序应答。快照点选太密会拖慢 rollout,选太疏则回滚损失大,这个权衡要按任务的单步成本算,而不是按经验拍。
第四类是样本到齐判定与批次公平。等多久算齐,超时未到的样本算缺失、算截断还是算丢弃,直接决定训练信号有没有被系统性歪掉。如果总是先到的进批次,模型就被训练成”擅长做短任务”,因为长任务的轨迹在批次里被抽走了。
三、按任务数记账一定会偏
把一条六小时的任务和一条三分钟的任务算作同等权重,训练信号会被稀释:批次里的交互轮数差异极大,而梯度更新的次数与时间推进完全脱钩。要避免这个偏差,先承认不存在单一正确口径,然后按用途分开设三本账。
按交互轮数记账反映的是模型侧真实消耗,也是策略梯度样本量的自然单位,缺点是它不看环境被占用了多久。按环境占用时长记账反映的是排队压力和资源账,缺点是把”奖励来得慢”的任务天然放大。按外部调用次数记账反映配额与费用风险,适合做限流依据,和训练价值几乎无关。
我们的做法是双口径加一个公平性指标:批次按累计交互轮数到齐,成本按环境占用时长归因,同时把”被截断样本比例””按龄提权触发次数”作为公平性指标常驻面板。这样当训练指标不好看时,能区分是模型问题还是采样被长尾卡住了。
四、奖励延迟带来的三个工程后果
在线强化学习里,样本是旧策略生成的,奖励却可能在几个小时后才能结算,这时三件事必须显式处理。
其一是版本对齐。每条样本要带上生成它的权重版本与配置指纹,否则你无法知道自己是在第几版策略上做的更新。这不是可选的元数据,异步更新的一切偏差估计都建立在它上面。
其二是离轨度控制。用旧策略的轨迹去评估新策略,偏差随版本差距增长,工程上的手段是截断重要性权重,并给样本年龄设硬上限。上限该设多少要看任务时长量级:短任务可以只留当轮产物,长任务一旦把上限设得过松,梯度里就掺满过期轨迹。
其三是丢弃线。旧样本什么时候作废必须写进配置并且可查询,包括按最大存活轮数与按最大等待时长两种触发。丢弃要计数,否则事后复盘时”这批为什么不动”永远说不清。
五、失败样本的配额与可复现的最小集合
失败样本的比例是一个必须显式设定的参数。一个批次全是失败就没有梯度可用;把失败全过滤掉,模型学不会拒绝,会持续在根本不可完成的任务上消耗昂贵的环境时间。我们倾向于按任务类型分层设定保留比例,并把”无梯度中断次数”当成一个常驻监控项而不是异常事件。
可复现性要留的最小集合,比很多人以为的窄,也比我常见的实现更严格:环境镜像的摘要、随机种子、工具链版本、外部依赖的响应快照。四样缺一,事后就只能重现”大概的过程”。洹拓在给客户做训练侧交付时,会把这四样直接绑定到样本主键上,而不是放在构建日志里,理由是日志会滚走,样本还要被反复引用。
成本归因字段则决定这笔账能不能落到业务上。最少要有任务标识、租户、模型版本、重试次数,再加环境占用时长与外部调用次数,这样一张账单能回答”哪个客户的哪类任务、在哪一版权重上、因为重试多花了多少”。
六、核心交付物:调度、记账与留证字段表
下表是我们认为长时程训练管线在开工前就该定稿的字段,缺任何一行都会在跑起来之后变成临时补丁。
| 层 | 字段 | 采集点 | 判据或用途 |
|---|---|---|---|
| 调度 | 任务时长档位 | 入队时的预估器 | 分池并发上限,控长尾预留 |
| 调度 | 排队等待时长与提权次数 | 队列服务 | 饥饿判据,超线报警 |
| 调度 | 快照点序号与回滚损失 | 环境适配层 | 快照密度的权衡依据 |
| 调度 | 批次到齐口径 | 批次组装器 | 按累计交互轮数,不按任务数 |
| 记账 | 交互轮数 | 模型服务端 | 批次到齐与训练量单位 |
| 记账 | 环境占用时长 | 环境实例生命周期 | 成本归因与排队压力 |
| 记账 | 外部调用次数与配额余量 | 工具网关 | 限流与费用风险 |
| 留证 | 权重版本与配置指纹 | rollout 服务 | 版本对齐、偏差估计 |
| 留证 | 样本年龄与丢弃计数 | 经验池 | 丢弃线是否生效 |
| 留证 | 失败保留比例 | 采样筛选层 | 无梯度中断与拒学拒绝的折中 |
| 留证 | 镜像摘要、种子、工具版本、依赖快照 | 环境构建与网关 | 可复现四件套 |
上线前的四条验收判据,我们按能过与不能过二分,不做部分通过。任意一条样本能在事后还原到”哪个环境镜像、哪一版权重、第几次重试”,这是第一条。批次到齐判定不看任务数,被截断样本比例稳定在设定线内且可查询,第二条。样本年龄有硬上限,超限即丢弃并且有计数,第三条。失败样本的保留比例可按任务类型配置,无梯度中断次数被监控并报警,第四条。
这四条都不涉及算法好坏,它们只保证一件事:当训练不收敛时,你有办法先排除掉调度、记账和留证这三层的原因。对要按项目收费的交付来说,能把”为什么这批没涨”从玄学变成一个可查的字段组合,本身就是价值。