
用十分钟就测出意志力下降:这类人机对照实验要盯四个设计点
一、这类结论应该怎么读
据公开报道,有一项经过同行评审并在学术会议上介绍的研究发现,被试在依赖 AI 工具十分钟后,面对难题时的坚持度就出现下降。这项研究的团队名称、论文标题、样本量与效应量都不在我们能核实的范围内,所以我们不把它当成一个可以引用的定论,更不打算用它论证”AI 让人变笨”这种说法——那个结论它撑不住,任何单一实验都撑不住。
我们把它当成一份方法论提示。它提示的是:人机的对照实验已经能做到”十分钟级别”的观测粒度,而这恰恰是产品团队最该警惕的地方。粒度越细的短期效应,越容易被当成设计依据拿去用。真正决定一项这类研究能不能被产品团队借用的,是四项设计是否站得住;这四项目在内部实验里同样存在,而且内部实验通常做得更糙。
对做交付的我们来说,客户的 AI 辅助功能上线后要不要留、留哪一档,常常就在”感觉大家用得多”这一句话上拍板。把外部实验的四项检查反过来变成内部的实验规范,比争论那个结论本身有用得多。
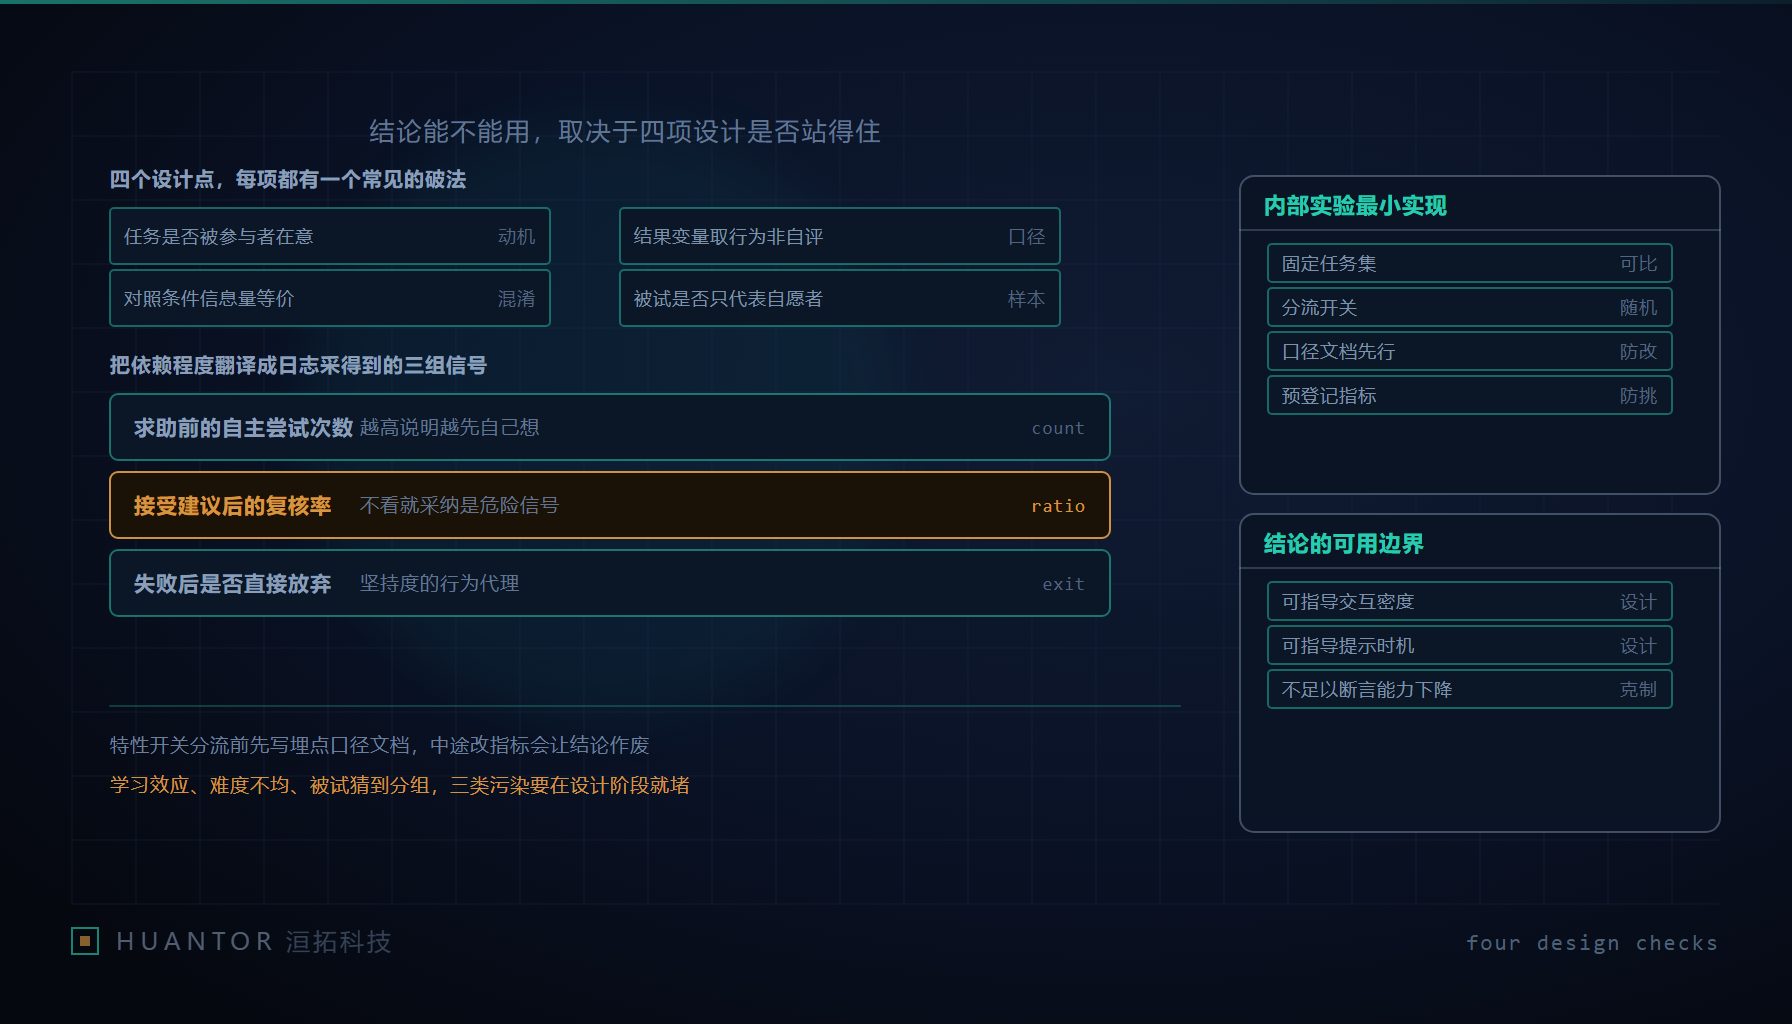
二、四个设计点,逐一检查
第一点:任务是否被参与者认为有价值。坚持度这个变量只有在被试真的想把题做出来时才有意义。如果任务本身被认定为”给实验方打工”,那么放弃的成本极低,测到的不是意志力而是配合度。检查方式是事后问卷里必须有一题问”你当时有多想把这道题做完”,并且把这一题的分数当作剔除条件,而不是背景信息。
第二点:AI 条件与对照条件的信息量是否等价。这是最容易翻车的一项。如果对照组只能自己试,而实验组能看到一段已经含关键线索的提示,那么两组的差别并不只是”有没有用工具”,还混入了”谁先看到了答案的一部分”。等价的对照要么给对照组补足同等信息量的非智能来源,要么把工具输出限制在不包含解题关键的形式。
第三点:结果变量是行为还是自评。坚持度可以是被观察到放弃前的尝试次数与用时,也可以是自我报告的”我觉得我坚持了一会儿”。两者经常不一致,自评还容易被实验目的污染。报告里如果同时出现两种,要看清结论建立在哪个上面。
第四点:被试来源是否只代表愿意做实验的人。在网上招募的被试,天然是对这类任务有兴趣、有时间、耐受重复操作的一群人。这个偏差不是说研究不能发表,而是说结论外推要收窄:它描述的是”愿意参加实验的人在这类任务上的短期反应”,不是所有使用者的反应。
三、把”坚持度””依赖程度”翻译成日志能采的信号
产品团队做不了随机对照试验,但可以做它的廉价近似,前提是把心理学变量换成事件名。我们一般用三组信号。
其一是求助前的自主尝试次数。用户在没有调用任何 AI 能力之前,自己提交了几次编辑、跑了几个用例、查了几次文档。它比”使用频率”更接近”愿不愿意先自己试”,并且能从会话与操作日志里直接算出来。
其二是接受建议后的复核率。AI 给出的结果被采纳后,用户有没有做后续验证动作:跑测试、比对来源、点开引用、手工改动。全盘接受且不复核,才是需要关注的形态;高使用量但高复核率,是健康的使用。
其三是失败后的下一步。第一次尝试失败之后,用户是换思路再来一次、去找文档、还是直接关掉或转去问 AI。这一项要把”失败”定义清楚,否则会把”用户主动结束”误记成放弃。
三组信号都必须先写成口径文档再埋点,包括事件边界、去重规则、什么算一次尝试。口径在上线后改过一次,这批数据在解释力上就作废了。
四、真实产品里的最小对照实现
内部实验不需要严谨到能发表,但需要严谨到结论不被自己骗。最小实现有四件事。
分流用特性开关,按用户或团队做稳定哈希,不按会话——同一人在同一实验里一会儿有工具一会儿没有,只会污染两侧。任务集要固定,至少准备一组难度可控、有明确完成判据的任务,让两侧被试面对的是同一批题;否则测到的差异可能只是题目分布差异。埋点口径先写文档再上线,把上面三组信号的定义、事件名和去重规则钉死。指标中途禁止修改,包括”看起来更合理”的修改;实在要改,重开一轮并保留前一轮的原始口径。
成本是可以压的,方法不是减少样本,而是减少变量:一次只测一个开关,任务集复用,判定标准用行为而不是自评,被试从内部同事与已有客户里招募(但要显式记下这一条带来的外推限制)。洹拓在给客户陪跑这类验证时,一轮小规模实验的开销通常能压到接近一次常规可用性测试,而不是接近一篇论文,靠的就是这条。
五、指标污染与去污
常见污染源有三个。学习效应:做过一次的人第二次明显更坚持,两侧顺序不一致就会把它读成工具效应,去污办法是同题只做一次、或者用完全等价的平行题。任务难度不均:难度分布偏了,坚持度的绝对值没有可比性,去污办法是按难度分档分别报告,不报总分。被试猜到分组:一旦参与者形成”用了工具就是懒人”的自我印象,行为会向印象靠拢,去污办法是削弱说明文案的引导性,并在事后问卷里加一题检查猜组率。
还有一个隐性污染源是需求本身:如果这个功能的上线结论早已内定,实验设计会被无意识地调向能证明它的方向。我们的对策是把”什么结果算不支持”写进设计单,在实验开始前就定,由没有主张的人签字。
六、核心交付物:内部实验设计单
设计单要短到能在一次评审会上从头到尾过一遍,但要覆盖变量定义、埋点字段和禁忌三块。下面是我们用的表头。
| 栏目 | 必须写清的内容 | 不写会怎样 |
|---|---|---|
| 假设 | 单个可证伪陈述,只关联一个开关 | 结论无法归因 |
| 任务集 | 固定题目、难度分档、完成判据 | 两侧比的是题目分布 |
| 主指标 | 行为口径定义,含事件名与去重规则 | 复盘时口径已漂移 |
| 求助前自主尝试次数 | 计入哪些操作、窗口时长 | 与使用频率混成一个数 |
| 接受后复核率 | 什么算复核、采纳如何判定 | 高使用量被误读为高依赖 |
| 失败后下一步 | “失败”与”主动结束”的边界 | 放弃率虚高 |
| 对照等价性 | 对照组获得的信息来源清单 | 差异混入信息量差 |
| 分流方式 | 稳定哈希粒度与排除名单 | 同人跨条件污染 |
| 禁忌 | 中途不改指标、不看未登记的辅助指标 | 事后挑数据 |
| 判负线 | 实验前写定什么结果算不支持 | 结论倒推 |
| 外推限制 | 被试来源、任务类型的人工声明 | 内部结论被套到全部客户 |
最后一条边界要说清:这类实验能直接指导的是交互设计层面的决定,比如默认是否自动展开建议、是否先要求用户自述思路;它只能间接指导”要不要长期投入这个能力”,后者需要跨季度的行为趋势,不是十分钟窗口能给的东西。把这两类结论混在一起用,是从外部研究到产品决策这条路上最常见的失真。