
一整柜机器共用一池内存:CXL 池化后要重算的是故障域
一、省下的单机内存条,会以新的故障形态回来
据公开报道,有存储厂商与芯片厂商在一个开放计算峰会上联合展示了用互联池化技术让多台 AI 服务器共享统一内存池的做法,目的是提升推理侧的内存利用并缓解供应紧张。双方的名称与展示场合只作转述,池的容量、带宽与延迟没有任何公开依据,本篇不做推断,也不假设这套东西已经在生产环境里量产可用。
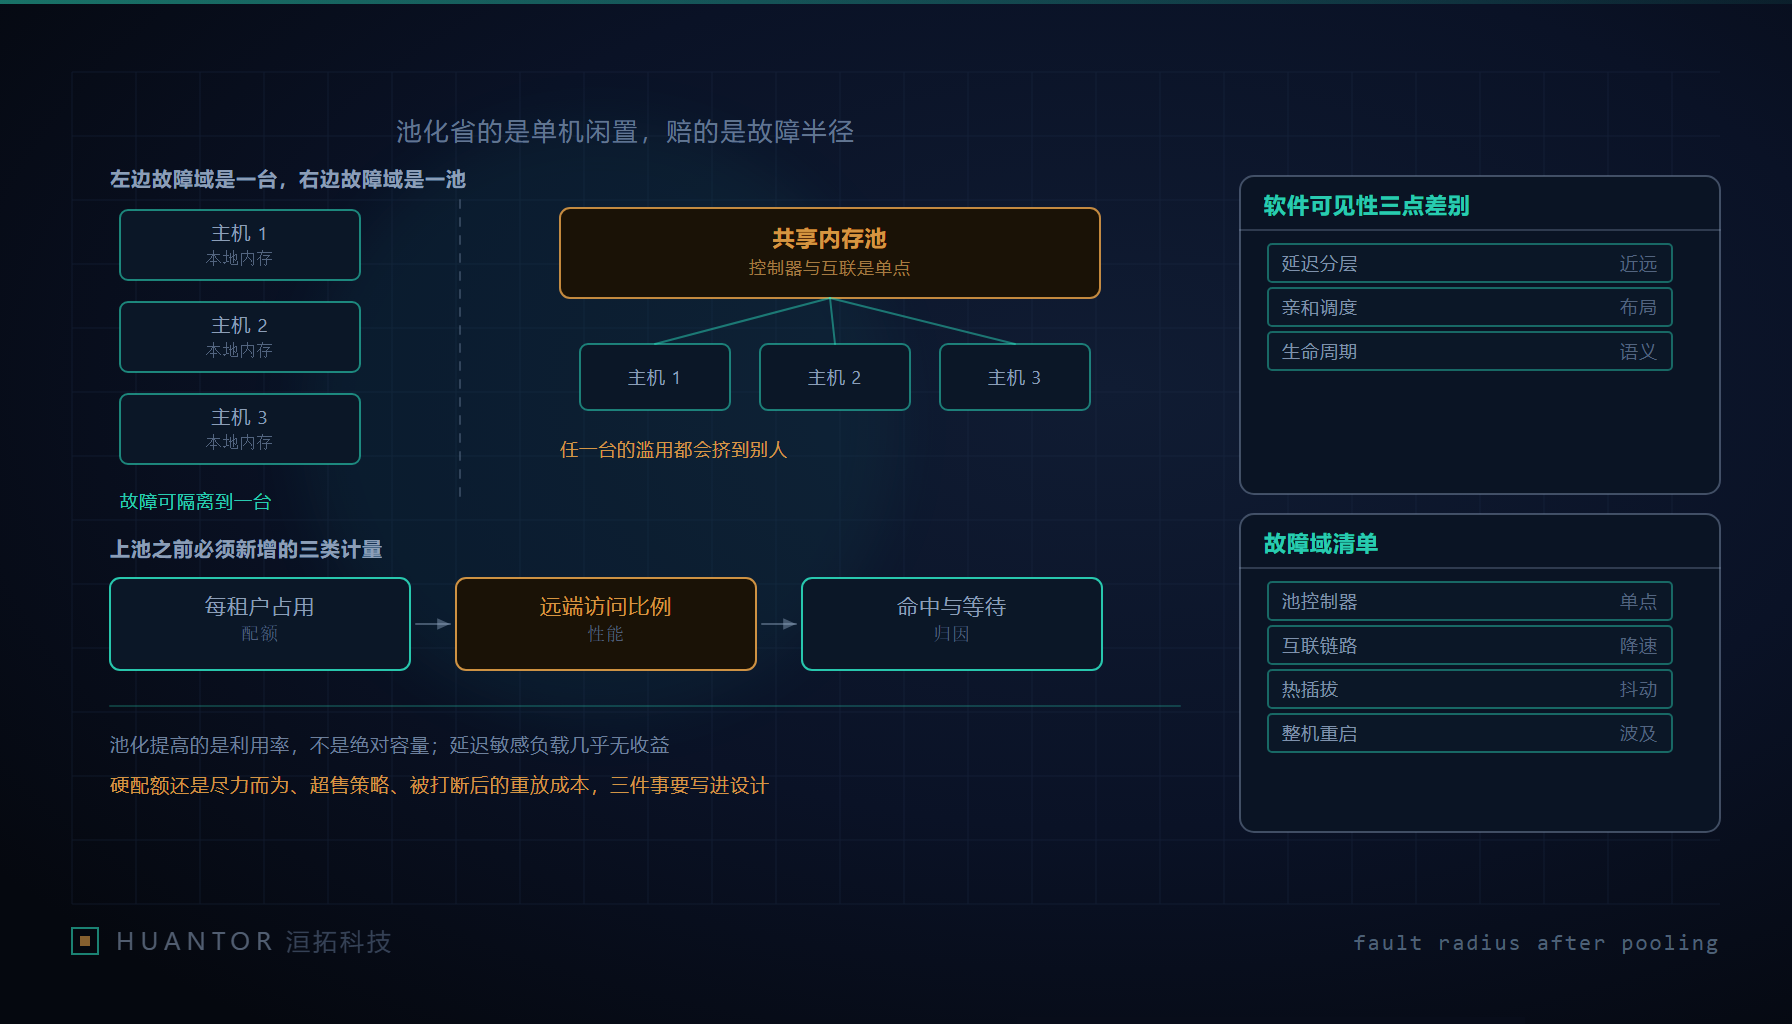
它值得写的地方在于:这类方案的卖点从来都是利用率,而利用率是一个会计科目,不是一个物理量。内存条从每台机器各留一份余量,改成大家共用一份余量,账面峰值立刻好看。可是同一次改动把两件事一起改变了——内存的分配权从主板的固件转移到一个池侧的调度者手里,故障的半径从一台机器扩大到共享这个池的一组机器。宣传里的好处属于前者,运维夜里被叫醒的原因属于后者。
对做后端和做推理集群的人来说,真正要重算的是故障域。洹拓在给客户的推理集群做容量方案时,把这条列为池化的第一个问题:省下来的钱会不会以赔付的形式回来。
二、软件能感觉到的三点差别
池化内存在应用眼里不是”更大的内存”,而是另一种内存。差别至少有三处,每一处都会改变代码的正确假设。
第一是延迟出现分层。本地内存的访问时间在单一进程里近似为一个常数,池化之后一部分访问要走远端,时间尺度不同。对普通业务这只是慢一点,对推理服务不是:解码阶段每一步都要读 KV 缓存,访问路径一旦落在远端,抖动会逐 token 累加,尾延迟比平均值先坏掉。第二是亲和性关系变复杂。操作系统原本按插槽和访问距离安排页的落点,池化引入了新的距离层级与调度者,原来那套自动放置策略并不必然把冷数据放到远端、把热数据留在本地,这层需要人来看。第三是地址与生命周期语义变了。本地内存的分配失败就是分配失败,池化之后一次分配可能排队、可能因配额不足被拒、可能在池侧被换出或回收;一段地址背后的物理页可能被移动甚至被别的租户抢走,靠”分配成功后就一直是我的”写出来的代码在这里会出错。
这三点合起来意味着:上池不是加一块设备,而是给软件栈增加一个新的存储层级。所有直接持有内存引用的组件——运行时、缓存管理器、序列化层——都要重新审一遍。
三、必须新增的三类计量
没有新计量就没法运营一个共享池,因为”谁抢到了多少”这个问题在没有数据时永远吵不清。下面是我们要求的计量字段表,三类计量都要落到时序库里,按池、按租户、按请求三个维度可聚合。
| 计量对象 | 必备字段 | 采集点 | 用途与告警判据 |
|---|---|---|---|
| 每租户占用 | 当前占用量、峰值、预留额度、超售比例、被拒分配次数 | 池侧控制器记账,与应用侧对账 | 判断是否存在单租户挤占;被拒次数出现即告警,不等容量耗尽 |
| 每请求池访问比例 | 该请求访问的字节总量中落在远端的比例、分布、耗时占比 | 运行时或推理引擎打点 | 定位尾延迟来源;比例随负载上升说明池内争用 |
| 远端访问命中率 | 期望留在本地的页实际在本地或远端的比例、失效原因码 | 内存管理层 | 命中率下滑通常先于容量告警出现,是提前量 |
三类里最关键的是第二类的”每请求”维度,因为它把池的状态和业务指标连了起来。运维只看池侧占用,会以为一切正常;用户已经在等一个被远端访问拖慢的请求。反过来,只有每请求的比例而没有池侧记账,就说不清是谁造成的。两类必须能对着看。
失效原因码这件事要单独提。池侧拒绝或回收一段内存时,一定要给一个枚举原因,例如配额超限、池内整体紧张、控制器主动重平衡、租户优先级低于竞争者。没有原因码,事后无法判断该扩容、该改配额还是该改应用。
四、故障域要按新边界重画
原来一台机器就是一个故障域:它挂了,只有它上面的进程受影响。共享池之后,故障半径要按下面这份清单重新画一遍,每一条都要在方案里写出影响面和检测方式。
- 池控制器:分配与回收的仲裁点。它失效时,最坏情况不是新分配失败,而是所有依赖池内存的实例同时失去可预测的行为;要问清楚控制器是否有冗余、切换时正在进行的分配怎么处理。
- 互联链路:链路降级时容量不变但性能变,故障表现是延迟与抖动而不是不可用,监控系统最容易漏掉这一类。
- 扩容与热插拔:加入或移出一个池成员时,是否要求已在使用该池的实例停机或重连;这是运维窗口的设计问题,必须在上线前问,不能在维护时问。
- 邻居噪声:一台机器的重启、一次大批量分配、一个租户的突发,会不会打断池上其他人;”我重启我自己的机器会不会影响别人”这个问题在池化之后必须重新回答。
- 配置一致性:池的拓扑与配额分散在控制器、固件与主机配置里,任何一处偏离都会变成偶发故障;要有一份可读出的期望配置与定期比对。
- 数据面残留:一段物理页从一个租户转到另一个租户时,是否保证清零;池化让这条安全边界从单机扩展到跨机,需要书面确认。
这份清单我们要求客户方、集成方与设备方三家一起过,因为它里面每一条都不完全在自己这一侧。
五、配额、超售与”缓解短缺”的真实边界
共享池能不能省钱,取决于隔离与超售怎么做,而这两件事是同一个决定的两面。
隔离的最小实现要分清硬配额与尽力而为。硬配额是容量保证,代价是池里会留着没人用的余量,省下来的钱被吃掉一部分;尽力而为是把余量全放出去卖,靠争用时的优先级和驱逐来兜底,省钱多但行为不可预测。我们的判断是混合:业务侧承诺了延迟或稳定性的部分必须硬配额,内部批处理可以尽力而为。配额单元也要定,按租户、按实例还是按请求,三者粒度和成本都不同。
超售策略要写成可执行规则,而不是一个百分比数字:池内整体紧张时谁先被限制、限制是被拒分配还是被降速、被降速之后多久恢复、恢复顺序是否公平。这些规则要能在监控里看到当前正在执行哪一条。
被打断之后的重放成本最容易被忽略。一次分配失败或一段被换出的缓存,应用要么重试、要么重算。推理场景里重算意味着这一轮的键值全部重来,代价可能比当初省下的那点内存贵得多。设计时要把”失败的代价”与”空闲的代价”放在同一张桌上比,只看后者必然超售过头。
至于缓解供应紧张这个说法,边界要看清:池化提高的是利用率,不增加绝对容量。它救的是”每台机器各自留余量、合起来浪费很多”这种结构性短缺,救不了”整个集群真的不够”的那种短缺。收益大的是波峰波谷错开、内存需求随请求长度起伏的负载,比如长短请求混跑的推理服务;几乎无收益的是所有节点同时逼近上限的负载,比如大规模离线批处理,那时候池里的余量会同时被抽干,争用比单机更早出现。
六、上池之前先做四个验证动作,再算三笔账
我们的验收动作是固定的四条,任一条不过就不进入生产。
第一,做邻居噪声实验:在池上给一个租户制造突发或直接把一台成员移出,观察其余实例的延迟分位与错误率变化,量化”别人出事我受多少影响”。第二,做生命周期压测:让应用长期持有大块内存,同时反复触发池侧回收与重平衡,检查是否出现段丢失、地址失效或行为不确定。第三,做配额拒绝演练:故意让一个租户超额,验证它是被限制、被拖慢还是把别人挤出去,同时验证告警是否带原因码。第四,做维护窗口测试:把一次控制器升级与一次成员扩容走完整流程,确认需要停哪些东西、需要多久、能否回退。
四条做完再算三笔账,三笔要并排写在同一个表格里,一笔一笔对齐后再比大小。一笔是省下的单机内存条,这是宣传里的收益;一笔是新增的互联设备、池侧控制器与配套的软件工时,这是显性成本;一笔是故障半径扩大带来的赔付与降级风险,这一笔最容易被漏,因为它不发生在正常日子里,只发生在一次跨机故障之后。第三笔要用第一节的邻居噪声实验数据来填,不能用感觉填。
池化本身是一个合理方向,内存这种资源按机器切死确实浪费。但把它接进生产的前提,是你已经能给”一整柜机器共用一池内存”这件事画出故障边界,并且知道边界内出事时向谁解释。