
缓存最危险的不是报错,是连不上时静悄悄返回空
一、“空”有三层,三层的判定方法不一样
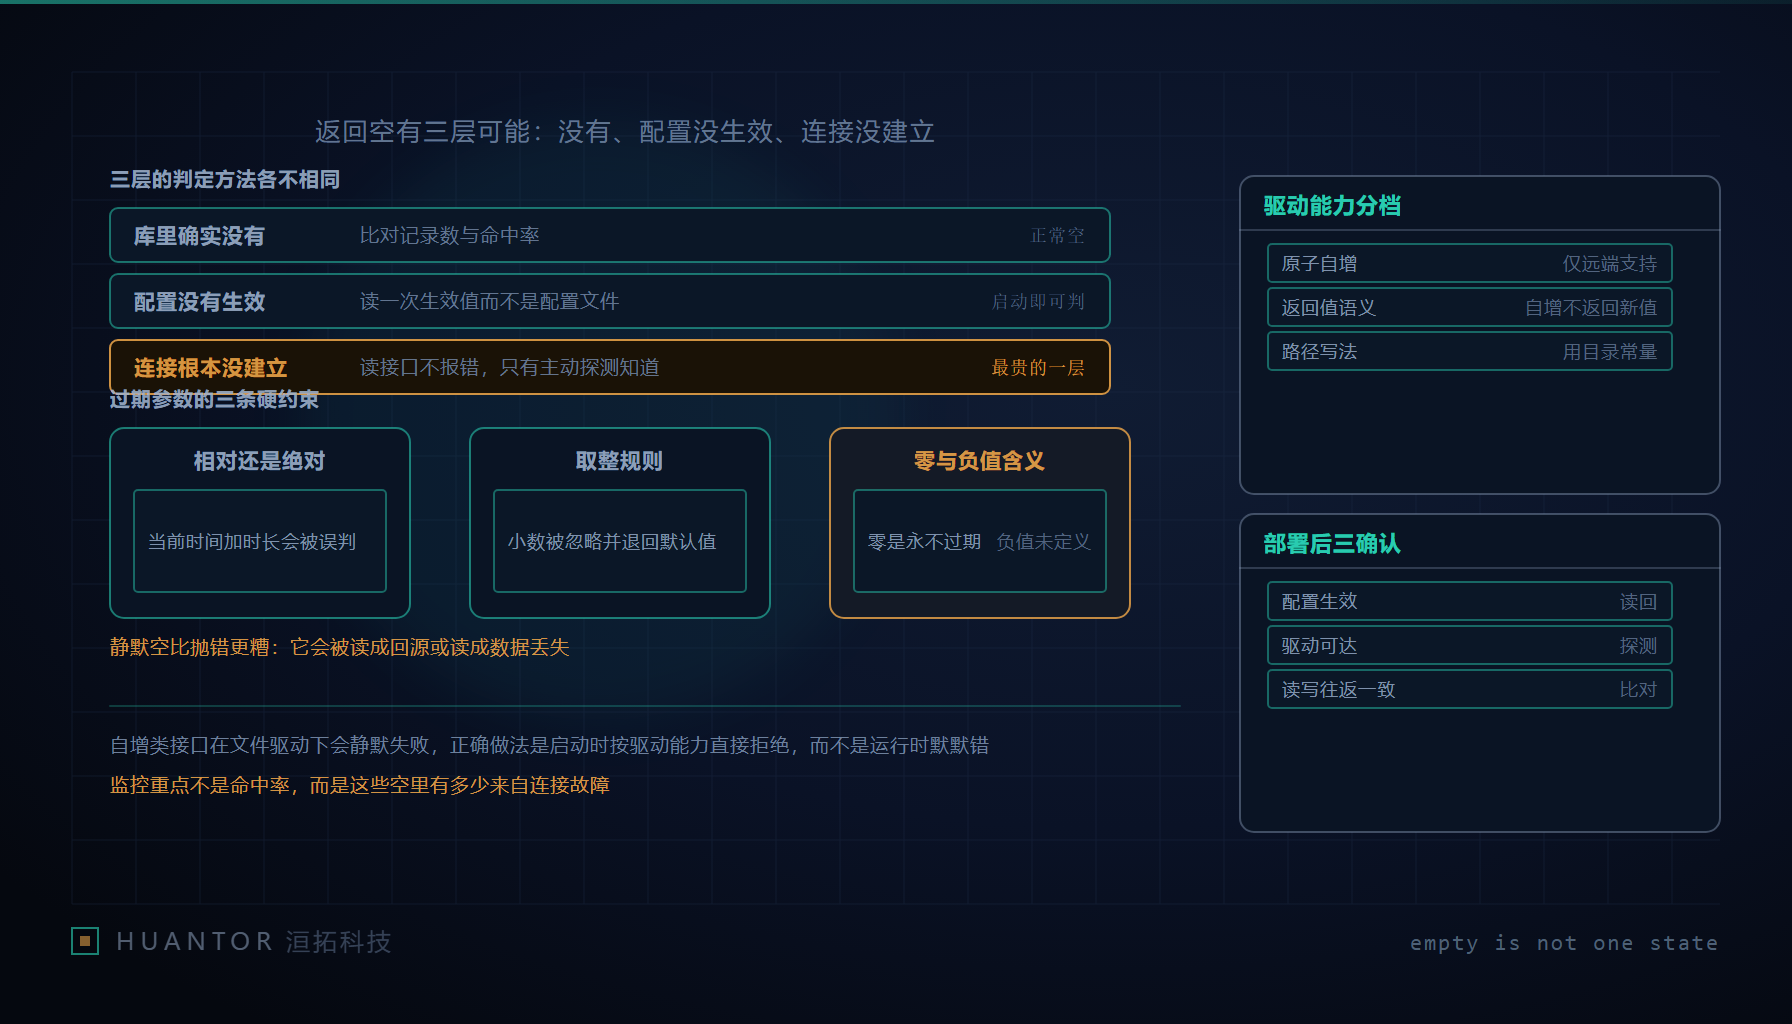
那篇排查记录的价值不在于它找到了某个配置项,而在于它把“读回来是空”这一件事拆成了三层:数据确实没查到;配置写了但没生效;连接根本没有建立。三层在业务代码里长得一模一样,都是一个空值,所以排查时必须用三种不同的动作去区分。
- 没查到。判定方法是回到源头对一次账:数据源里有没有这条记录,以及这一段时期的命中率是多少。源头有、命中率为零,说明不是“没有”,是缓存这条路根本没走通。
- 配置未生效。判定方法是读一次运行时真正生效的配置,而不是读配置文件。文件在磁盘上是静止的,装载路径可能有多条,两者的差别正是这类问题的全部来源。
- 连接未建立。判定方法只有主动探测:做一次显式的连通检查,把结果落成一条健康指标。因为按来源页的描述,这个框架的远端驱动连不上时,读取方法静默返回空值而不报错——业务读接口不会替你说这句话。
第三层最难,因为它是唯一一个没有任何异常替你说话的层。洹拓给客户排这类故障时,第一步永远是先补上这一条探测,而不是去翻代码里的空值分支。
二、静默返回空为什么比抛错更糟
抛错会触发告警,链路会中断,人会醒来。空值不会。空值会顺着两条合法路径走下去,而这两条路径的后果都不是“缓存层的问题”:一条是回源然后写入缓存——读侧拿到空、判定为未命中、去查数据库、把结果写回;数据库于是承担了本该由缓存承担的全部压力。另一条是直接把空数据返回给调用方——在业务上表现为数据丢失,而不是性能下降。
同一次连接故障,第一种表现是数据库被打满,第二种表现是“某些记录不见了”。两种表现都会被归因到别处去。这就是把“缓存不可用”和“缓存里没有”变成可区分状态的全部理由。四种做法按投入排:
- 探测式健康位:定时做一次显式读写往返,结果作为一个可告警的状态位,而不是散落在各次请求里。
- 给读方法加一个会把异常上抛的变体,并在封装层统一调用它。业务代码不该决定“要不要报错”,这个决定应该在封装层做一次。
- 命中率与回源率成对上报。只看命中率看不出问题,成对看才能发现“命中率下降同时回源率暴涨”这种形状。
- 给每一个空值打上来源标签:未命中、配置缺失、连接失败三类分开计数。这一条成本最低,但它把“空”从一个值变成一条可统计的原因。
三、写失败同样要单独判定,而它十有八九来自配置
来源页把 Cache::set 这类写入的三个参数(键、值、过期时间)讲得很清楚,紧接着给出了一句更实用的结论:失败根因几乎都是缓存驱动未初始化。这句话的排查含义是——写入不报错不代表写进去了。
连不上时写入同样静默失败,于是读侧看到的一直是空,形成“永远不命中”的假象,而所有成本被记在数据库头上。这是第二节第一条路径的加强版:它不只是把压力转走,而是让这套缓存从上线那天起就没有真正工作过,并且看起来一切正常。
配置侧的两条硬事实要写进部署手册。其一,这个框架的新大版本不再从应用主配置读取缓存配置,必须手工建立一份独立的缓存配置文件,并至少给出驱动类型;配置文件还留在原处并不等于它被读到了。其二,路径写法有讲究:文件驱动必需的存放路径推荐用运行时目录常量拼接,不要写相对路径——相对路径取决于进程从哪儿被启动,而这恰是部署方式一变就会变的东西。远端驱动必需的地址与端口属于第二类问题,只能靠第一节的探测覆盖。
四、过期参数三条硬约束,和一支统一的产出函数
第三个参数是这段配置里最容易写错的一个。按来源页的描述,它必须是正整数秒,含义是相对过期:写 0 表示永不过期;写“当前时间加时长”这类绝对时间戳,会被部分驱动误判从而立即失效;写带小数的表达式,有被直接忽略并退回默认一小时的风险。所以动态计算出来的值要先取整,再校验是不是正整数。
这三条可以归纳成任何过期参数都该确认的三点:明确是相对还是绝对;明确取整规则;明确零值与负值的含义。绝对时间戳被误判这件事给出的工程教训比它本身更值钱——接口不校验你的意图,它按自己的解释处理。因此这类参数要显式约束类型,不能靠口头约定。
浮点被忽略这一类行为不会写在任何报错里,识别方法只有一条:写边界值测试。取若干组输入(一个正常正整数、零、一个绝对时间戳形态的大数、一个带小数的表达式),写入后立即回读实际生效的过期时间并断言。不要靠肉眼去看配置里写了多久,配置里的数字和实际生效的数字是两回事。
团队约定层面,我们只留一条:过期时长只允许由一个函数产出,各处不许自行算。理由不在整洁,而在这三条约束的覆盖面——只要允许两处各算各的,就一定有一处算出小数或绝对值,而它不会报错。
五、原子自增:按驱动能力分档,能力不够就启动时拒绝
这一段是第二个静默失败。按来源页,自增方法不返回新值,需要再读一次;起始值为零时默认加一,可以传第二个参数指定步长;被自增的值必须是整数或可转成整数的字符串;而文件驱动不支持原子自增,会静默失败,只有远端类型的驱动真正支持。
文件驱动下自增静默失败为什么危险?因为计数类业务把“没生效”当成了“已生效”。少了的那部分不会报警,只会让后面的每一次判定都建立在偏小的数字上——限额、频次、并发配额,全在同一处偏。这类偏差的表现形式是“看起来比预期宽松”,几乎不会有人把它当成缺陷来提。
处置要往前挪到启动期:明确按驱动能力分档,在文件驱动下禁用自增类接口,并在启动时直接拒绝启动。这比运行时静默失败好得多,理由很简单——启动期失败是显式失败,只在部署时痛一次;运行时静默失败是隐性失败,会在每一次统计里留下偏差。
第二个问题在“先自增再读”这个组合上。自增不返回新值,读回来的可能不是你这一次的结果:两个并发各自自增后再读,可能读到同一个数,也可能读到别人那一次的。需要并发计数时不能用这个组合。替代方向两条:把计数交给支持原子返回的驱动,或者把计数落到数据库层,用带上界约束的更新语句完成“加一并判断有没有超”。选哪条取决于计数要不要参与决策,只要参与决策,就必须是同一条语句里定结果的。
六、前缀、启动期三确认,以及监控该看哪一项
可选前缀按业务分开是对的,但前缀这件事的坑不在配置里,在变更里:前缀一改,历史键全部失效。这不是“数据丢了”,是“数据全部变成未命中”,然后回源压力瞬间落到数据库上。所以改前缀要有“新旧前缀并行一段时间”的方案——读时先查新前缀、未命中再回退查旧前缀并回填,写只写新前缀,并给一个明确的退役时间;同时把前缀的版本号写进配置说明,让下一次改动知道自己面对的是什么。
启动期与部署后各做一次确认,三项:配置是否真的生效(读运行时生效值)、驱动是否可达(显式探测)、读写往返是否一致(写一个探针键再读回,再对探针键做一次自增并读回)。这三项要放进健康检查,并在灰度阶段就跑一次,不要等到全量之后。
给客户的运维建议只有一句话:缓存层的监控重点不是命中率,而是“读到的空里有多少来自连接故障”这一项。命中率下降有很多原因,而这一项决定你会不会被一次缓存故障误导成数据库问题——第二节的两种误判,全都发生在没有这一项的时候。