
假设变便宜之后,科研的瓶颈搬到了实验这一侧
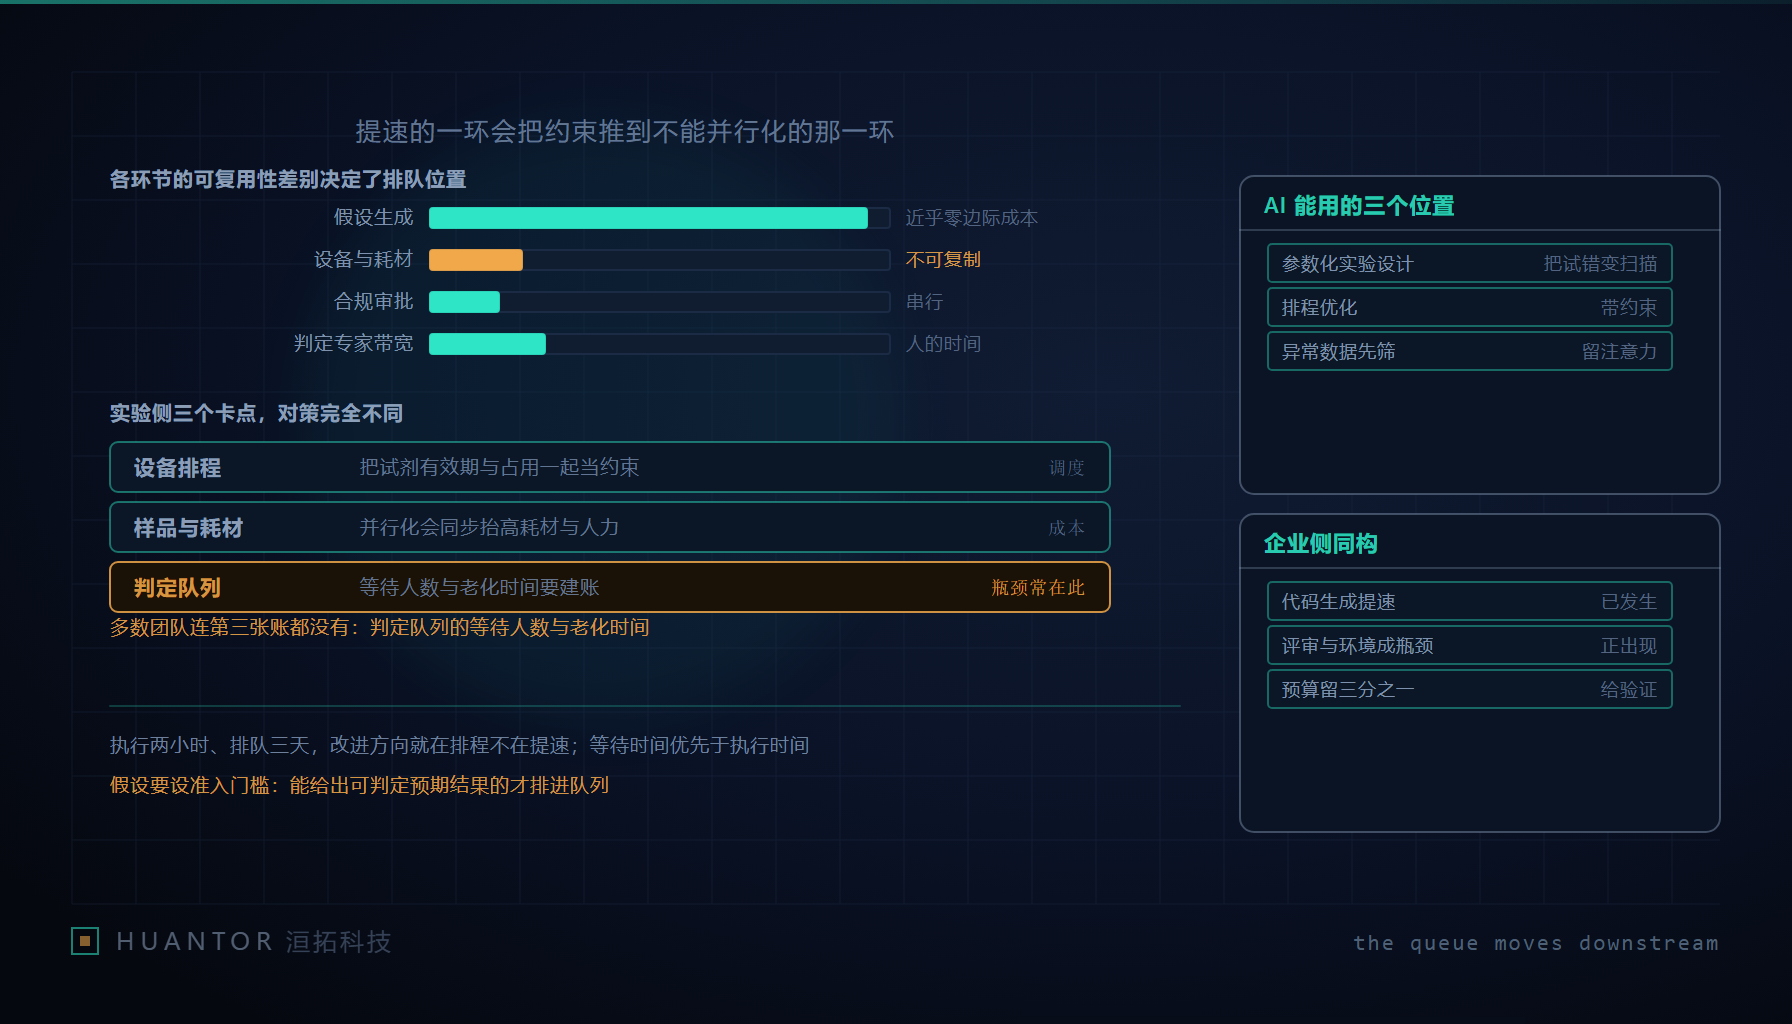
一、瓶颈不落在最贵的一环,落在不能并行的一环
有一份由研究机构与高校联合发布的报告给了一个判断:让模型把假设生成的成本压下去之后,约束跑到了实验这一侧。这里不评价任何机构的研究质量,也不引用它没给出的任何数据,只看这句话的结构——它描述的是所有流水线都会走的一条路:某一环的产出速度被提上去,整条链的约束就搬到下一个还没提速的环节,而那个环节通常是物理的。
定位瓶颈有一条不太直观的准则:它不在最贵的一环,在不能并行化的一环。
- 可以近乎零边际成本复用的环节:假设生成靠模型,多问一百个问题,代价只是多一点算力与一点等待。
- 天生不可复制的环节:一台设备只有一份机时,一批耗材只有一次寿命,一次合规审批只有一条流程,一位专家一天只有那么多小时。
排队一定出现在后一类。前一类提速十倍,后一类的吞吐不会跟着涨,只会把队列拉长——而且拉长的那一段是看不见的,因为它不占用任何人的执行时间,只占日历。所以该讨论的不是“还能不能再快一点”,而是“哪些资源不能被复制,它们现在被谁占着,被占用的那部分里有多少其实是在等”。
二、实验侧被卡住的三个位置,对策不一样
笼统说一句“实验慢”没法优化,因为三个位置的瓶颈机理完全不同。
| 卡点 | 慢在哪里 | 对策方向 |
|---|---|---|
| 设备排程 | 高档设备台数少、单机时贵,占用被临时插队切碎,换型时间没人记 | 预约制加占用台账,把换型与校准时间显式计入成本;插队要有成文规则,写清谁可以插、插进来之后谁被推后 |
| 样品与耗材准备 | 前处理是手工的,批量受试剂批次与有效期限制,容易在中途作废 | 把前处理当独立工序排产,与试剂有效期、样品可存放时长一起进约束条件 |
| 结果判定的专家带宽 | 数据已经出来,但没人判,判定在排队 | 判定队列与老化监控,把其中可以标准化的部分先写成可判定的规范 |
三个位置的共同点是都在等人或等设备,而不是等计算。这和软件流水线上看到的现象一模一样:一条链慢,多数时候不是算得慢,是交接慢。
三、要把它当系统管,先建三张账
把实验侧当成一个可度量的系统,最小配置是三张账,而多数团队连第三张都没有。
- 设备占用与空闲率。记的不是开机率,而是有效占用与换型、等待之间的比例;空闲与拥挤都要按型号和时段分桶,一个总览数字会把最挤的那台完全掩盖掉。
- 单次实验的端到端周期,以及各环节的等待时间。每一步要分开记两段时间:“开始到结束”是执行,“提交到开始”是排队。只有前者报表的团队,等于默认排队不需要负责。
- 判定队列的等待数量与老化时间。队列长度是表象,最老那一条已经等了多久才是风险信号。
这里有一条规律同样成立:等待时间比执行时间更值得盯。举例说,一个实验执行两小时、排队三天,改进方向在排程而不是提速——把执行压掉一半,总周期还是三天;把排队从三天降到半天,总周期掉一个量级。多数团队只报执行耗时,原因很实际:那个数好取;排队时间要跨系统对齐时间戳,难取。于是所有优化都朝已经不难的那个方向去,越优化越不见效。
四、四类提吞吐的做法,与模型真正站得住的三个位置
提高实验吞吐的办法只有四类,每一类都有自己的代价,不能只列收益。
| 做法 | 收益 | 代价与适用条件 |
|---|---|---|
| 自动化设备投入 | 到位之后可长期复用,对高频重复工序最划算 | 资本高、柔性差,流程一改动就要重调;适合工序稳定的场景 |
| 并行化样品 | 看起来最直接,一轮出多份结果 | 耗材与人力同步上升,瓶颈常被推到前处理与判定这两步 |
| 外包 | 短期内扩容最快 | 周期与质量不可控;判定标准必须在交接前写成可验收条款,否则收回一堆用不了的结果 |
| 自动化判定 | 收益最大,能直接松开专家带宽 | 最难,因为它要求先有可判定的标准;多数环节卡的不是算法,是“什么算合格”没写清楚 |
模型在这条链上有三个位置真正站得住,而且三处都不涉及替人做判断。
- 实验设计参数化:把“试一个点”变成“扫一组点”,让参数空间可枚举,让每一次实验的设计本身可读、可复现、可比较。
- 排程优化:把设备占用、试剂有效期、样品可存放时长一起当约束求解。这一条的收益常常超出预期,因为它动的是等待而不是执行——而等待才是那个量级。
- 异常数据先筛:把明显不需要人看的先分出去,让专家的注意力留给少数关键样本,而不是让判定队列被无需判断的东西塞满。
五、假设变便宜之后,第二个问题自己会冒出来
约束搬到验证侧之后,有两件事会同时发生:要验证的东西数量上升,而验证标准会不自觉地放松——“这一条大概不值得认真看”的判断,会随队列变长而变得越来越草率。这两件事叠加,返工是必然结果:一条没被认真拒掉的假设走到后面,消耗的是设备时、耗材和判定人,全都是不可复制的那一类。
所以要给假设排进队列设一道准入门槛:只有能写出可判定预期结果的,才允许占用验证资源。写不出“如果成立,会在哪个量上看到什么差别”的,退回补充,不进队。这一条看着像方法上的洁癖,实质是容量管理——它是唯一能从输入端管住验证队列质量的手段。
过了门槛的按三档排:低成本可判定的优先跑,先把能确定的东西确定下来;高成本高风险的排在后面,并要求先写明止损条件;仍然无法判定的直接退回,不占任何资源。三档之间要有升降规则,允许一条假设拿到中间结果之后重新定档,否则分类会退化成一次性的判决。
六、企业 AI 落地是同一条曲线
这条链我们在自己的项目里天天见到。代码生成被提速之后,瓶颈立刻迁到三个同样不可复制的位置:评审人的带宽、测试环境、发布队列。三张账一一对得上——环境的占用与空闲率、一次变更从提交到上线的端到端周期与各环节等待、评审队列的等待数与老化时间。对策也同构:给验证环节扩容,并把验证做成可以并行的一等对象,而不是把生成再提速一次。
洹拓把这条结论落成两件具体的事。一是把测试环境与设备当共享资源管:建台账、上预约、占用与空闲分开统计,任何独占环境的申请都必须带到期时间,到期自动回收。二是把评审带宽当容量做排队与限流:评审等待时长进报表,按人、按模块分桶,超过阈值就在合并请求的源头限流,而不是让队列无限制变长。这两件都不是新技术,是承认验证侧有容量上限,并且把这个上限记下来、当成排产输入。
给客户的那句话我们也按同一口径说:AI 项目预算里至少留三分之一给验证与观测。省掉这一块的团队,最后都会以返工的形式把它补交出去,而且单价更高——返工占的正是那些已经排满的设备时与评审队列。瓶颈搬家并不可怕,搬完还照老地图排产才可怕。