
把 PDF 版式转成网页模板:还原到哪一层才算合格
“把这个 PDF 做成网页上的模板”,这句话在单证、报表、合同类需求里出现得很频繁,返工率也高。原因通常不在实现能力,而在双方默认的完成标准不是同一层:需求方说的往往是”打印出来和原来一样”,交付方理解成”页面上看起来一样”,测试时又变成”数据能不能填进去”。三个目标的技术路径互不兼容,越到后期越难切换。
在讲分层之前先把结论放前面:企业交付里的绝大多数这类需求,正确的选择是视觉近似的模板加严格的字段级验收,而不是忠实还原版式。理由在下面几节里会逐条展开。
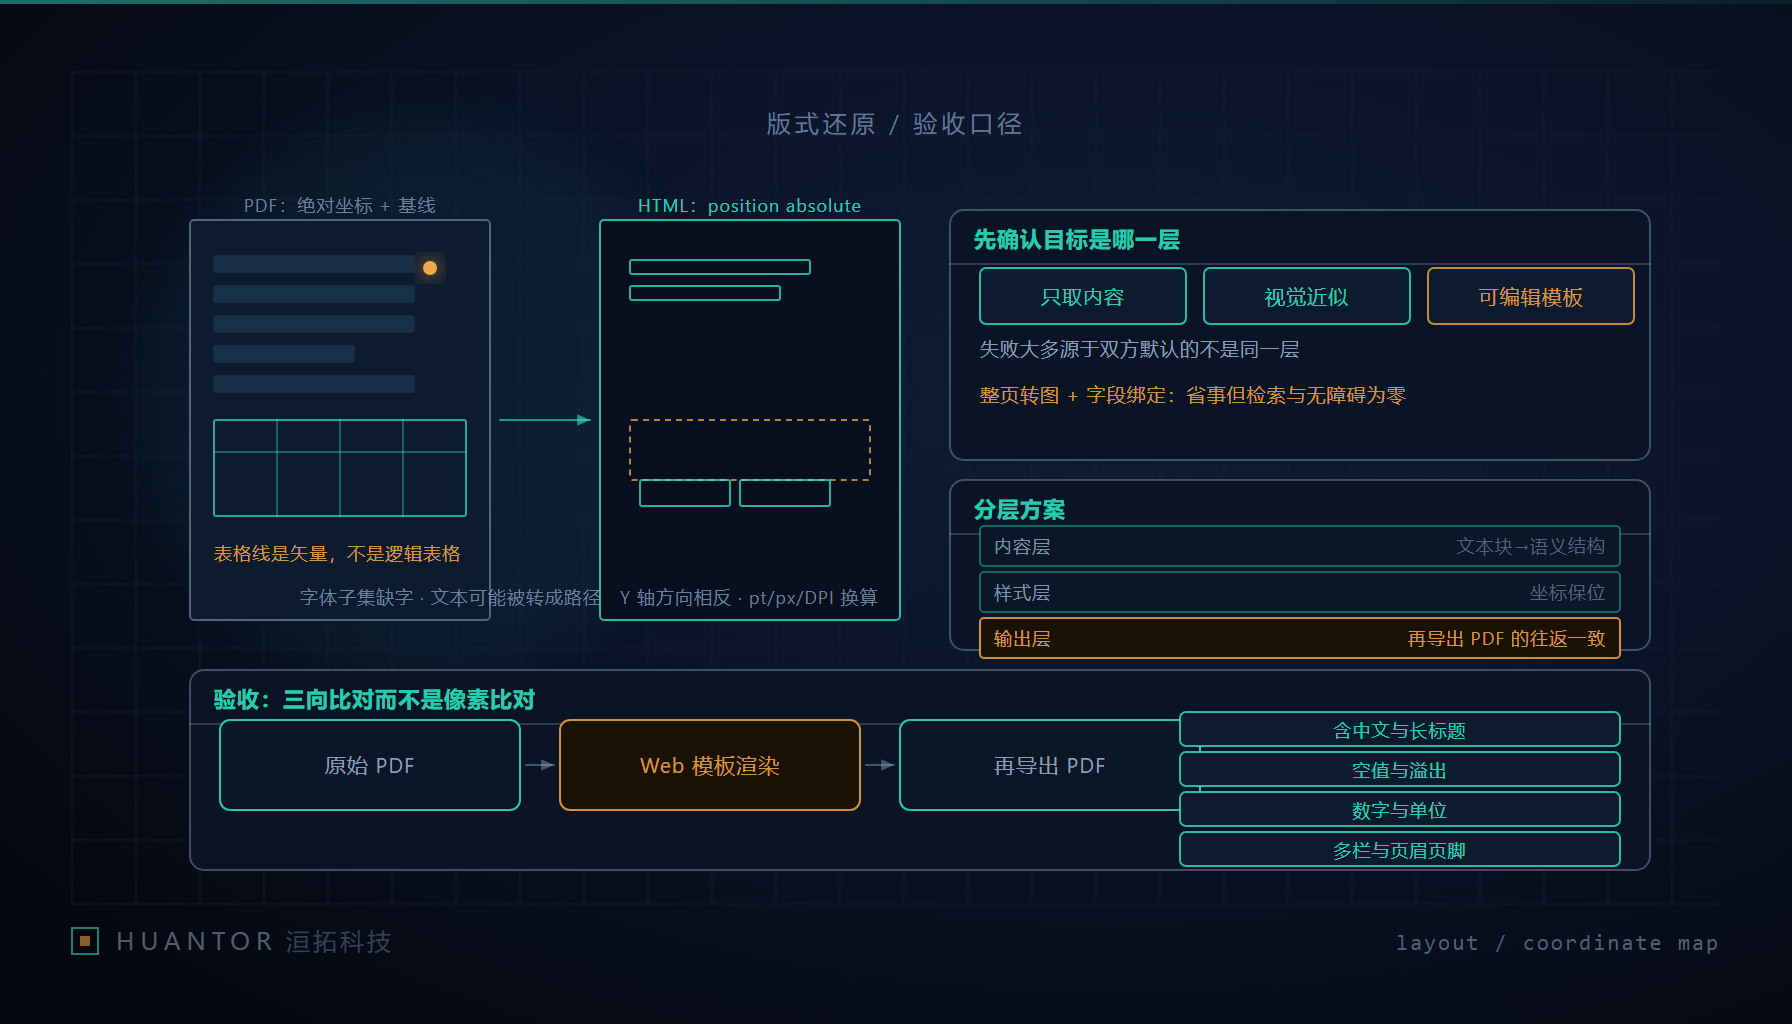
一、先分清三种目标
| 目标层 | 交付物 | 数据从哪来 | 验收方式 | 典型失败表现 |
|---|---|---|---|---|
| 只取内容 | 结构化文本与语义字段(标题、段落、表格、键值对) | 解析文本块,丢弃位置 | 字段是否齐全、顺序是否符合阅读逻辑 | 段落顺序错乱、表格被拆散 |
| 视觉近似 | 页面上位置与观感接近原稿的静态模板 | 模板本身不带数据 | 与样张叠图对比,人眼判断 | 换行位置漂移、字号偏移、跨页断行 |
| 可编辑模板 | 字段可填、数据可绑定、可再导出的模板 | 数据模型驱动字段填充 | 用同一份样例数据做往返比对 | 字段与数据错位、溢出未处理 |
三种目标里,第一种最便宜,第三种最贵。需求确认时要拿到一份带真实数据的样张,问清三件事:这份模板要不要参与打印留痕;用户是否要在网页上修改内容;导出的成品是否要和原始 PDF 逐字段一致。这三个答案直接决定落在哪一层。
二、PDF 的结构决定了还原的成本在哪
PDF 不是一种面向”内容结构”的格式,它是一份绘制指令清单。这个本质带来六个具体难点,按踩到频次排序。
第一是坐标定位。文本元素记录的是基线上的起点位置和字号,页面坐标原点通常在左下角,Y 轴向上。网页的盒模型原点在左上角,Y 轴向下。这个翻转要在所有位置计算里体现。
第二是字体子集与缺字。PDF 里的字体常以子集嵌入,只包含用到过的字形。文本提取依赖字体自带的映射信息(ToUnicode 之类的对应表),缺失时提出来的是无意义编码。生僻字、异体字在原稿里可能本身就是缺字占位,转换后会被替换成别的字形,看起来”有字但不对”。
第三是文本可能已经不是文本。转曲(把字形画成矢量路径)之后,页面上看到的”标题”由路径填充指令构成,解析器读不到任何字符。这类文档只能靠 OCR 或者干脆按图片处理。
第四是间距信息。字距调整与连字在文本显示指令里以位移调整的形式表达,直接按字符序列拼接会丢掉视觉间距,也可能把一次连字读成一个不存在的字符。具体位移量的单位与缩放方式在不同规范版本里有细节差别,处理时以所用格式的规范文档为准。
第五是图形化的表格线。表格里的一条线在 PDF 中是路径对象,不是逻辑上的行列边界。要还原成可编辑表格,必须把线与矩形的坐标聚类出行列结构——这一步的复杂度远高于渲染它。
第六是内容流顺序不等于阅读顺序。多栏排版、页眉页脚、水印、侧边标注,在指令流里的先后取决于绘制顺序。按流顺序取文本会得到跨栏串行;页眉页脚还会在每一页重复出现,需要识别跨页重复元素并从正文序列里剔除。
三、整页图加字段框,常常是更划算的方案
把每页渲染成位图作为底图,在需要填数据的区域叠一层可定位的字段框——这条路实现快、观感可控,代价要如实写清:内容不可检索、放大后失真、屏幕阅读器读不到任何文本、字段位置绑定在纸张坐标上(原稿版式一变就要重新对位)。
判断能不能选它,看三点。这份文档是否只用于打印或存档,不需要被搜索与复用;字段位置是否稳定(同一套模板,只换数据);是否有无障碍与合规要求——面向公众的服务单据、需要被辅助技术读取的表单,这条路基本走不通。反过来,如果只是”内部单据套打”,用整页图比硬啃 HTML 忠实还原更稳,因为后者会在字体度量差异上反复消耗工期。
四、分层实现:每层用不同的手段,不要混在一起
| 层 | 常见手段 | 主要风险 | 怎么验 |
|---|---|---|---|
| 内容层 | 文本块与坐标聚合成段落、字段、行列 | 阅读顺序错、表格线被当正文 | 与原始 PDF 的文本抽取结果做字段清单比对 |
| 样式层 | 绝对定位元素或 SVG 保留位置 | 换行漂移、字号度量差异 | 与样张叠加对比,看边框与基线偏差 |
| 交互层 | 字段绑定数据模型,模板与数据分离 | 字段与数据错位、溢出未处理 | 边界样本清单逐条跑 |
| 输出层 | 再打印或导出 PDF,检查往返一致性 | 分页位置变化、字体回退 | 同一份数据导出两次,比对字段值 |
分层的关键是把”位置”这件事关在样式层里。数据模型只认字段名,不认坐标;坐标只在渲染时绑定到字段。一旦坐标进入数据层,模板改一次就要重做一次映射。
单位换算在前端是最容易出错的地方,把规则写成一处常量而不是散在各组件里:
// PDF 用户空间 1 单位 = 1pt;CSS 参考像素 1px = 1/96 英寸 |
这段换算只在”逻辑尺寸”层面成立,物理清晰度取决于设备像素比与打印分辨率,两件事不要混:屏幕上的 4/3 系数解决不了打印时的点阵差异。页面尺寸要确认取的是哪个框(不同框表达裁切与可打印范围,取值不一致会导致整体偏移)。
框架层面要注意的三件事:绝对定位的模板层最好包在一个固定尺寸、可整体缩放的容器里,页面用 transform 缩放而不是重算所有坐标;字段渲染成受控组件,值来自数据模型,不要让模板 DOM 自己保存状态;长文本的溢出策略要显式声明——自动缩字、强制换行、换页三种选一,默认不换会静默丢字。字体度量差异导致的换行位置漂移无法彻底消除,原稿字体与运行环境字体不同时,同一行的可容纳字数就会变,稳妥做法是模板内嵌所需字体并保留余量,同时把”字段值超宽”当成一条必测边界。
五、验收怎么定:三向比对和边界样本
不要用像素一致性做验收标准,像素比对会把字体渲染差异全部报成缺陷。可用的做法是同一份样例数据走三次:原始 PDF 抽字段、HTML 模板渲染、再从页面导出 PDF,三方做字段级内容比对,位置偏差只按”是否影响可读与可打印”分级判定,而不是按像素阈值。
比对之前要有基线:一份人工确认过字段清单的样张,字段名、类型、是否必填、空值时显示什么,都定下来。没有这张清单,任何自动比对都在比”两个错法是否一致”。
边界样本清单要提前准备,缺一项验收就不完整。
- 含中文长姓名与生僻字的字段,验证字体子集缺字时的表现。
- 数字带千分位、货币符号、全半角混排,验证提取与渲染时的字符归一化。
- 超长标题与超宽字段值,验证溢出策略是缩字、换行还是丢字。
- 空值与占位(空白、下划线、”无”三种写法各一份),验证模板不会画出多余符号。
- 行数超过一页的表格,验证跨页断行与表头重复。
- 带签名、印章、水印图像的页面,验证图像层与字段层不互相遮挡。
- 同一份数据的两次导出,验证往返一致性(字段值不因中间渲染而变化)。
- 若有多语言版本:日期与数字格式差异、文本变长后的布局撑破。
合规相关的两条要单独强调:面向公众或需要留痕的表单,不能只出图片;文本必须可被选中复制、能被辅助技术读出,字段的标签关联要在交互层做,不是靠图上的视觉位置暗示。
六、洹拓视角:把”还原到哪一层”写进合同附件
单证与报表模板化是这类需求在企业交付里最常见的形态。我们踩过的坑不是技术上做不到,而是验收条款含糊导致工期不可控——“要和原来一模一样”这句话无法执行,也无法结束。
有效的写法是把还原层级拆开谈:内容层要求字段完整无丢,样式层要求关键区域(表格线、签字栏、页码位置)偏差不影响套打对齐,交互层要求字段可绑定可修改,输出层要求导出件与样张字段级一致。四层各给判定方式,其中只有输出层需要”看起来像”,其余三层都是可枚举的检查项。
选择近似方案时也要提前告知代价,写清楚三项放弃的东西(可检索性、放大清晰度、无障碍),并让需求方确认这份文档不需要它们。这个确认动作比任何还原技术都更能减少返工——多数争执不是发生在实现阶段,而是发生在”原来这条路是不能搜索的”这句话第一次被说出口的时候。