
给机器人当“老师”的人:数据采集的班次、一致性与流失
一、把操作员当成一台需要标定的传感器
据公开报道,出现了一个按天结算的新岗位:数据采集员反复演示叠衣服、铺床单、洗碗、给快递贴标签这些日常动作并记录下来,有人觉得新鲜,有人做一段时间就走。这些描述不是下面判断的依据,这类报道也容易被写成职业猎奇,但它对做具身数据的人只有一个含义:数据的一致性上限,由一支流动性很高的人手决定。
这句话不是在评价任何人。同样一件上衣、同样的口头步骤,两个人的起手顺序、力度节奏、停顿位置就是不一样,这是人的固有差异,跟熟练度和态度无关。工程上的处理方式是把它当作一台噪声可测但不可消除的传感器来管理:不去要求人变成机器,而是把差异压进可控范围,并且让每条数据都带着“是谁、按哪一版任务卡采的”这种可追溯信息。
按天结算这一条尤其要紧。结算周期短,意味着采集方的队伍每周都可能换人,任务规则的传递不能靠班组口述,只能靠纸面字段和上岗前的对照测试。
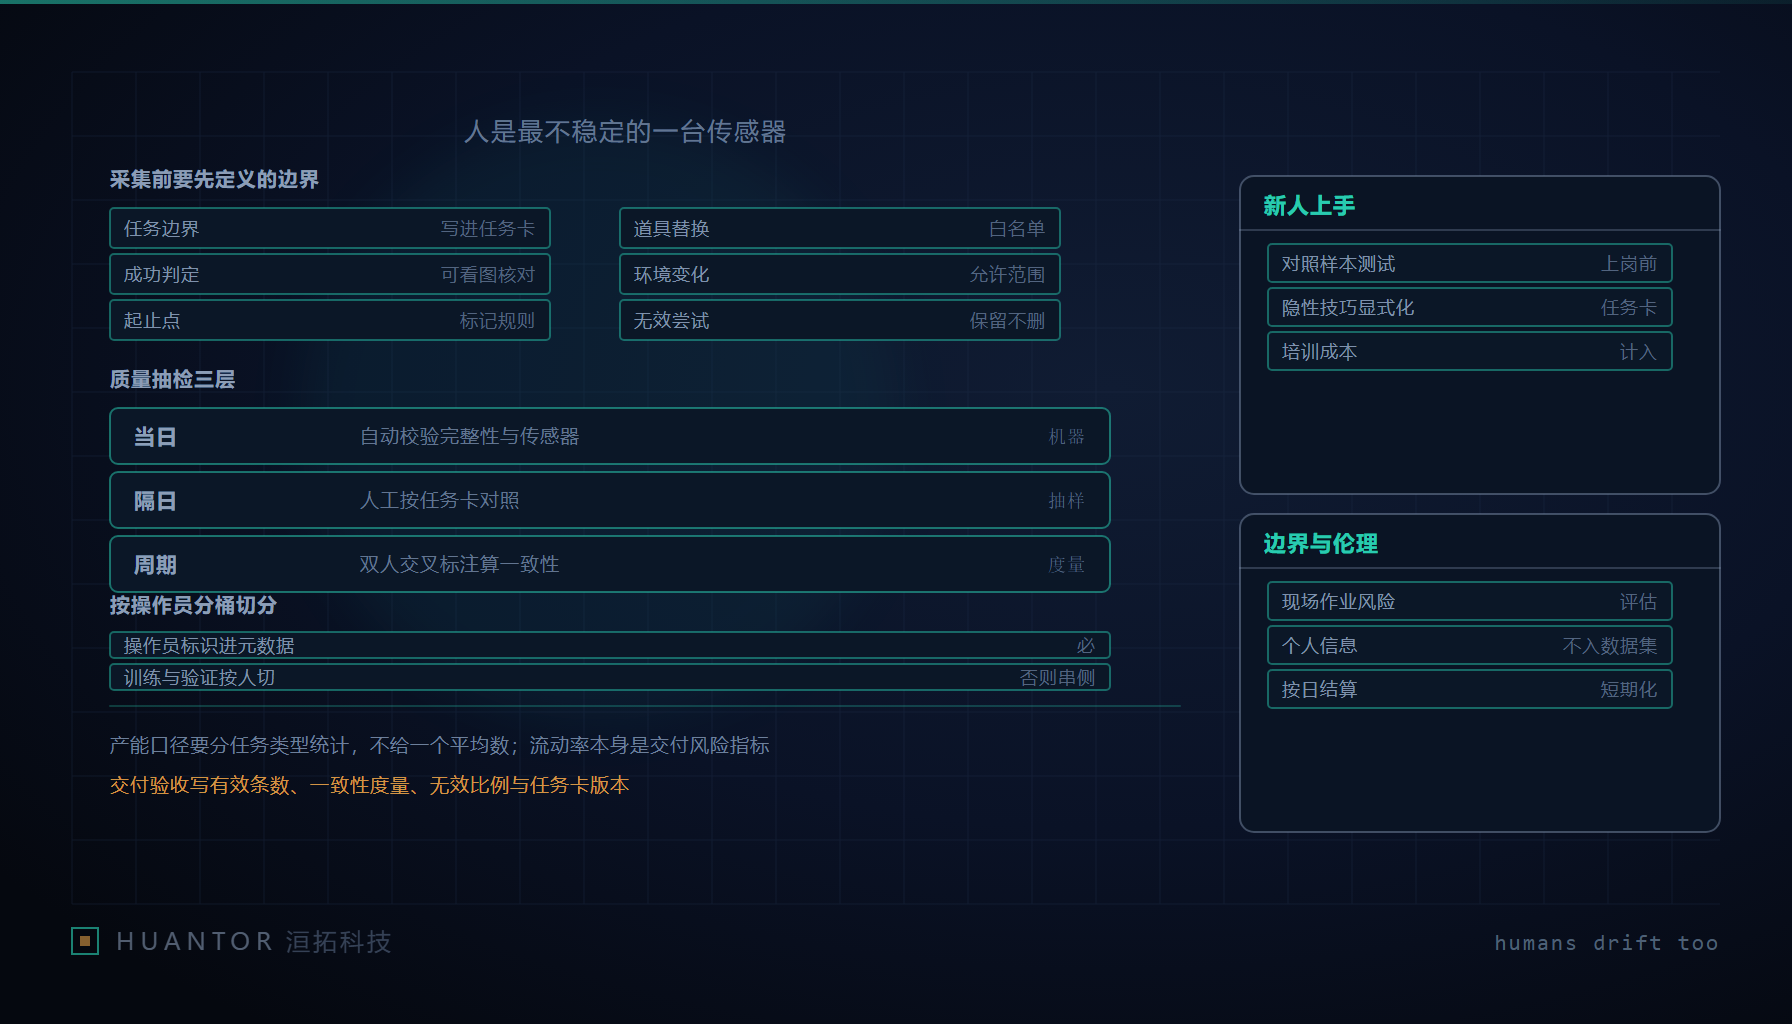
二、采集开工前要先定死五件事
这五项在开工会上经常被跳过,理由是“动作这么简单,谁不会”。跳过之后,返工全落在事后。
- 任务边界:这道题做到哪一步算完成。叠衣服是把衣服折成方块,还是折完再归位到指定位置;洗碗是冲洗干净,还是含摆放回架。边界不同,轨迹长度和终止判据完全不同。
- 成功判定:由谁、依据什么判成功。判定标准必须能在录像上一眼核出,不能依赖“看着顺不顺”。
- 动作起始与终止点:一条样本从哪个姿态算开始,到哪个状态算结束。起止点漂移会让同一任务在不同人手里产出长度差一大截的片段。
- 允许的道具与环境变化:换个颜色的毛巾算不算变化、桌面物品挪位置算不算、光照改变要不要重采。允许范围要写死,否则每个人自己决定。
- 无效尝试怎么处理:失误、犹豫、半途重来的片段要保留而不是删掉,标注为无效并写明原因。删掉等于告诉模型“世界从来不失败”。
第五项最反直觉,也最值钱。真实机器人部署时最缺的恰恰是恢复行为的数据,而这些数据只有在采集端允许失败并且保留失败时才存在。
三、一致性从哪几处来:任务卡最小字段
一致性不是靠人自觉,而是靠把差异的入口逐个堵掉。任务卡是主要工具,最小字段我们只认这几项。
| 任务卡字段 | 作用 | 缺失时的典型后果 |
|---|---|---|
| 步骤图示与文字说明 | 固定动作顺序口径 | 每个人按自己习惯的路径做 |
| 起始状态照片 | 固定初始摆放与朝向 | 同一任务出现多种起点分布 |
| 参考视频样例 | 传递节奏与力度这类说不清的部分 | 文字口径一致,实际轨迹差很多 |
| 道具清单与替换规则 | 控制物体侧变量 | 换材质后摩擦差异被当成任务难度 |
| 环境光照与机位要求 | 控制视觉侧变量 | 光照变化被模型读成场景变化 |
| 任务卡版本号与生效日期字段 | 让每条数据能追溯口径 | 事后无法解释口径变更点 |
| 无效判定示例 | 统一“什么算废”的标准 | 无效样本比例随人波动 |
其中“道具清单与替换规则”和“任务卡版本号”最常被省掉。前者是主要噪声源,同一动作在不同材质上轨迹差别明显,如果不写替换规则,采集员会随手替换,批次之间就混进了没登记的变量。后者影响更大:任务卡改了没留版本,等模型效果异常回查时,没人能说明哪一批数据用的是哪一版口径,问题会被归到算法上。
四、班次口径与质量抽检的三层
产能口径不能给一个平均数。要分开统计的至少有四项:每人当班的有效采集时长、单条样本时长、无效与重采比例,以及按任务类型分别统计的上述三项。平均数会把两类问题藏起来——某个任务类型反复重采,被其他顺利类型一稀释,看着一切正常;而单条时长变长,往往是起止点口径没传到位,不是人手慢。
班次安排本身也是变量。同一个人连续作业的后段,动作幅度、速度和收尾习惯都会漂移,长班次还会把疲劳带进无效比例里。可行的做法是把批次按人按班次切段记账,每段单独算比例,让漂移至少可见。
抽检分三层,三层各有各的时限和职责。
- 当日自动校验:脚本检查传感器与视频完整性——通道是否齐全、时长是否达标、有无丢帧与截断、起止标记是否落在片段内。这一层只判“数据是否完整可入库”,不判动作好坏。
- 隔日人工对照:质检员按任务卡逐条比对起始状态照片、动作边界与终止判据,同时抽查无效标记打得对不对。人工只按卡判,不凭经验改判,改判要在卡上留痕。
- 周期性双人交叉:同一段数据两人各自标注,算一致性度量。这一层不是挑错,是校准任务卡——一致性掉下去的位置,通常就是任务卡写得含糊的位置。
三层的产出要回流:第三层发现口径含糊,改任务卡并升版本;第二层发现某类无效比例异常,回查是不是道具替换规则没执行。
五、新人上手、流失与数据可用性
流动性高的队伍,培训成本要按“每周都可能有人来”来设计。上岗前不是讲一遍就行,要做对照样本测试:拿一批已判定过口径的标准片段让新人判,判对了才准采;采集的头几十条走加倍抽检。隐性技巧要显式写进任务卡,比如“起始时把袖子摊平再折”这类只可意会的部分,不写出来就只能靠师徒口传,人一走就断。人员流动率要作为风险指标进交付评估,和有效条数、一致性度量放在同一张表上看。
数据可用性的判定里最要紧的是按人分桶。不同操作员之间会存在系统偏差——某个人习惯先整理边角,某个人动作偏慢,这类偏差在训练时会被模型学成“任务特征”。所以要做三件事:把操作员标识写进每条样本的元数据;训练集与验证集按人分桶切分,同一个人的样本不许同时出现在两侧,否则等于让模型在验证时见过同一双手;交付时把每个操作员贡献的条数和其一致性度量一并给出,让客户能看出这批数据的“手”有多杂。
元数据最少要有这几项:操作员标识、任务卡版本、班次标识、道具与环境配置记录、起止时间戳、无效原因码、传感器通道清单与设备标识。缺任何一项,事后想按人分桶都切不出来。
六、交付验收口径与伦理边界
给客户的验收口径要写成可核对的条目,而不是“数据质量良好”。洹拓在合同里只写这几项:每类任务的有效条数与对应口径定义、双人交叉一致性度量值、无效样本比例及其原因分布、可追溯的任务卡版本、原始数据与派生数据的留存约定与期限。其中一致性度量值必须写明是怎么算的、在哪些片段上算的,否则这个数没有可比性。
伦理与安全这一栏不能放在最后当装饰。现场作业风险要评估:演示动作里包含热水、清洁剂、锋利餐具这些要素,工位与防护要有明确安排,按天结算不改变现场责任。结算周期短会带来行为短期化——为了当天条数好看而压缩无效尝试、跳过起始状态照片,这类倾向只能靠当日自动校验和无效比例监控拦住,不能靠提醒。最后是个人信息:采集员的声音、面容、工号、工位背景都可能进入原始数据,可分发数据集必须把这些剔除或脱敏,操作员标识用于内部分桶而不是随数据外发。
人不是可以被要求“标准化”的设备,但数据必须标准化。这两件事之间的缓冲,就是任务卡、对照抽检和按人分桶这三样东西。