
想中途停一条 Promise 链:取消点、清理责任和 catch 的错觉
“优雅中断一条 Promise 链”这句话里,难的从来不是语法,而是责任归属:谁有权叫停、叫停之后谁负责收尾、正在跑的那一步归谁处理。多数实现出问题不是没写取消代码,而是把这三件事当成了同一件事。
先把一条硬边界说清楚。Promise 的执行体一旦启动,外部就无法打断它,链上的 .then 只能决定”结果往下传不传”,不能决定”上一步还在不在跑”。所谓中断,实际上是在做三种不同的动作,把它们混在一个词里说,就会写出”我明明取消了,请求怎么还在跑”的代码。
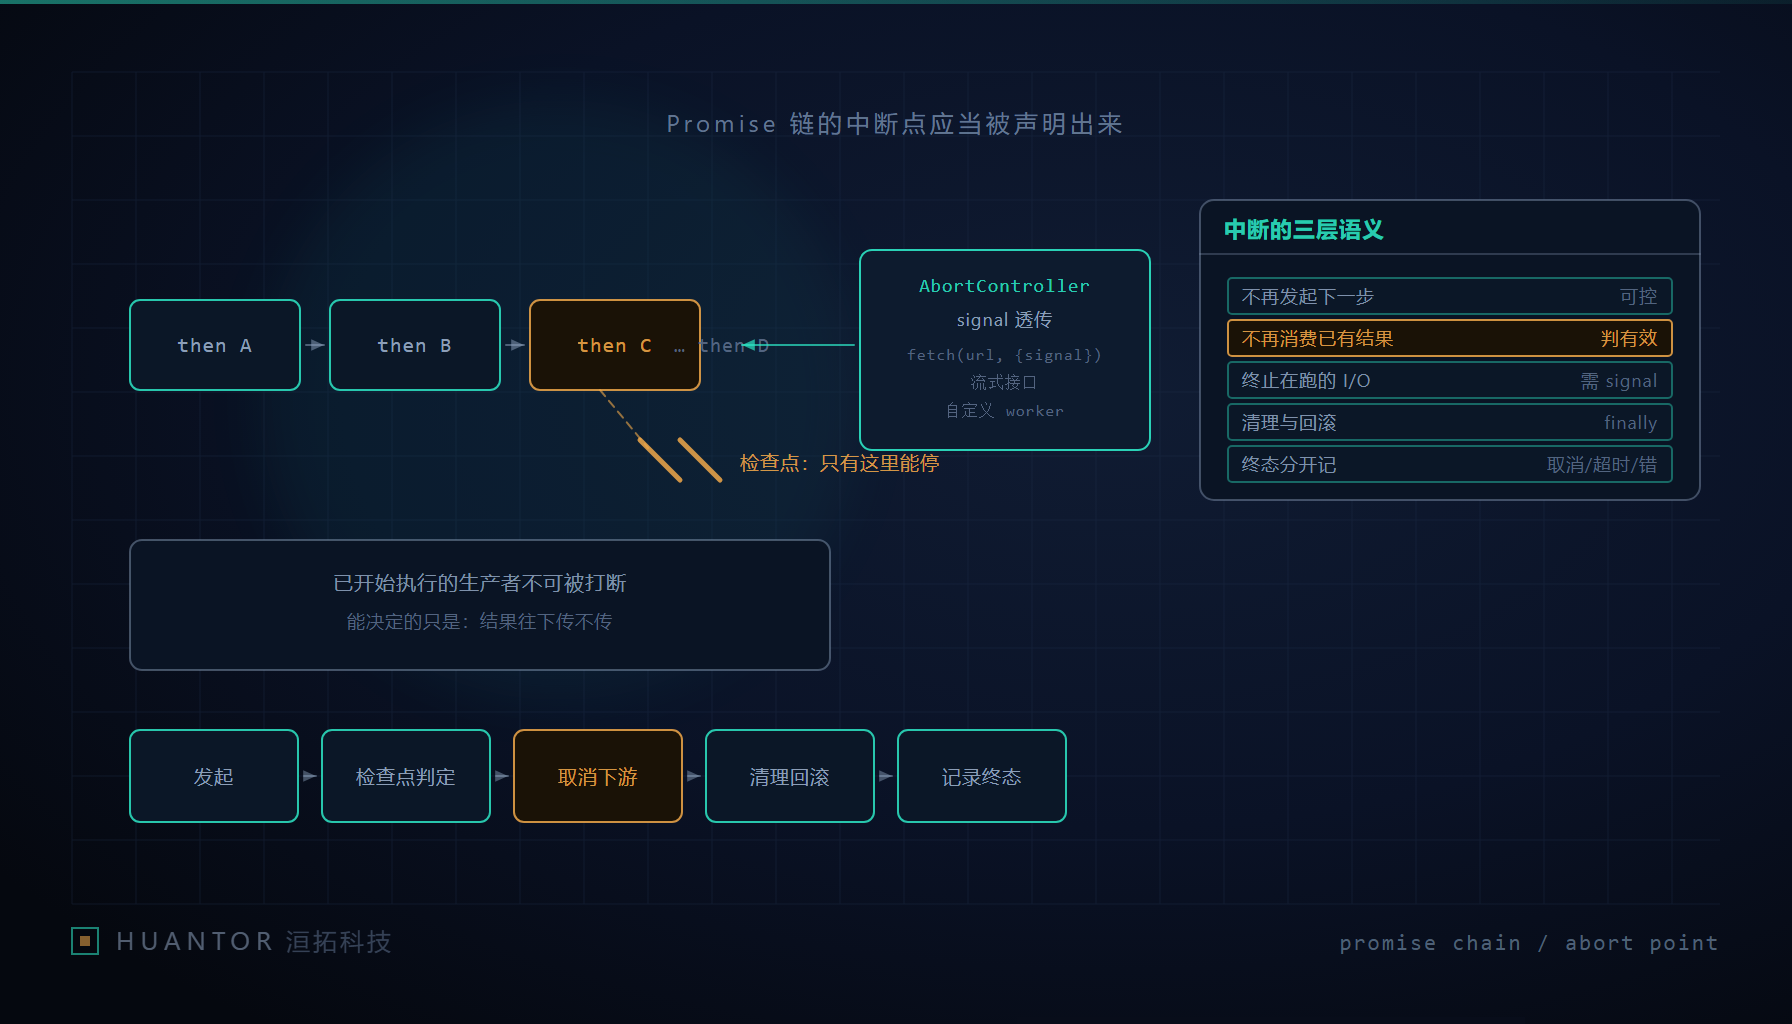
一、中断其实是三层,不是一层
- 不再发起下一步。只要链上不往下走就成立,成本最低,控制完全在调用方手里。
- 不再消费上一步的结果。用
Promise.race或者直接丢弃引用即可做到,但要明白底层任务仍在执行,只是没人等它了。 - 终止已经在跑的 I/O。只有当被调用的 API 本身接受取消信号时才成立——
fetch、各类流式接口、可关闭的订阅。做不到这一层的调用,你只能”放弃等待”。
第 3 层是真正意义上的中断,前两层是止损。区分它们的价值在于:如果你的流程里最耗时的那一步不接受 signal,那么整套取消设计的实际收益只是”界面不再更新”,不是”资源被释放”。这时候要么把那一步换成可取消的形态,要么显式接受它会在后台跑完,并在跑完之后判断结果还要不要。
把这三层写进设计文档,比在代码里散落 if (cancelled) return 有用得多。
二、三种常见误写法各自的失败模式
在 then 里返回一个永不 settle 的 Promise。 return new Promise(() => {}) 常被当作”卡住这条链”的技巧。它的实际后果是:链上的下游永远处于 pending,从这一步往前持有的中间结果、闭包捕获的大对象都被引用链占住,回收不掉;调用方的 loading 状态永久悬挂,既不成功也不失败,因此在错误监控里也看不见;而前一步的回调照样执行完,只是它交出去的那个 Promise 永远不落地,下游谁也不会被叫到。它把”取消”变成了”静默泄漏”,是最糟的一种。
只 catch 不重新抛出。 catch 会把已经抛出的错误吃掉,handler 正常返回后链继续以 fulfilled 状态往前走,调用方拿到的是”成功”。取消被记成成功、失败被记成成功,两种都在污染指标。如果确实要就地处理,必须在 handler 末尾重新抛出,或者把返回值改成一个明确的失败结构,让下游无从误判。
用布尔标记 isCancelled。 它能工作,但它是约定而不是结构:每一个 then 都要手动检查,漏掉一个就继续往下跑;代码评审时无法证明检查点完备;而且”检查标记”与”发起调用”之间存在窗口——检查完为 false,紧接着发起了请求,取消落在两者之间,这个请求还是发出去了。标记位读起来是瞬时值,写它的人和读它的人不在同一时刻,这个竞态只能靠把取消检查交给信号对象、并在发起调用时把信号交出去来消除。
三、把中断做成结构,四条路线对照
| 路线 | 做法 | 能停到哪一层 | 主要失败模式 | 适用 |
|---|---|---|---|---|
| 哨兵值 | 每一步返回结果或一个约定的”已取消”标记,链尾统一判断 | 第 1、2 层 | 判断散落在各步,或者只在链尾判断导致中间步骤照跑 | 步骤少、同步为主的短链 |
| 可中断状态机 | 长流程拆成显式状态与转移,取消是把状态置为终态 | 第 1、2 层,第 3 层取决于每步实现 | 状态与副作用脱节,取消后仍有挂起动作 | 跨多次交互、可恢复的长流程 |
AbortSignal 贯穿 |
一个 signal 从入口传到每个可取消 API | 到第 3 层,前提是被调 API 接受 signal | 只传给最外层,深层调用没接到;或者多处争抢 abort 权 | 有网络 I/O、需要真停的请求流程 |
async 函数加 throw |
让自然抛出成为唯一中断方式,检查点集中在一处 | 三层都能覆盖 | 被中途的 catch 吞掉 |
步骤线性、需要清晰终态 |
四条路线不是互斥的。实践里最省心的组合是:外层用 async 函数把流程写成顺序代码,中层的 signal 由调用方创建并向下透传,长流程的状态机只在确实需要断点续跑时才引入。哨兵值只在无法改成 async 的旧链式代码里当过渡手段。
四、检查点集中:骨架写法与 signal 接线细节
下面的骨架体现一件事:中断检查点集中且显式,取消原因带在信号里,而不是靠散落的分支判断。
// 流程本体:只负责"跑"和"在检查点放弃",不负责决定何时取消 |
接线细节有几处容易漏:
- signal 必须在发起调用那一刻交出去。已经发出的
fetch没法中途补挂信号,只能在发起时传{ signal }。这决定了信号要一路透传到真正做 I/O 的那一层,中间任何一层把参数丢掉,取消就只作用于上层。 - 监听 abort 要带
{ once: true }并在结束时移除。el.addEventListener('message', handler, { signal })这种写法能让监听器随信号自动解绑,比手工移除可靠。生命周期长的信号上挂满了已销毁组件的回调,是内存问题的常见来源。 AbortSignal.timeout()与手工 controller 不等价。超时信号只能自己到点触发、不能中途重置或复用,它的 reason 是TimeoutError;手工 controller 由调用方持有,可以把”用户取消””路由切换””页面隐藏”多种原因汇进同一个信号并带上不同的 reason。想区分终态,就用自定义 reason 而不是只靠aborted布尔值。- **多个来源合成时先定”谁有权 abort”**。规则很简单:信号创建者才有权 abort,下游只读。若任何模块都能拿到 controller 并调用 abort,就会出现在页面上点了无关按钮、把另一条流程停掉的事。合成信号(
AbortSignal.any)不支持的环境,兜底做法是手工转发 abort 事件,并在转发后立即解绑。 - 别假设取消之后就不会有结果。信号与 I/O 之间总有窗口,回调仍然可能带着完整数据回来。消费结果前再判一次
signal.aborted,是把”迟到结果”挡掉的最后一道。
五、清理动作放哪,以及半途取消留下的东西
finally 在成功、失败、取消三条路径上都会执行,所以它适合放”无论如何都要释放”的东西:释放并发额度、清掉全局锁、关闭订阅、把 loading 状态归位。反过来,”只在成功路径成立的清理”不能放 finally,比如把草稿删除、把临时文件转正——这些放取消路径上就是数据损失。同样,把释放资源写成”只在成功时执行”,取消一次就漏一次,这类漏在长流程里表现为并发额度被吃满、后续请求永远排队。
半途取消最难处理的是乐观更新。用户在流程走到第三步时取消,前两步已经把界面改了。回滚逻辑不要写在 catch 里手写一遍,那样它会和前进逻辑分头腐化。做法是每完成一步就把对应的补偿动作压进一个栈,取消或失败时倒序执行,并把”补偿也失败”当成一个必须上报的独立状态——它意味着界面和数据不一致,比原来的取消严重得多。
const undo = []; |
判定”是不是取消”时优先比对抛出的对象与 signal.reason 是否同一个,而不是比字符串。用了自定义 reason 或者中间层把错误包装过一次,靠 name 字段分类就会失手,这时 signal.aborted 是更可靠的兜底证据。
组件卸载和路由切换是这两类问题最常见的现场。请求返回时组件已经不在,setState 类副作用要么报错要么在已销毁实例上静默生效,因此要按”这次结果还有效吗”判定,而不是按”有没有报错”判定。正确接法是在副作用建立时创建 controller、在清理函数里 abort;同时要注意开发框架的双跑与快速重挂行为会让第一次请求立刻被取消,代码必须容忍”取消一次再正常跑一次”这种序列,不能把第一次的取消当成业务失败弹给用户。
六、洹拓视角:三种终态要在指标上分开
用户主动取消、超时、错误这三种终态如果在监控里合成一个”失败率”,取消率就没有意义:它会随网络质量起伏,看不出产品问题,也看不出代码问题。要分开的至少是四项。
- 主动取消率按流程入口统计,同时看它是否与耗时正相关——用户等得越久取消越多,这条曲线本身就是性能指标。
- 超时终态单独计数,并且带上”超时发生在第几步”,能直接指出哪一步最长。
- 真错误率剔除前两类之后再算,这才是可用来做发布判断的数。
- 僵尸任务计数:已经放弃等待但底层仍在跑的调用数量。这一项最能暴露”只做了第 1、2 层中断”的实现,通常加完之后会吓一跳。
再加一条门禁性质的检查:任何新增的长流程代码,评审时只看两处——取消点声明在哪一层,清理责任在 finally 还是成功路径。这两处写在结构里而不是约定里,流程才是可维护的长流程;能中断的流程才敢做长,这是前端工程里少见的、加了之后代码量会变少的东西。