
请求发出去了,回复却是 null:JMS 请求-响应的四个失配点
把一个同步调用改成消息队列上的请求-响应,看起来只是换了传输方式,实际换掉的是”谁负责把两次调用配成一对”这件事。HTTP 的相关性由连接兜住,请求和响应天然在同一条链路上;换成队列之后,请求和回复是两条互不相识的消息,中间没有任何机制保证它们会被认出来是一对。代码从 reply = call(req) 变成 send(req); reply = receive(timeout),一旦 reply 是 null,报错信息什么也没说——它既可能是”没人回”,也可能是”回了但没配上”,还可能是”配上了但你没等到”。
这类故障难定位的地方在于,所有可见线索都在消息头,而消息头恰好是最容易被业务代码绕过、被中间层改写、被字符转换弄坏的部分。报文改错了立刻抛异常,标识改错了只是安静地等到超时。要修它,得先接受一个前提:这些标识各有归属方,不是”你想填什么就填什么”的普通字段。
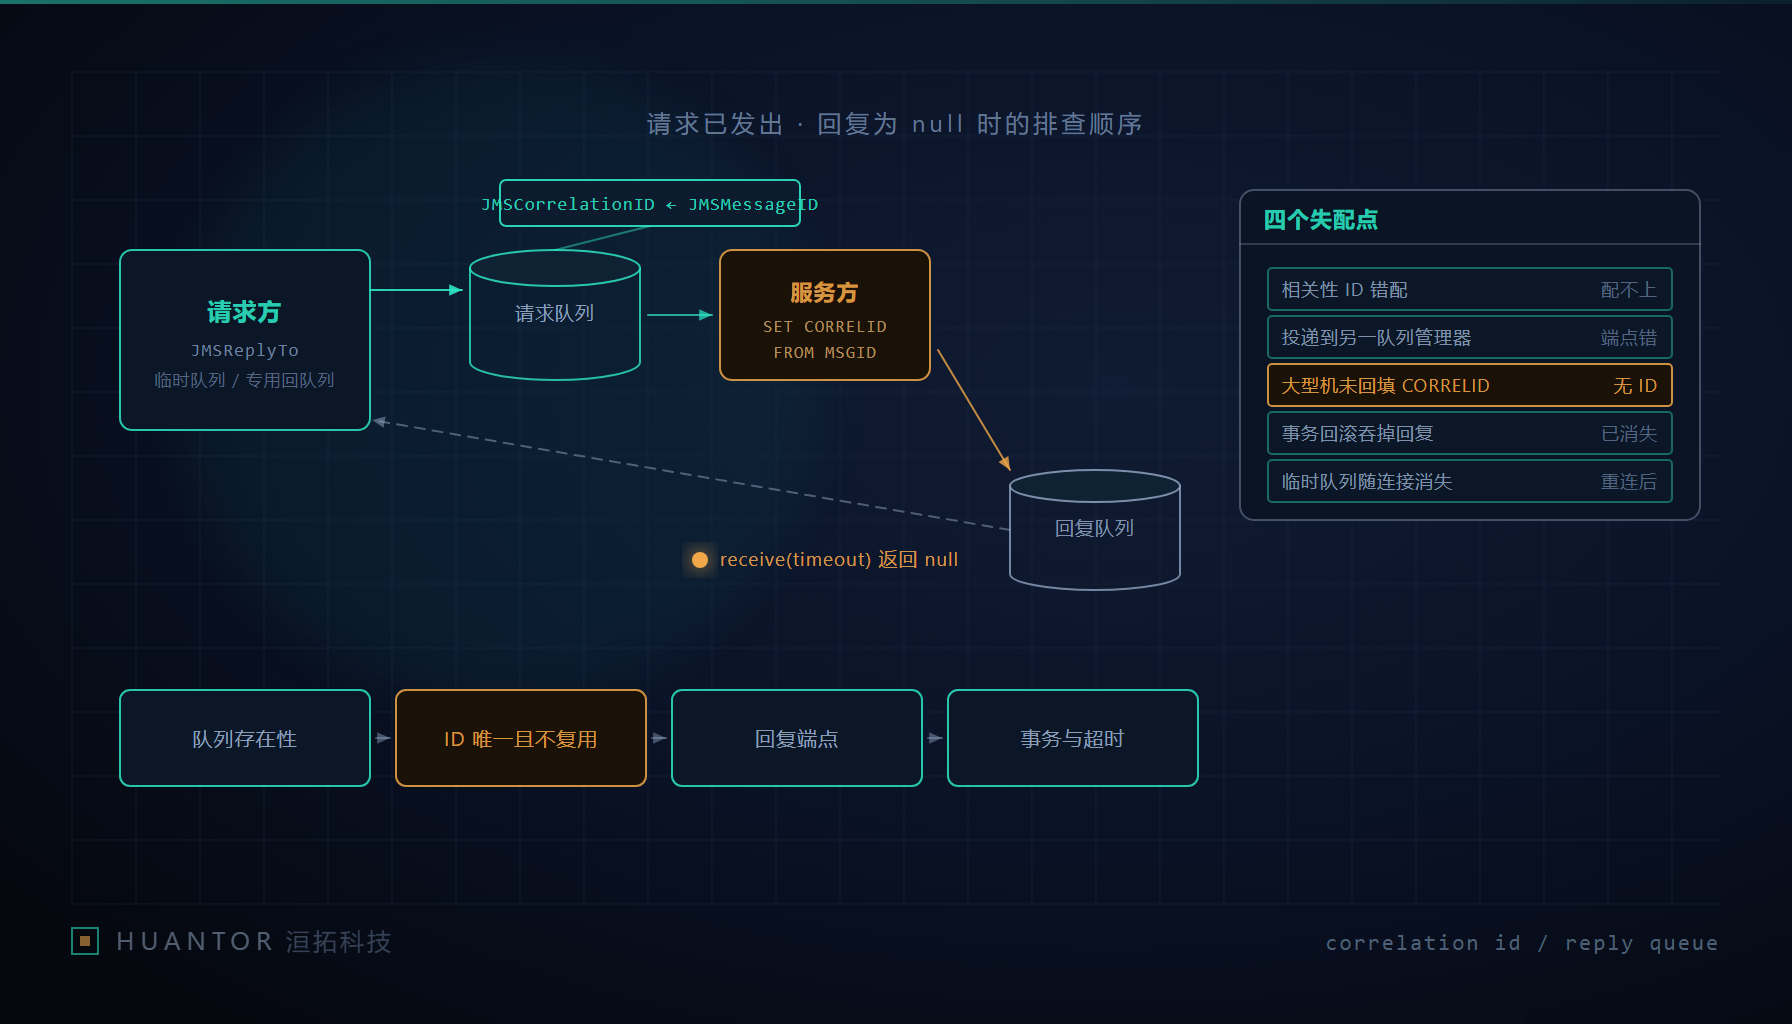
一、翻车点不在消息体,在配对
企业集成里”同步改异步”之所以在这一步出事最多,有三个结构性原因。
第一,投递成功不等于有人取到。send() 正常返回,只代表队列管理器收下了这条消息,不代表回复端能把它放回去,更不代表那个回复队列还存在。写请求的一端与写回复的一端各自拿到一个”成功”,中间的配对责任没人认领。
第二,失败信号分散在两侧。请求方的超时是本地事件,回复方的投递失败是队列管理器上的一个原因码和一条事件记录,两端不在同一本日志里,也没有共同的调用编号(调用编号正是出问题的那个东西)。排查时通常只能靠时间戳人肉对齐,一旦队列积压,时间对齐就失效。
第三,业务字段有校验,标识字段没有。报文缺字段会被 schema 拦下来,而 JMSCorrelationID 填错、填成空、填成业务流水号,从协议角度看全都是合法消息。它坏得无声。
所以第一次读 null 的时候,不要从消息体开始查,直接从标识开始查。
二、一次请求-响应上有五个可失败的接缝
把一次完整的请求-响应摊开,能断的地方是这五处,逐个都要能在配置或代码里指出对应位置。
- 回复队列本身:队列是否存在、是否可写、深度上限与消息大小上限够不够、回复端有没有权限。跨队列管理器时,还要确认两端解析到的是同一个对象,而不是各自本地的同名队列。
- **请求携带的
JMSReplyTo**:放的是目的地对象还是字符串名,名字是别名队列还是模型队列,别名指向远程队列时对端是否能路由回来。 - **请求消息的
JMSMessageID**:这个 ID 由队列管理器在发送时生成,发送之前应用设不进去,send()返回之后才能读到。它是整条链路的”锚”。 - **回复消息的
JMSCorrelationID**:回复端有没有把上一步那个 ID 原样搬过来。中间经过转换、格式化、大小写改动、字符串裁剪,都会搬丢。 - 请求方的等待窗口与筛选条件:选择器写法与引号转义、超时值是否短于对端处理时间、消费线程数是否小于并发请求数导致排队、两端与队列管理器之间的时钟差影响过期判断。
这五处里,前三处属于配置与拓扑,第四处属于两端代码契约,第五处属于容量。null 响应报的是同一个错,根因分布完全不同。
三、null 响应的四种典型成因
| 成因 | 现象特征 | 第一个该看的字段 | 修法 |
|---|---|---|---|
| 相关性错配 | 回复队列在涨,里面有消息,但 receive 超时返回 null |
回复消息的 JMSCorrelationID 原始值,与请求的 JMSMessageID 逐字节比 |
回复端把相关性 ID 明确设为请求的消息 ID,禁止用业务流水号或请求的相关性 ID 复制过来 |
| 回复投递到另一个队列管理器或别名队列 | 请求侧永远等不到,回队列深度是零;在别的队列管理器上能看到同样的报文 | 回复端连接所指向的队列管理器名,与 JMSReplyTo 解析出的对象名 |
统一对象命名与别名定义,跨管理器时补远程队列与传输队列定义,回复端按目的地对象发送而不是拼字符串名 |
| 大型机侧没回填相关性 ID | 回复确实有、内容也对,但相关性 ID 是空、是全空格填充,或者沿用了本任务的旧值 | 回复消息头里的 CorrelId 字段是否为有效值 | 大型机程序在把回复放队列之前显式执行 SET CORRELID FROM MSGID(或按消息上下文 MSGCTX 取值),确认消息描述区的相关性字段已被填上再提交 |
| 消费者在事务里回滚把回复吞掉 | 偶发,与业务异常同现;服务端日志显示处理成功,请求侧超时;队列上找不到那条回复 | 服务端事务边界,即 commit 与 PUT 回复的先后关系 |
把业务落库与投递回复放进同一个同步点;做不到就用本地消息表加补偿投递,确保”业务成功”与”回复发出”同生共死 |
四种成因的排查成本差别很大。前两种靠队列管理器上的对象定义和计数就能确认,第三种要看对端程序,第四种要看事务代码。顺序应该由便宜到贵。
四、两个 ID 的语义差别,以及它们被转换弄坏的地方
JMSMessageID 是提供者给这条消息编号,语义是”这条消息是谁”;JMSCorrelationID 是应用可自由定义的字段,语义由约定决定,在请求-响应里它的含义是”我在回哪条消息”。把前者叫”标识”、把后者也叫”标识”,是混乱的起点。
在 MQ 这一层,两个字段都是定长的字节串,长度为 24 字节,里面包含不可打印字节。JMS 层把它们暴露成字符串时,会按提供者自己的规则加上前缀、做十六进制表示。规范建议的形态是 ID 加上一串文本,但具体编码由提供者决定,不同提供者、不同桥接组件的表示方式并不相同。于是最容易出问题的是字节到字符串的来回转换:
- 用
new String(bytes)把原始 ID 转成字符串再比较,非打印字节在字符集不匹配时会被替换掉,转换不可逆。两次转换出来的字符串”看着一样”,实际永不相等。跨大型机与分布式平台时,EBCDIC 与 ASCII 的差异会让这个坑更隐蔽。 - 用
setJMSCorrelationIDAsBytes()写入原始字节,同时在请求侧用字符串选择器JMSCorrelationID = 'ID ...'等待,两种表示法不保证能被同一个选择器命中;部分提供者在用字符串方式读取一个字节形态的相关性 ID 时直接抛异常。同一对字段在全链路只用一种表示,是更省事的做法。 - 自己在发送前调
setJMSMessageID()塞一个业务编号。发送时提供者会覆写它,你的值不会生效。要让业务编号可查,就写成自己的命名属性,别占用协议字段。
正确的配对写法很短,关键是顺序和归属。
TemporaryQueue replyTo = session.createTemporaryQueue(); |
回复端只有一条规矩:原样搬,不加工。
Message reply = session.createTextMessage(result); |
这里给回复消息设过期时间是有意的:timeToLive 按请求方的等待窗口设、比它略长一点。请求方已经放弃等待时,让队列管理器把这条回复判为过期,进死队列并产生过期事件,比让它在队列里无声烂掉更容易被发现。
五、临时队列的生命周期,和重发带来的第二个回复
createTemporaryQueue() 造出来的队列属于这个连接,连接关闭即消失。在 MQ 上它是由模型队列派生的动态队列,名字由提供者生成,断连时被删除。由此产生两类事故。
一类是重连之后请求方还在等旧队列。连接因为网络抖动或队列管理器重启断开,客户端库自动重连,临时队列被重新创建了一个新名字,而业务代码里持有的还是旧的目的地对象和旧的等待逻辑。此时回复端的 PUT 会因对象不存在而失败,请求端只会看到超时。这类问题必须靠队列管理器上的投递失败事件才能看见,应用日志里两端都是”成功”。
另一类更麻烦:动态队列名可能被复用,上一轮迟到的回复落进了这一轮正在等的队列。请求方读到的是一条结构完整、能解析、内容却是上一次结果的回复。等到业务侧发现数据对不上,往往已经过了好几个环节。对策是读到的每条回复都校验相关性 ID 与本轮锚点是否一致,不一致就明确丢弃并计数告警,而不是当作命中。
请求超时之后重发,会引入第二个问题:可能收到两个回复。重发要么复用同一个相关性锚点,要么用新的消息 ID 加同一个业务幂等键。前者让请求端无法区分第一次和第二次,后者让去重必须落在业务键上。实践里更稳的组合是:每次发送都产生新的消息 ID,业务幂等键单独贯穿,回复端按业务键保证只产生一次副作用,请求端按业务键做结果去重、按相关性 ID 做投递配对。两件事分开放,才不会出现”为了不重复而把配对搞坏”。
如果请求端已经可能产生不可逆副作用(扣减、下发指令),那么”至少一次”的重发语义不能直接用,需要改成请求端先落意向记录、回复端按业务键幂等处理的结构。
六、洹拓视角:把”等不到”和”回得慢”分开
排查顺序建议固定成一张表,团队里谁接手都按同一顺序走,避免一上来就改代码。
| 步骤 | 看什么 | 判据 |
|---|---|---|
| 一 | 回复队列存在性与可写性、深度、消息大小与持久保留设置 | 深度在涨说明回复到了,问题在配对;深度为零说明问题在投递或对端没做 |
| 二 | 请求的消息 ID 与回复的相关性 ID,按原始字节比对 | 一致却没被选择器命中,查表示法与选择器写法;不一致,查回复端 |
| 三 | 回复端点解析到的队列管理器与对象名 | 与请求方等待的位置是否同一个对象,跨管理器时路由是否可达 |
| 四 | 服务端事务边界与超时配置 | 提交与投递回复的先后、超时窗口是否短于对端处理时间、并发消费者数量是否小于在途请求数 |
观测上要补三条打点,缺一条就分不清”等不到”和”回得慢”。请求侧发出后登记在途计数,按业务键与相关性 ID 各一个维度,收到回复或超时才递减;回复队列侧同时看当前深度和最老一条消息的挂起时长,只有深度会把积压误判成正常;队列管理器侧开启事件,把投递失败、消息过期、深度超限三类事件接进告警,因为它们是”回复在路上就死了”的唯一证据。相关性 ID 要作为字段贯穿两端日志,全链路检索靠它,不靠时间戳。
根因几乎都落在”标识的生成权在谁手上”:消息 ID 归队列管理器,回复目标归连接生命周期,相关性 ID 归回复端程序,业务幂等键归业务模型。四个字段四个主人,改动任何一个之前先确认自己是不是它的主人。想清这一点,null 就不再是一个无法解释的返回值了。