
给一颗行星画地图,先要统一的是口径不是画笔
一、消息本身不是重点,重点是这类工程先做什么
据公开报道,“编制新一代全火星地质图”的消息引起关注,报道把它与“这颗星球上水存在过多久”一类问题连在一起。那些科学问题不在本篇讨论范围,任何科学结论也不由一篇工程随笔推断。值得拆的是另一件事:一张覆盖整颗行星、要把不同来源不同年代不同精度的观测拼到一起的图,它的难点从来不在绘图工具,而在开工前必须定下的口径。这类工程和企业里“把全集团数据做成一张地图”的项目,是同一道题。
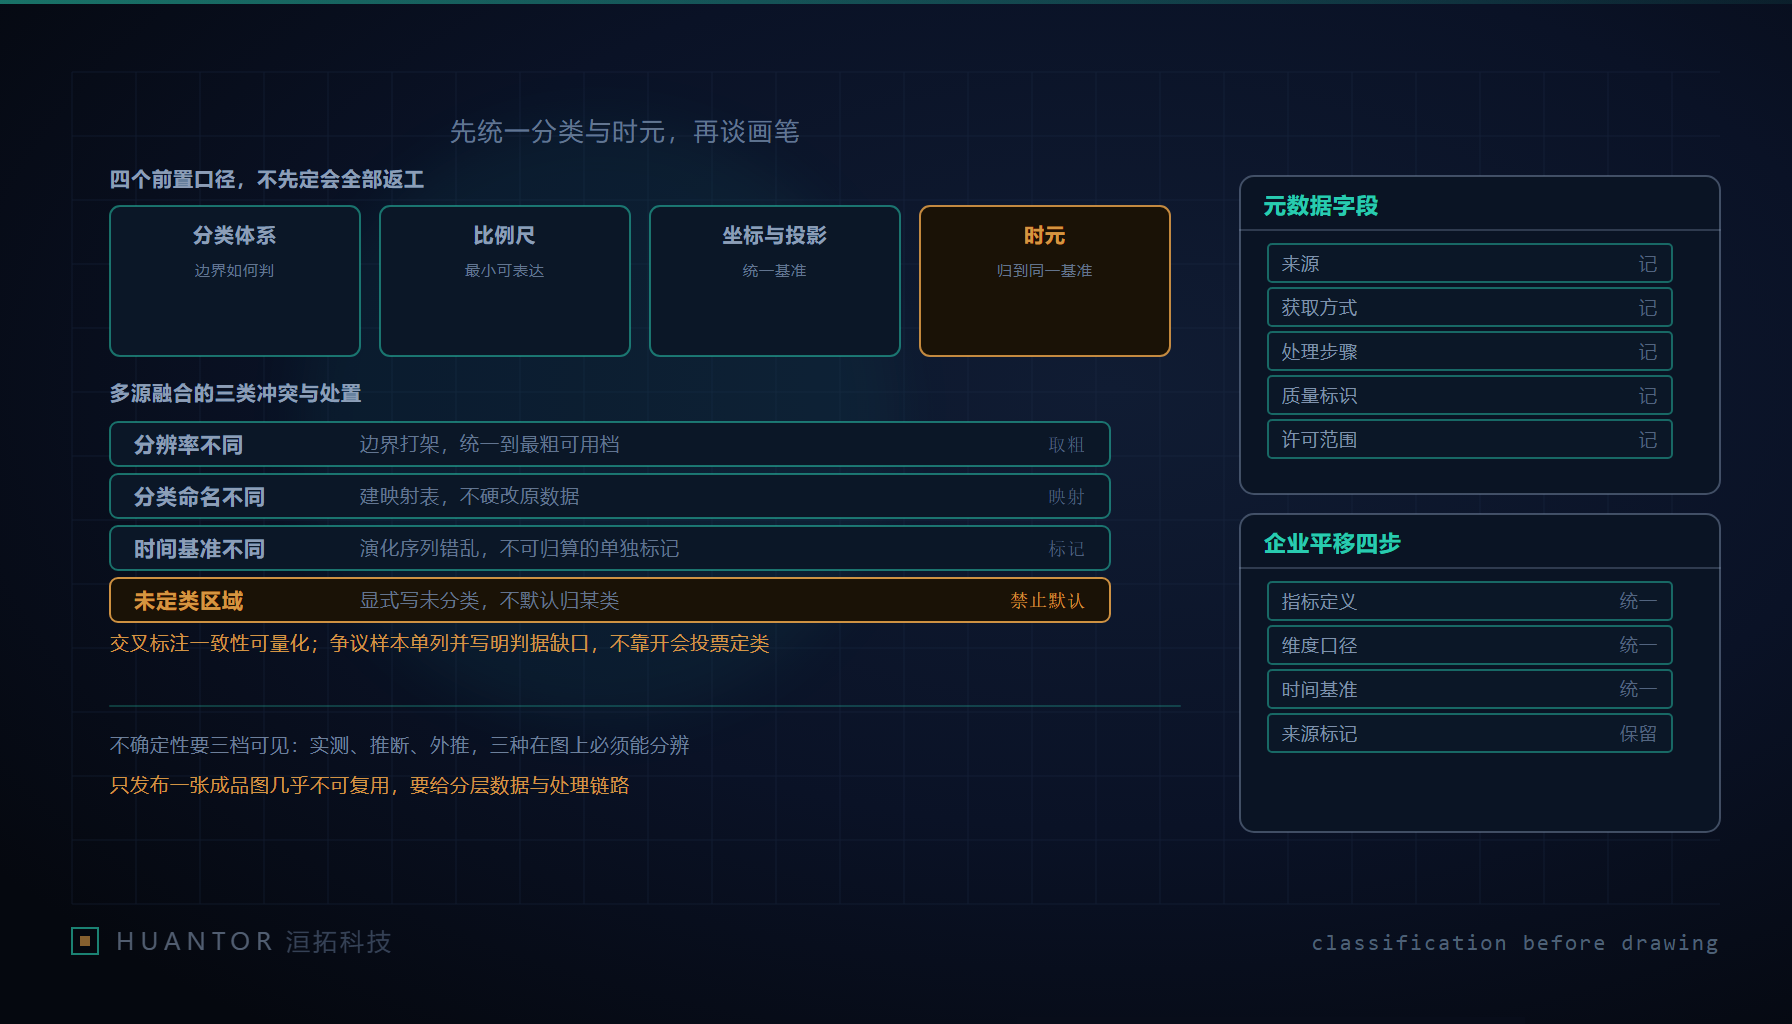
四个前置口径,顺序不能颠倒。
| 前置口径 | 要定什么 | 不先定的后果 | 企业侧对应物 |
|---|---|---|---|
| 分类体系 | 有哪些类别、每个类别的判据、类别之间的边界规则 | 拼到中途发现同一单元能归进两类,只能回头重标 | 指标口径表、维度枚举值与层级定义 |
| 比例尺与最小可表达单元 | 多小的结构不再单独表达、合并到什么类别 | 两条来源不同的边界在图上互相穿插,无法成图 | 数据颗粒度约定、最小统计单元 |
| 坐标与投影基准 | 参考基准、投影方式、量测单位 | 同一物体在不同图幅上位置不重合,接边失败 | 主数据编码规则与实体对齐标识 |
| 时元 | 所有数据归算到的同一时间基准 | 演化序列错乱,先后关系无法解释 | 统计基准时点与快照口径 |
四样里最容易被跳过的是时元。企业在做指标体系时,习惯把不同系统在不同时间点导出的数直接放到一张表里比较,这个动作在制图工程里等同于把两张不同年份的底图直接叠起来画边界——每一处不一致都没法判断是真实变化还是基准错位。
二、多源数据的三类冲突与各自处置
拼合阶段的冲突只有三类,每类的处置方式不同,混用处置会让问题变复杂。
分辨率不同导致的边界打架。两条来源的边界在同一段互相穿插,谁都不服谁。处置只能是统一到最粗可用分辨率再判:在细分辨率下看到的曲折,一旦归算到成图比例尺本来就该被平滑掉;反过来,为了迁就细数据把整张图放大到最细分辨率,会把低质量来源的细节当成事实固化下来。这一步的关键不是选哪个分辨率,而是把“降分辨率时边界如何归并”写成规则,让人工和程序得到同一个结果。
分类命名不同导致的无法合并。一边叫某类沉积,另一边叫某类沉积成因不明。处置是建立映射表,而不是硬改原始数据的类别名。映射表要写明每条映射是一对一、一对多还是多对一,一对多的必须补充判别条件,多对一的必须保留原类别可回查。硬改的问题在于不可逆,改完之后再没人能追溯到原始判读依据。
时间基准不同导致的演化序列错乱。处置是先明确成图采用的时元,把所有数据归算过去;确实无法归算的部分单独标记为“未归算”,允许它在图上出现,但不进入演化序列的解释链条。把无法归算的数据默默塞进序列,是这类工程最隐蔽的错误,因为它不会在图上看出异常,只会在下一版被推翻。
三、分类体系的三个难点,按代价排序
互斥性是同一定义层面的问题:一个单元不能既属于甲类又属于乙类。做不到互斥,通常是分类混用了两个维度,比如按成因分和按形态分同时放进一套列表。解法是拆成正交的两个字段各自取值,而不是在一张表里加“既甲又乙”这种类别。
覆盖率是承诺层面的问题:未定类的区域必须显式标成“未分类”,不能默认塞进某个类别或留成空白。留白的坏处是下游读者无法区分“这里没有”和“这里没查”。企业指标看板上同一格子空着,含义至少有四种,这是同一个毛病。
可判定性最难,因为它要求给定同一份原始数据,两个互不沟通的人判出同一个类别。判据写成“具备某些特征”这类句子时,可判定性必然失败——分歧来自每个人对“某些”的程度理解。可行的写法是把判据落到可测量项和阈值上:可测的直接写阈值,不可测的写对照样例与优先规则,两者都写不出的类别说明它现在还不该成为一个类别。
四、可判定性怎么验:用一致性度量,不用投票
分类体系上线前必须做一次交叉标注。做法是随机抽一批单元,两人或三人独立判类,统计一致性,把分歧样本单独列成一张表。这张表要回答的不是“谁判错了”,而是“判据在哪一句上给了两个人不同的解释空间”。每个分歧样本后面挂一条判据缺口,缺口补齐了才允许进入下一轮标注。
开会投票定类是这类工程里最常见也最省事的错法。投票产生的是共识而不是可复现的判据,一年后换一批人,同一份数据还会重新吵一遍——因为没人能从投票结果里推出当初的理由。一致性度量本身要选对:类别分布悬殊时,看着很高的原始一致率可能只是大家默认判了多数类,需要同时看排除偶然一致后的度量,并按类别分别看而不是只看一个总数字。总一致率会被占多数的稳定类别摊平,掩盖少数类别的系统性分歧。
对争议样本还有第三种处置:允许它长期停留在“待定”,并在图上以独立符号出现。待定不是失败,把待定强行归类才是失败。
五、不确定性、版本与依据链
边界不是线,是带。每条边界要标置信度,并把依据来源分成三档:实测(直接观测得到)、推断(由相邻关系或间接量导出)、外推(由规律延伸,覆盖未观测区域)。三档在图上必须用不同的可见方式区分,比如线型、透明度或符号密度,让读者一眼看出哪里是硬的、哪里是软的。混在一起显示,等于把外推伪装成观测。
版本管理的原则是图件与其依据数据分开打版本。依据数据可能因新来源更新,判据可能因认识改变更新,两者的更新节奏和审批人不同。每次改版要写清改动属于哪一类:数据更新(新增来源、来源质量提升)、判据更新(分类定义或阈值调整)、表达更新(符号与配色)。这三类混写成一版“修订内容”,下游就无法判断历史结论是否还能沿用。回退路径要保留,任何一版能重建出当时的图。
元数据字段是决定成果能不能被别人复用的东西。一份可复用的图件至少要有:来源、获取方式、处理步骤、处理参数、质量标识、许可与使用范围。缺处理参数的成果,别人只能看不能算;缺许可的成果,别人看都不敢用。只发布一张成品图(比如一份不可编辑的版式文件)几乎是复用性最低的做法——它把结论给了出来,把得到结论的过程全部藏掉了,下游唯一能做的事就是重新做一遍。
开放共享因此分三档:只给结论图,价值是传播;给分层数据与元数据,价值是复核与二次制图;给处理链路与参数,价值是方法可迁移。三档对下游的意义差距很大,而成本差距主要在整理纪律上,不在计算量上。
六、平移回企业数据地图,就四步
把上面这套方法搬到集团指标与主数据治理,路径是固定的四步,我们内部一直按这个顺序推,洹拓给客户做数据地图时也拒绝跳过前两步。
第一步,先出口径对照表再出看板。每一行是一个指标或维度,写定义、公式、包含排除、单位与修约、判定方、来源系统、基准时点。这张表没签字之前,任何看板都只是在把分歧固化。
第二步,定颗粒度与最小可表达单元。数据地图不是越细越好,要定“多细以下不再单独维护、按什么规则归并”,否则合并逻辑散落在每张报表里。
第三步,定时间基准。每个指标写明统计基准时点与快照口径,跨系统比较时统一到同一时元,做不到就标记“未归算”,不许默默对比。
第四步,给每条记录打来源标记。区分实测(系统直接采集)、推断(由规则或模型导出)、外推(由假设延伸),在看板层用可见方式区分。管理层看到的每个数,都该能回答“这个是量出来的还是算出来的还是估出来的”。
这四步做完,图能不能画得漂亮反而是最不重要的那一步。