
按标签搜索看着简单:多对多检索的语义与索引账
一、一个搜索栏为什么不好写
php.cn 上有一条在 Django 里做标签搜索栏的实现问答,思路是把标题与标签放在一起过滤。功能上没错,但真放到内容量大的站点上,会同时遇到四类要求,它们互相拉扯:标题模糊匹配(多值列上的模式匹配)、标签过滤(多对多关联,且语义有分歧)、相关度排序(不是单列可比较的值)、分页(需要总数与稳定顺序)。
这四件事各自都不难,难在组合后的执行计划:一次过滤会在中间表上产生多个连接行,连接行让排序重复计数,重复行让分页的总数与列表对不上,而模式匹配让已经建好的索引全部失效。Django 的 ORM 把这层都写成链式调用,看起来”就一行 filter”,所以账要自己算。下面按语义、代价、索引、分页四层展开,最后讲标签体系本身——那层不做,前面所有优化都会被脏标签抵消。
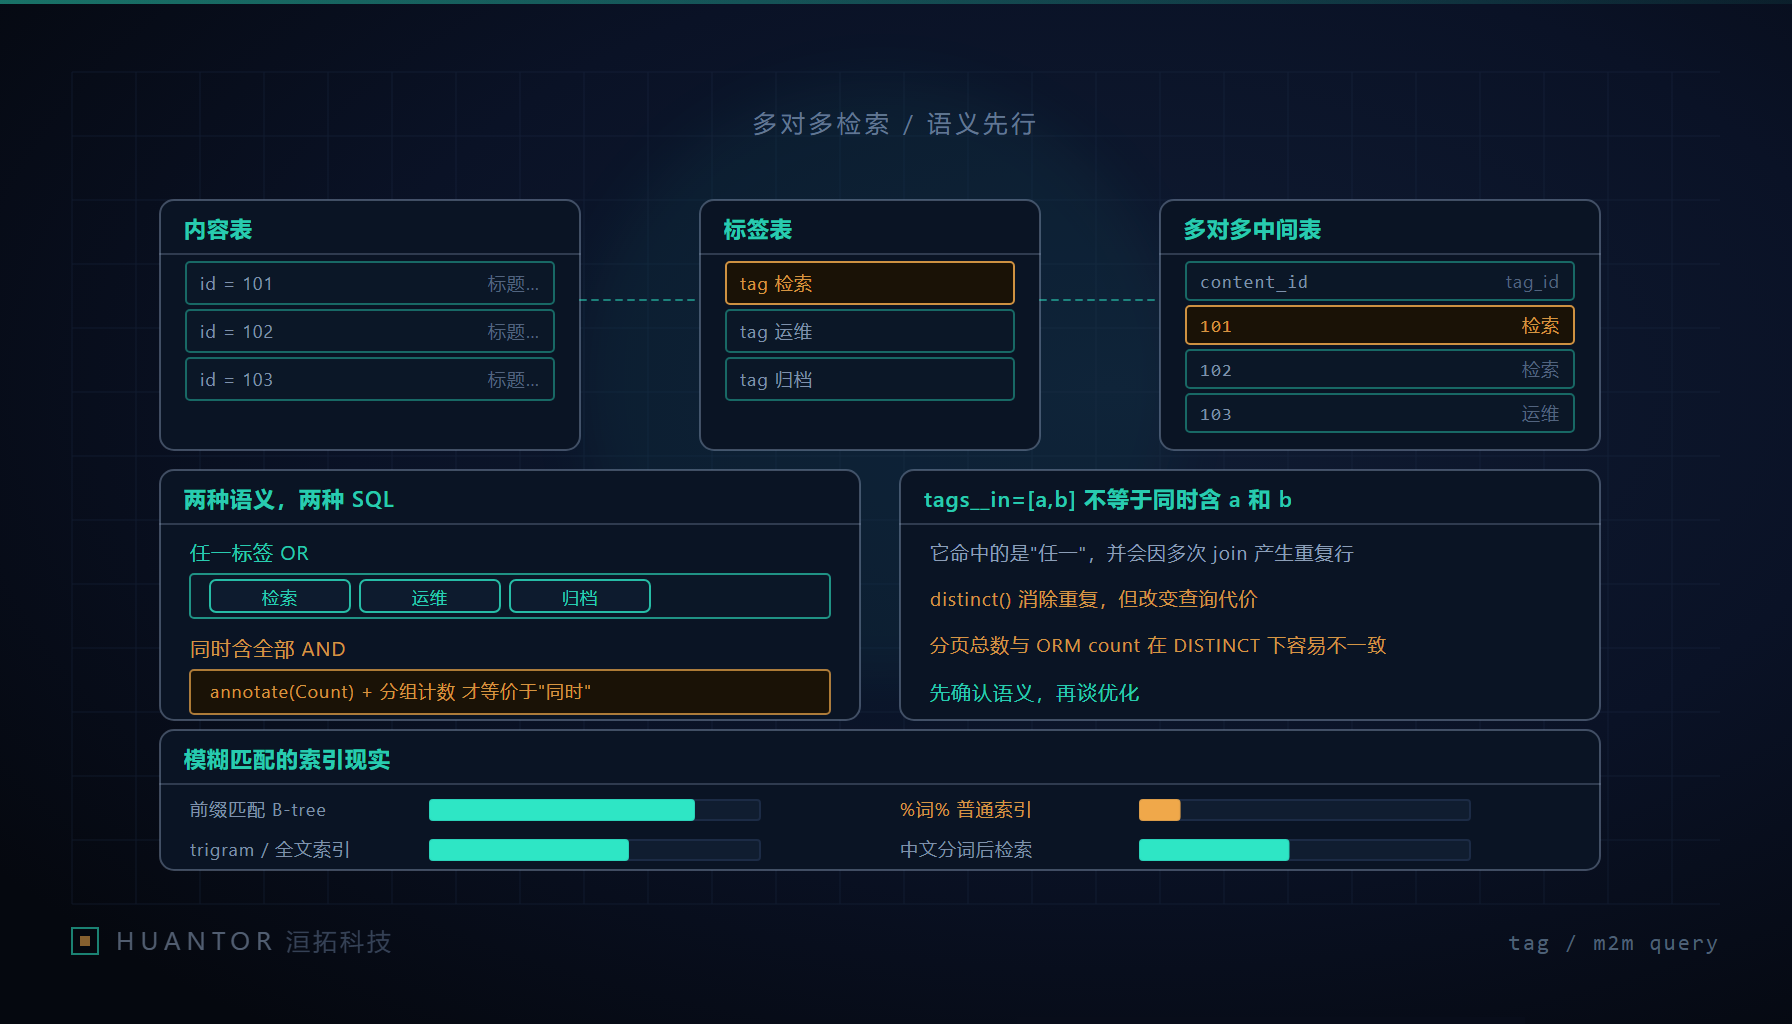
二、标签匹配的两种语义:tags__in 不等于”同时含 a 和 b”
这是最容易写错的一处。设 Post.tags 是多对多字段,a、b 是两个标签对象:
| 写法 | 生成的连接 | 实际语义 | 会不会出重复行 |
|---|---|---|---|
filter(tags__in=[a, b]) |
一次连接,条件是中间表的标签标识落在集合内 | 含 a 或含 b 任一即可(OR) | 不会;一篇对同一标签只有一行中间记录 |
filter(tags=a).filter(tags=b) |
两次链式调用产生两个表别名连接 | 同时含 a 与 b(AND) | 不会,但连接数随标签个数线性增加 |
filter(tags__in=[a, b]).annotate(n=Count("tags")).filter(n=2) |
一次连接后分组计数 | 同时含两者(AND) | 分组后不重复 |
filter(tags__in=[a, b], authors__in=[u]) |
标签连接加另一个多值关联的连接 | 标签是 OR,两类条件之间是 AND | 会,两个多值关联的行数相乘 |
第三种写法值得多说一句,因为它是常见的坑:annotate 里聚合的是经过 WHERE 过滤之后的连接行,所以上面那段数出来的是”命中的标签个数”,正好是我们要的 AND 判据。但如果你想同时要”这篇文章一共有几个标签”,同一条查询给不了——计数被过滤条件限制了,得改用相关子查询(Subquery 里套 Count)或干脆在写入时把标签数存成冗余列。这两种语义(”命中数”与”总数”)在 SQL 层面是两件事,链式调用看不出来,务必用 queryset.query 把生成的 SQL 打出来核对一次;聚合与过滤的先后关系以所用数据库为准。
AND 语义还有第四条路:对每个必须命中的标签套一个 Exists 子查询,连接数不随标签个数增加,也不依赖分组计数。代价是每个标签一次子查询执行,短列表下比链式 filter 更好读,长列表下的表现要看数据库对半连接(semi-join)的处理,不能凭直觉判定谁快。写法示意如下,具体 API 支持范围以所用 Django 版本为准:
from django.db.models import Exists, OuterRef, Count |
两处顺序不能反。其一,annotate 与 filter 的先后决定聚合范围:把 tags__in 写在 annotate 之后,条件会另起一次连接,数出来的就不再是”命中的标签数”。其二,tag_ids 里有重复元素时,len(ids) 与逐项半连接给出的判据不一致,这类”参数没去重”的缺陷在界面上看不出来,只能靠单元测试锁。Count("tags", distinct=True) 只在还有其他多值关联可能乘行的场合才是必需的,本身会额外压一层去重成本。新版写法允许把 Exists 直接放进 filter(__exists 查找),能少一次注解,可用范围以所用 Django 版本为准。
三、重复行与 distinct() 的代价
多值关联一旦叠加就会产生重复行,最典型的是同时按标签与评论者过滤,或者模板里对同一篇文章渲染两次关系字段。加 distinct() 能把结果修对,但它是把去重压在数据库里做:查询要先算出完整的连接结果集,再按选取列的整行比较去重。选取列越宽(正文、富文本、JSON 字段全在 SELECT 里),去重越贵;数据量大时会走临时表或排序,EXPLAIN 里能看到明显成本。
两个具体后果值得提前知道。其一是排序列与 SELECT DISTINCT 的冲突——把去重加在宽行上再按一个没被选取的表达式排序时,部分数据库会直接报错(”排序表达式必须出现在选取列表里”这类提示),不是慢而是失败,需要把排序列显式放进选取列。其二是总数查询:.count() 在带 distinct() 的查询集上通常要把整条查询包成子查询再数行数,等于把去重做两遍,列表页每次翻页都在重算一次总数。这也解释了最常见的一类缺陷——列表实际渲染的条数与分页组件显示总数不一致,多半是列表路径与计数路径有一边漏了 distinct(),或有一边用了带重复行的连接。
替代方案按代价从低到高排:优先用连接语义本身避免重复(固定单个标签的 filter(tags=a) 不会乘行),其次用半连接(Exists)而不是去重,再其次用 prefetch_related("tags") 把标签作为第二次查询取回(IN 查询不做连接,也就不产生重复行),最后才是 distinct()。要注意 prefetch_related 只解决”读取关联对象时的 N+1”,不解决”按关联字段过滤”——过滤仍要走连接,两者不能互相替代。列表页最常见的写法是:过滤与排序在一条查询里做,标签展示交给 prefetch_related,只 values 出真正需要的列,把去重的行宽压到最小。
四、模糊匹配的索引现实:普通索引帮不上 %关键词%
标题检索常用 icontains,它落到 SQL 是两侧带百分号的模式匹配。这类条件用不了普通 B-tree 索引——索引按前缀有序,中间出现任意片段时顺序性就没有意义了。前缀匹配(startswith)在某些数据库上能用 B-tree,但也常需要专门的操作符族或表达式索引,大小写不敏感的前缀匹配还得把折叠规则固化进索引;这些差异很具体,务必在自己的数据库上实测,不要照搬别处的结论。
能真正让 %关键词% 变快的是另外两类索引。一类是三元组(trigram)索引:把字符串切成三字符片段建倒排,模式匹配变成”片段交集预筛再逐行验证”,对拼写变体和部分匹配也友好,常见做法是给扩展插件加索引而不是换引擎。另一类是全文索引:按词切分建倒排,配合词权重与相关度函数排序;但它按”词”检索,不是子串,行为与用户习惯的”包含就算”不同,得在结果解释里对齐预期。
中文把这件事推得更远:多数全文实现按空白与标点切词,一整段中文会被当成少数几个超长词项,索引看起来建了,命中率却接近零。出路是三条——给数据库挂中文分词能力(需要扩展与词典维护,还要处理新词),在应用层预分词后把一个供检索的字符串字段写回数据库(写入侧多一步,但检索侧最省),或者干脆把模糊匹配交给外部检索引擎。选哪条不在”哪个更快”,在于你能否承担词典与写入链路这两项长期维护。
五、排序与分页:把三件事分开算
排序字段与索引要成对设计。最常见的查询形态是”某个状态加标签过滤,按时间倒序取前若干条”,能同时服务它的索引是”过滤列在前、排序列在后”的组合索引;顺序反了,数据库就得先取出全部匹配行再排序。相关度排序是另一回事:全文索引的相关度分数只能由数据库按它的规则算(权重、距离、词频),而”热度”这类要跨表统计(浏览量、评论数、时间衰减)的分数,放进 ORDER BY 就意味着先聚合再排序,代价随数据量增长很快。判断口径按量决定:候选集能被索引压到几百行以内时,分数在数据库里算;候选集本身就是几万行时,把打分挪到应用层的有限候选上,或者预先物化一个热度列再建索引。物化列的更新频率本身就是个决策点,别默认实时。
分页的三件套:
- 总数查询:每次翻页都数一遍全表是浪费。可选做法是只在前两页显示总数、后续页只给”有无下一页”;或者把总数按过滤条件缓存一小段时间,明确接受它不是精确值。总数要不要精确,是产品决策,不该由数据库替你做。
- 偏移分页与游标分页:
OFFSET n的代价随 n 线性增长,因为被丢弃的行仍然要被读出来;游标(键集)分页用上一页最后一行的排序键继续走,深层翻页代价恒定。代价是游标需要稳定且唯一的排序键(时间列要带上主键做决胜位),且不支持”跳到第 80 页”这种交互。 - 深翻页防护:给最大页码设上限,超出就要求用户收窄条件(加标签、加时间范围);否则一个爬虫能拿”第 9000 页”把你的数据库拖住。开放接口里更稳的做法是只暴露游标与每页大小。
六、洹拓视角:标签治理不先做,检索层的账全都白算
我们见过多次同一种顺序错误:先花力气把某条查询的耗时压下去,再发现用户搜”机器学习”只出来一半结果,因为库里有”机器学习””机器 学习””ML””机器學習”四种标签并存。检索层无法修复标签层的数据。上线前按这张表把标签体系定下来,比事后清洗便宜:
| 治理项 | 具体做法 | 不做的后果 |
|---|---|---|
| 写入规范化 | 入库前统一大小写、全半角、空格与连接符,拒绝空标签 | 同义标签成堆,过滤命中率天然低 |
| 同义与变体 | 维护”别名指向规范标签”的映射,检索时把查询词展开成一组标签标识 | OR 查询漏结果,用户以为功能坏了 |
| 每篇标签数上限 | 设上限并要求标签有实际区分度 | 长尾标签无检索价值,中间表膨胀 |
| 自动打标的人工纠错入口 | 机器打的标签带来源标记,允许一键改并记录 | 自动标签订正不掉,噪声持续累积 |
| 使用计数与清理 | 记录每个标签的命中次数,低频标签定期合并 | 标签列表越来越长,界面与查询都变慢 |
| 中间表索引 | 按”先标签后文章”与”先文章后标签”两种访问方向分别评估索引 | AND 查询与详情页取标签互相抢索引 |
性能定位的顺序也固定下来,越往后成本越高、收益越不确定:
- 把生成的 SQL 打出来(
queryset.query)看连接数与返回行数,先确认标签语义有没有写反——OR 写成 AND 或反之,属于缺陷而不是性能问题。 - 用
EXPLAIN看是否命中索引,有没有出现顺序扫描加大排序;顺带核对组合索引里过滤列与排序列的先后。 - 单独比对计数查询与列表查询,确认两者走的是同一条过滤路径,总数才可能一致。
- 确认语义与索引都无误后,才考虑把标签数或热度物化成列、给短查询加缓存。
- 最后一步才是引入外部检索引擎,并且要接受它带来的双写与一致性延迟。
判断”该不该上专用检索”用三条阈值自己量化:模糊匹配是否已经需要分词、同义词与拼写纠错;是否需要多字段权重与结果高亮;过滤加聚合的候选集是否已经大到无法用组合索引压住。三条里中一条,加索引还能撑;三条全中,继续在 ORM 里优化就是错的工具。这类判断我们只按自己数据量下结论,换一批数据就要重算一遍。