
算力够不够用,已经不是“再买一批卡”能回答的问题
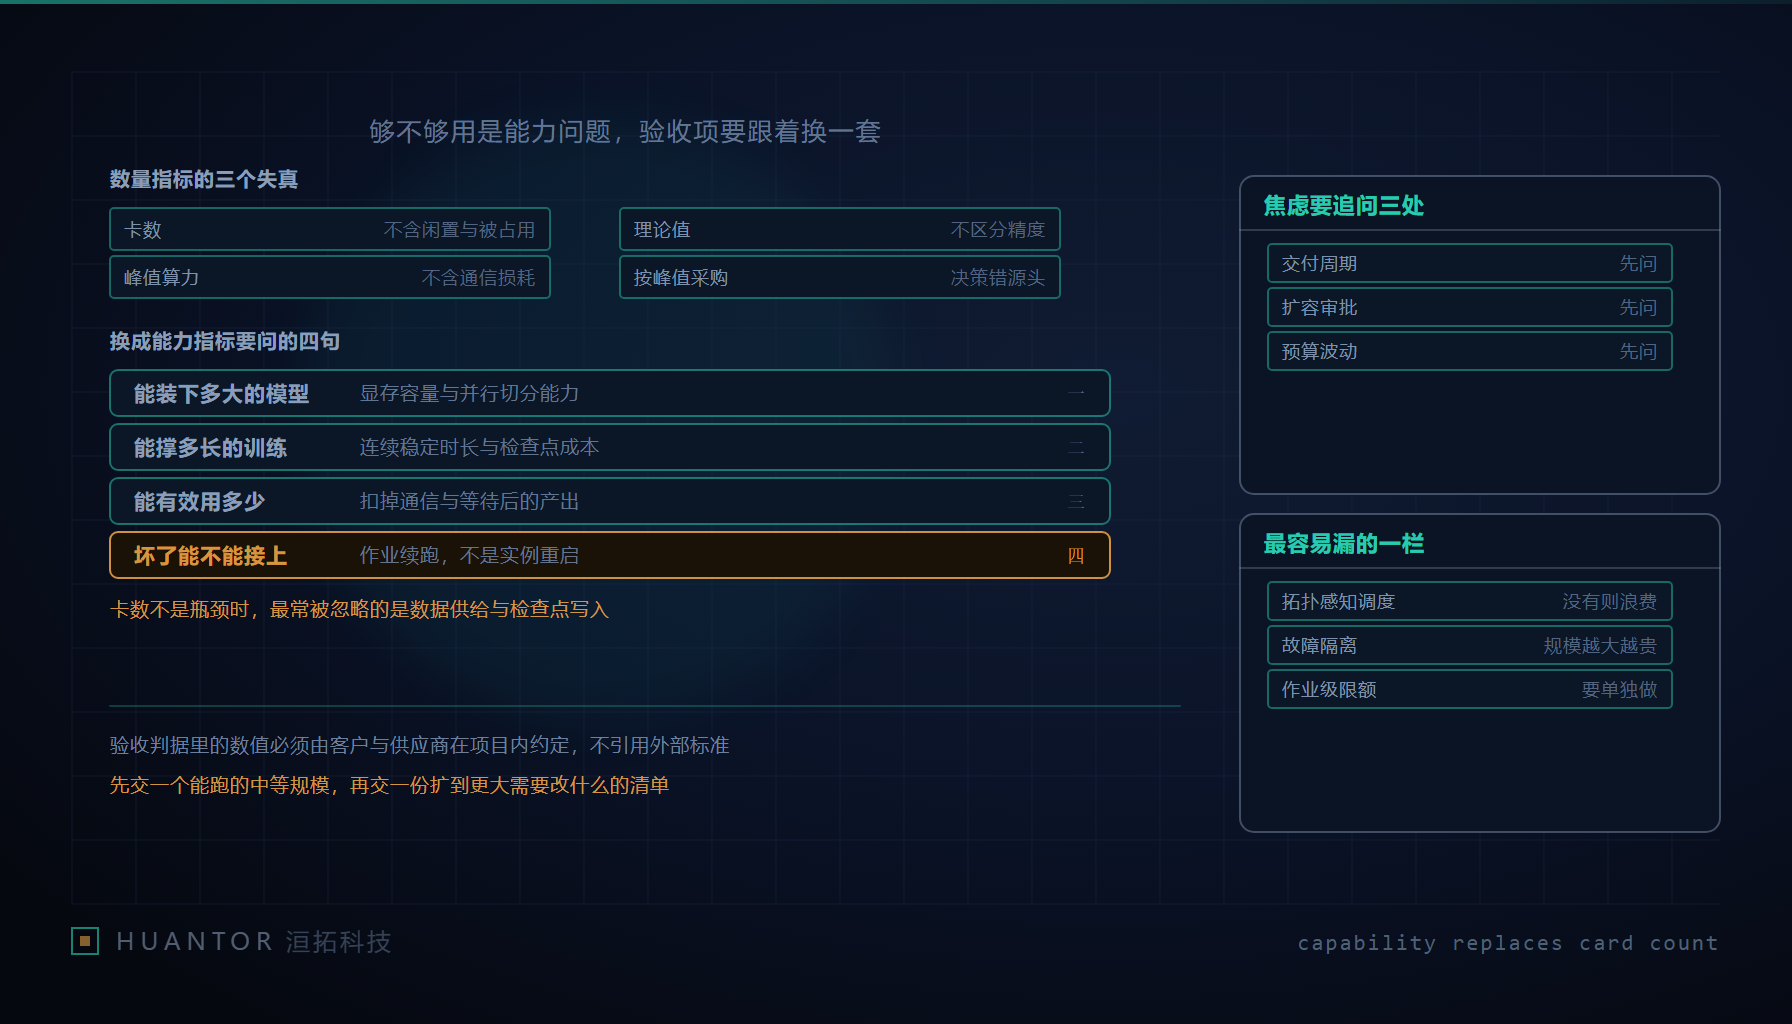
一、话题从数量挪到能力,挪完之后要换的是验收项
据公开报道,某服务器厂商在公开采访与发布中谈到智算基础设施,意思是 AI 算力竞争多年来就是堆卡、堆机柜、堆发电机,而“算力够不够用”已经不能单靠堆卡解决,它分化出多个层面,第一个层面关于智能上限,即算力能支撑的模型规模;该厂商同时称其方案有助于缓解“产能焦虑”。本篇不引用它的任何性能说法作为事实,也不评价它的产品,只采纳其中那句结构性的判断:够不够用不再是一个数量问题。我们同样把“产能焦虑”这四个字当作厂商口径看待,它指什么还需要追问。
这句话对客户交付的直接含义是:验收项要跟着换。如果目标从“有多少卡”变成“能跑多大的模型、能撑多长的训练、能恢复多频繁的故障”,那么验收单上的条目、判据和实测记录就得整表重写。多数项目还在用前一套指标验收后一套目标,这是很多“建得起、用不起”的起点。
二、数量指标的三个失真
失真一,卡数不含被闲置与被占用的。台账上登记的卡数里,可能有一部分长期被某个实验占着却不出结果,也可能有一部分因为拓扑、驱动或配额问题调度不上去。卡数是一个资产数,不是一个供给数。
失真二,峰值算力不含通信与数据加载损耗。矩阵乘的理论吞吐和一次真实训练步之间,隔着梯度同步、样本供给、检查点写入三段等待。用峰值去做容量规划,等于把三段等待当成零。
失真三,标称吞吐是理论值且不区分精度。按每秒浮点运算次数给出的那个数字,在不同数据精度下的含义完全不同,把它当成单一可比口径去比两家方案,比的是宣传页而不是能力。
三个失真有一个共同来源:数量指标描述的是投入侧,不描述产出侧。要判断够不够,必须换到产出侧去看。
三、换成能力问题之后,是四问
第一问:能装下多大的模型。这一问取决于显存容量与并行切分能力,而不取决于卡数——单卡显存决定一个模型分片的上限,并行切分能力决定这个上限能不能被推到更大规模。要跑更长的上下文,同一问还要再拆一次,因为序列长度对显存的压力与参数规模不同源。
第二问:能撑多长的训练。这里要的是连续稳定运行时长与检查点成本两件事。一个集群能跑通一次短任务不代表能跑通长任务;而检查点写得越频繁越安全,写入耗时占总耗时的比例就越高,这个比例本身就是能力的一部分。
第三问:能有效用多少。定义要写死:去掉通信等待、数据加载等待与空闲之后,单位算力时间里的有效产出。分母用作业占用时长而不是日历时长,否则排队时间会被算成产出。
第四问:坏了能不能接上。判据是作业续跑能力,而不是实例重启能力。实例重启只说明虚拟化层活着;作业续跑要求检查点、并行拓扑与数据游标三者都能恢复到同一点,缺一不可。
这四问的共同点是都能被回答成一句可判定的话,而“我们规模很大”永远不能。
四、智能上限这一层,真正卡住的是三项里最低的那一项
同样的预算能不能跑到更大的规模,取决于并行策略、互联与训练框架三者中最低的那一项。卡数充足时,最常见的天花板反而不在算力:一是数据供给,样本读取与预处理的吞吐跟不上时,加速设备会在每一步里等;二是检查点写入,模型越大,一次落盘的时间越长,长到一定程度后你会被迫在“更安全”与“更快”之间做选择,而这个选择没人替你定。
由此得到一条实用结论:想扩规模,先看这三项的短板在哪,再看要不要加卡。加卡对第三项无能为力,对前两项有时反而恶化——数据管道与存储带宽的争用会随并发上升。
五、把四条能力写成验收项:判据、实测记录与数值约定
写法是每条能力配两样东西:一个可执行判据,一个实测记录栏。实测记录栏写明测试条件、执行方式与测试时刻,由项目在验收时填写并双方签字,我们不代填。
举一个格式示例,数值只作说明用:
- 能撑多长训练:连续 72 小时作业不中断,且检查点写入耗时不超过总耗时的一定比例。
- 能装多大模型:在指定并行策略下完成指定规模模型的第一个训练步并落检查点,允许的最大序列长度单独记录。
- 能有效用多少:在同一负载上连续采样若干个训练步,记录步耗时分布的中位值与最长值,不用平均值。
- 坏了能不能接上:人为终止一个正在运行的作业,从检查点恢复,记录恢复后的第一个步号与是否接续原数据游标。
必须写清一条纪律:上面所有数值都要由客户与供应商在本项目内约定,不引用外部标准,也不照搬别人的阈值。不同模型的规模、不同拓扑的集群、不同框架的检查点机制,判据的合理值差别极大。外部阈值看起来省事,实际是把判定权交给了不相干的项目。判据写法里也不要出现“支持”“具备”这类词,只写动作与观测结果。
六、采购会上的三个追问、三种错买,以及我们改问题的方式
“缓解产能焦虑”这类说法进了采购会,要先问清焦虑指的是哪一件,三种焦虑的应对完全不同:
- 交付周期焦虑:设备到货与集成交成的时间不确定。应对是分批交付、先交可用规模、把配套责任写明由谁做。
- 扩容审批焦虑:中途加预算与追加规模要走不通的流程。应对是一次性把容量增长路径写进方案与合同的价格机制里。
- 预算波动焦虑:单价与总价随时可能变。应对是把计费粒度与容量保障条款分开谈,不把所有风险压在一个折扣数字上。
三种常见的错误采购决策,在会议桌上都很有市场:按峰值买而不是按可续跑买;按单卡价格谈而不是按有效产出谈;把集群当成一个大资源池而不做作业级隔离。第三条的代价最隐蔽,因为一次故障会把同池的多个作业一起拖下去,事后统计只看到“利用率很高”,看不到损失。
从“建得起”到“用得起”,中间最常漏的一件事是运维与调度能力,具体是拓扑感知调度与故障隔离。没有这两项,规模越大浪费越多:调度不认拓扑,跨域通信变多;没有故障隔离,单点异常扩散成整池排队。这两项在预算表里通常没有科目,所以经常被省掉。
我们把客户的问题改写成三个变量再反推规模:要跑什么负载、模型多大、可接受多大的中断损失。三者定下来,需要的卡数是一道算术;三者没定下来,任何卡数都不对。下面这张对照表可以直接交给客户,左列是他们习惯写的数量指标,中列是对应的能力问题,右列是实测方法。
| 数量类指标 | 对应的能力问题 | 实测方法 |
|---|---|---|
| 加速卡数量 | 能装下多大的模型 | 在目标并行策略下跑到第一个训练步并落检查点,记录显存峰值 |
| 标称峰值吞吐 | 能有效用多少 | 同一负载采样若干步,记录步耗时中位值与最长值 |
| 机柜与功率规模 | 能撑多长的训练 | 连续长时运行,记录中断次数与检查点写入占比 |
| 可用性百分比 | 坏了能不能接上 | 人为终止作业后恢复,核对续跑的步号与数据游标 |
| 扩容上限承诺 | 规模上去后哪一层先撑不住 | 按最小可交付规模逐级加,记录通信与等待的变化 |
洹拓做这类咨询时交付顺序也跟着改:先交一个能跑的真实负载,把四条能力的实测值拿回来,再谈要不要加卡。这个顺序比先算卡数再补验证要稳,因为它把最贵的错误放在前面而不是后面。