
能自主格斗,却在药房货架前失手:机器人缺的是哪一层
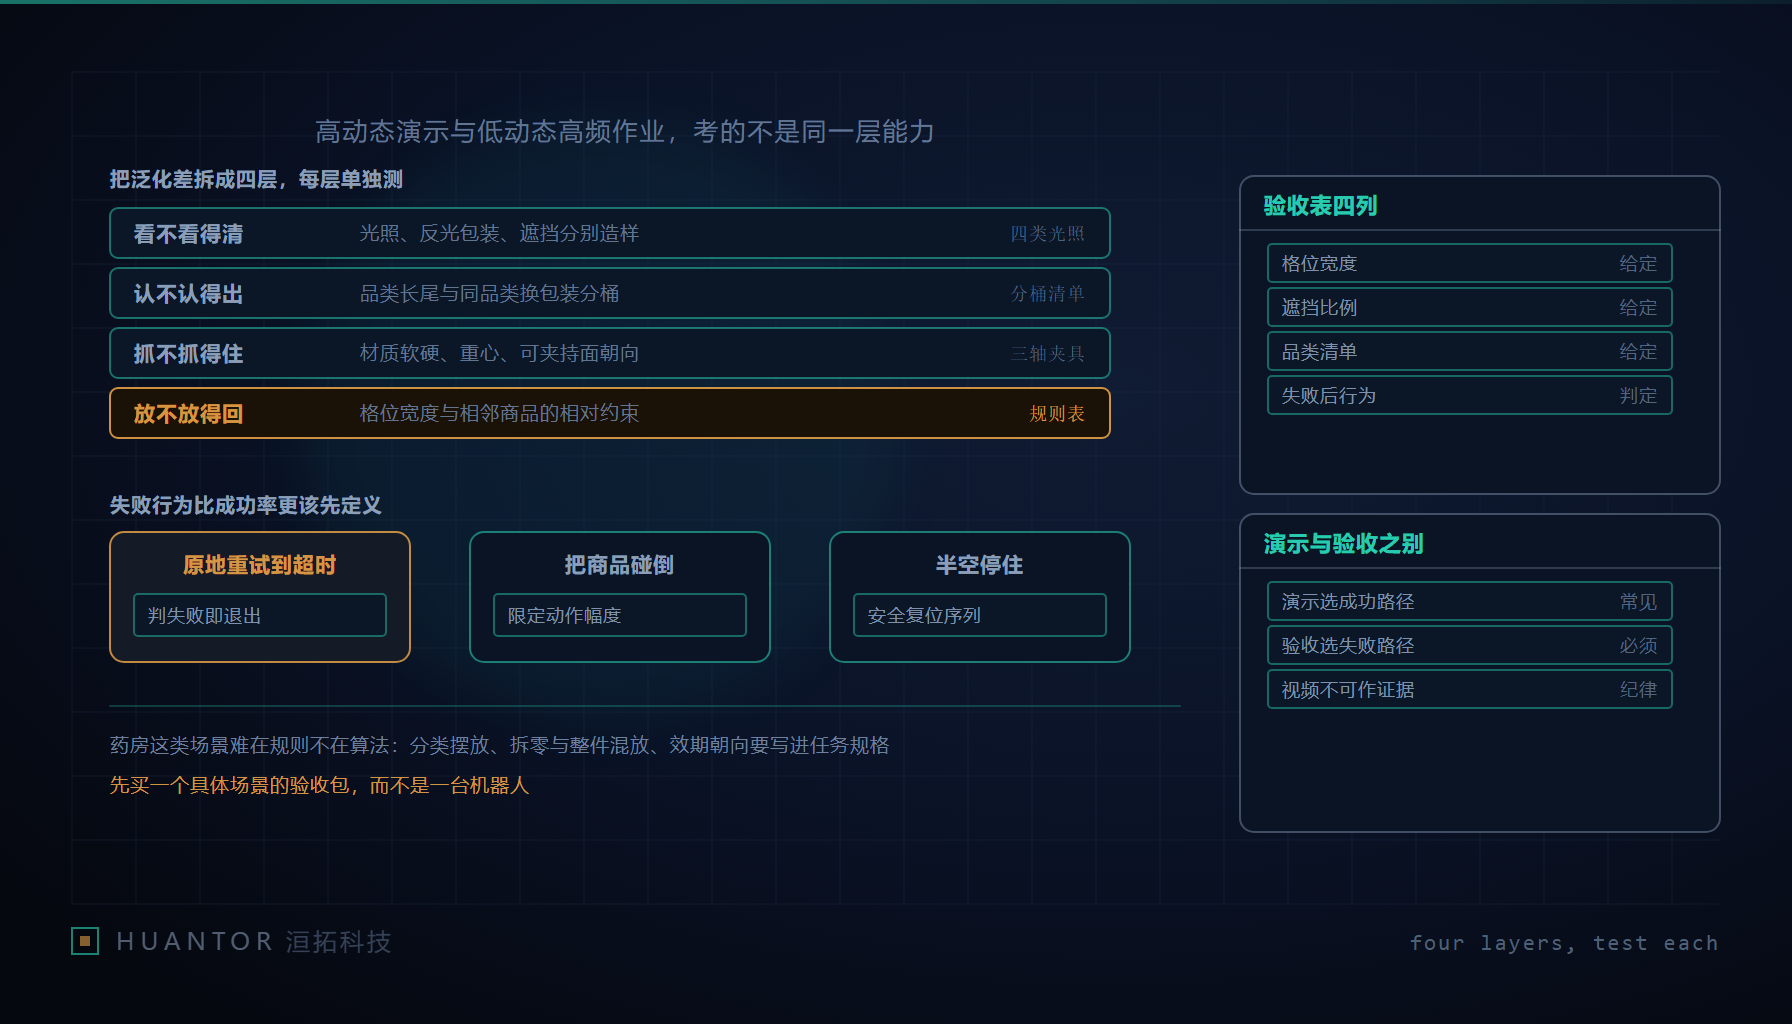
一、格斗与药房考的不是同一层能力
据公开报道,一家机器人公司的创始人在对谈里说过一句实在话:机器人还吃不了粗粮。自主格斗让人看到临场反应的进步,可换成药房里取放商品这样的场景,另一方面的挑战依然存在。这句话的份量不在自我批评,在于它把两类能力放到了同一张桌子上。
格斗和药房看着都是“机器人做事”,考的东西几乎不重叠。格斗考的是反应带宽与控制回路:扰动来了能不能在几十毫秒内改姿、重心被推走能不能重新建立支撑、连续动作之间的时序稳不稳。这一层能力的特征是它是连续量,做不到位会立刻表现为动作难看或者摔倒,所以它天然适合被拍成视频,也天然容易被外行读成“这台机器很聪明”。
药房考的是物体表征的覆盖面与失败后的处置策略:同一个药品换个包装还算不算同一类、被前排放着的盒子挡住一半还认不认得、软塌的袋装能不能夹得住、取出来之后按规则放回哪一格。这一层能力是离散量,它不体现在动作漂不漂亮,只体现在一批不同商品摆上去以后,多少件能走完整条任务、走不完的以什么方式收场。
一个高动态、一个低动态高频,中间隔着的是完全不同的采集成本、验证成本和验收方式。客户真正要买的那件东西,几乎总是落在第二栏里。
二、把“泛化差”拆成四层,每层测法不一样
“泛化能力不足”是一个不能用来做决定的说法,它把四个可以被分别测出来的问题糊在了一起。拆开才有办法谈改进和验收。
| 层 | 具体变量 | 单独的测法 | 这一层失败会长什么样 |
|---|---|---|---|
| 看不看得清 | 顶灯与侧光、反光包装膜、玻璃瓶高光、被前排遮挡的比例 | 同一批物体在几种光照与遮挡条件下各采一遍深度图与彩色图 | 分割轮廓抖、边缘吃进商品本体、反光面判成空洞 |
| 认不认得出 | 品类长尾、同品类不同规格与新旧包装、堆叠时的局部可见 | 固定一套品类清单,按“首次见到的包装”单独设一组 | 认成邻近品类、把新包装当未知物体搁置 |
| 抓不抓得住 | 材质软硬、重心偏移、可夹持面朝向、易碎 | 按材质与重心分桶,逐桶做夹持试验并记录滑落 | 夹变形、夹滑、抓空、捏碎 |
| 放不放得回 | 货架格位宽度、与其他商品的相对位置、放回后的朝向要求 | 给格位宽度和目标朝向设条件,看放完是否合规 | 取成功但放回去不合格,整件事仍然算失败 |
四层的测法互不替代。只测第三层的团队会得出“抓取成功率不错”的结论,而那批样本可能全摆在桌面上、光照理想、朝向规整。第四层最容易被漏掉,很多演示里“取出来”就算成功,实际业务里“按规则放回去”才是任务终点。
三、演示视频为什么系统性骗人,验收表该写到什么粒度
演示视频不是造假,它是选择。一次演示挑的是走通了的那条路径:位置是自己摆的、光照是自己挑的、品类是练过的、失败的那几次留在剪辑台外面。观众看到的成功率因此永远偏高,而且偏高的幅度无法从视频本身推算。
验收要做相反的选择:不挑成功路径,挑失败路径。这需要先有一张粒度正确的验收表。粒度错误的写法是“能取放商品”,这句话没有任何可判定内容。粒度正确的写法是把前置条件全写出来:在给定的格位宽度、给定的遮挡比例、给定的品类清单、给定的光照条件下,单次任务的成功判定标准是什么,失败之后设备的行为是什么。四个条件加两个输出,缺一项这张表就退化成口头承诺。
具体写法上,一条验收项应当包含:品类与包装清单(含明确标注为“首次出现”的新包装若干)、摆放规则(谁挡谁、挡多少由验收方定而不是由设备方定)、成功判定(取、放、朝向、格位合规四项全过才算一次成功)、失败行为的记录要求、以及验证环境与交付环境的一致性说明。这里最要紧的是第二条:摆位权归验收方。归设备方的验收,测的是设备方的采样偏好。
四、失败处置要先于成功率被定义
现在最常见的三种坏行为,都值得单独写在合同里而不是等上线后抱怨:原地重试直到超时,既不报警也不换路径,任务像被卡住;把相邻商品碰倒,自己不知道,后续人来收拾;抓取动作打断在半空,商品悬在夹爪与格位之间,既没取出也没放回,这是三种里最容易造成实物损失的一种。
为什么这一项要排在成功率前面?因为在真实货架环境里,失败是常态而不是异常,一晚上的作业里失败次数会远超人预期。成功率决定这件事划不划算,失败行为决定这件事能不能被允许发生在有人值守的场所。一台成功率不错但每次失败都把货架撞乱的设备,实际吞吐会被清理工时吃掉;一台成功率一般但每次失败都干净收手、把状态交回给人的设备,可以被排进白班。
所以失败处置要单独设计成一组可判定的行为约束,而不是模型的自由发挥:超时后必须退出当前目标并上报原因;单次动作导致相邻商品位移超阈值时必须停止并等待;半空失持时优先做受控释放而不是继续夹取;同一路径连续失败几次后必须换策略或挂起任务;每一次失败留下可回看的现场记录。这几条比任何一句“提升鲁棒性”都可验收。
五、长尾样本的成本怎么压,以及规则这一层归谁
采集是这类项目最贵的一项,压成本靠三句原则。第一句,按品类分桶而不是按数量堆。同一品类采一万张,样本再多也只覆盖了一个分布点;不如把预算按品类铺开,每个品类采少量但覆盖它的几种包装与摆放状态。第二句,把包装变化当成独立维度。同一支药的新旧包装、促销装、拆零袋,在分布上是不同事件,不标成独立维度就会被模型当成同类,验收时才发现认不出。第三句,用真实货架而不是桌面。桌面上的自由摆放丢掉了这个项目真正的难度:格位边界、纵向堆叠、前挡后、灯光从上往下的阴影。用桌面数据训出来的能力,一到货架就掉,掉的还不是识别,是取放的空间判断。
药房场景还有一件被算法团队常误判的事:真正难的部分是规则,不是算法。药品按分类摆放有硬性要求,拆零与整件会混放,效期朝向有规定位置,这些知识是业务约定,不是物体自带的属性,模型看再多图也学不出“这一格只能放同类且效期朝外”。这部分必须写进任务规格,作为放置判定的显式约束,由场景方与集成方一起签字确认,而不是留一句“由模型自行判断”。责任切分的界线很清晰:感知与抓取归设备方,摆放规则归场景方,把规则塞进模型权重里是双方都要避免的做法。
六、客户该按哪条线选供应商,以及一条准入建议
选供应商时容易问的第一个问题是“你们最高能做到什么”,这是营销信号那一栏:高动态能力、连续动作、抗扰动,视频好看、汇报有冲击力,但和要交付的作业几乎不相关。该问的是“低动态高频作业那一栏:同一批货连续作业一晚上,失败按什么方式收场,谁值守,掉线怎么退”。两栏的差别不是水平高低,是能力层不同,用第一栏的证据签第二栏的合同,是这类采购最常见的错配。
一条可执行的准入建议:先买一个具体场景的验收包,再考虑买设备。验收包的内容就是前面那张粒度正确的表加一次真机演示,在客户自己的货架、自己的品类清单、自己的摆位权下进行,交付物是一份带失败行为记录的报告。它的投入远低于一台设备,却能回答所有关键问题;更重要的是,它让后面那笔采购有可判定的验收依据,而不是有了一台需要靠磨合来确认能不能用的机器。
对做工业 AI 的洹拓来说,这组对照说明的其实是一件更普遍的事:客户买的从来不是能力上限,是能力下限的可保证性。上限决定宣传片能不能拍,下限决定这条线敢不敢在没人盯的时候开动。所以我们把方案里“最好情况下的表现”这类表述一律改成“给定条件下的成功判定与失败行为”,把验收包写成独立可采购的一项。一个不能说明自己怎么失败的方案,等于把发现失败的时间安排在了上线之后。