
AIGC 内容需要一本创作手册:我们把发布标准写成可勾选的条目
有内容社区公开修订过自己的创作手册,为机器生成的内容重申投稿与标注要求。我们不去复述别人手册里的条文——各家标准只有自己发布的文本才算数,转述一次就变形一次。值得说的是这件事背后的普遍处境:当一个团队的内容产出从每月几篇变成每天几篇,写作的人从两三个变成”人加若干模型”,质量问题就不再靠”大家注意点”来控制。
内容生产的规范工作有两种失败方式:一种是完全没有标准,风格与事实口径随人流失;另一种是标准写成一篇宣言,谁都同意但谁都没法执行。我们试过把标准压缩成一份发布门禁清单——每一条必须能用”是”或”否”回答,答不出来的条目一律删除或重写。
一、量变带来的三种漂移
同一批人写,会漂。不同人加模型写,会互相打脸。具体是三条线在动。
口径漂移:产品名称、术语写法、单位与量级、日期的表述,在第一篇里定过一次,之后每个人都按自己看到的写法重来。公司全称、简称、产品型号三者混用,是最早出现也最难自察的问题。
承诺强度漂移:一开始写”支持某种格式”,为了显得有竞争力慢慢变成”完美兼容”,再变成”业内少见”。每一句单独看都不算离谱,连起来读,同一件事在不同页面有不同的强度。
来源漂移:一段话原来挂着出处,改写三轮之后出处丢了,只剩下一句看起来很有把握的结论。模型在这个环节贡献最大——它非常擅长把没有来源的句子写得像有来源。
手册的作用不是统一文风,是给人和模型的产出建立可对账的基础:同一件事在全站只有一个版本、一个强度、一个来源位置。
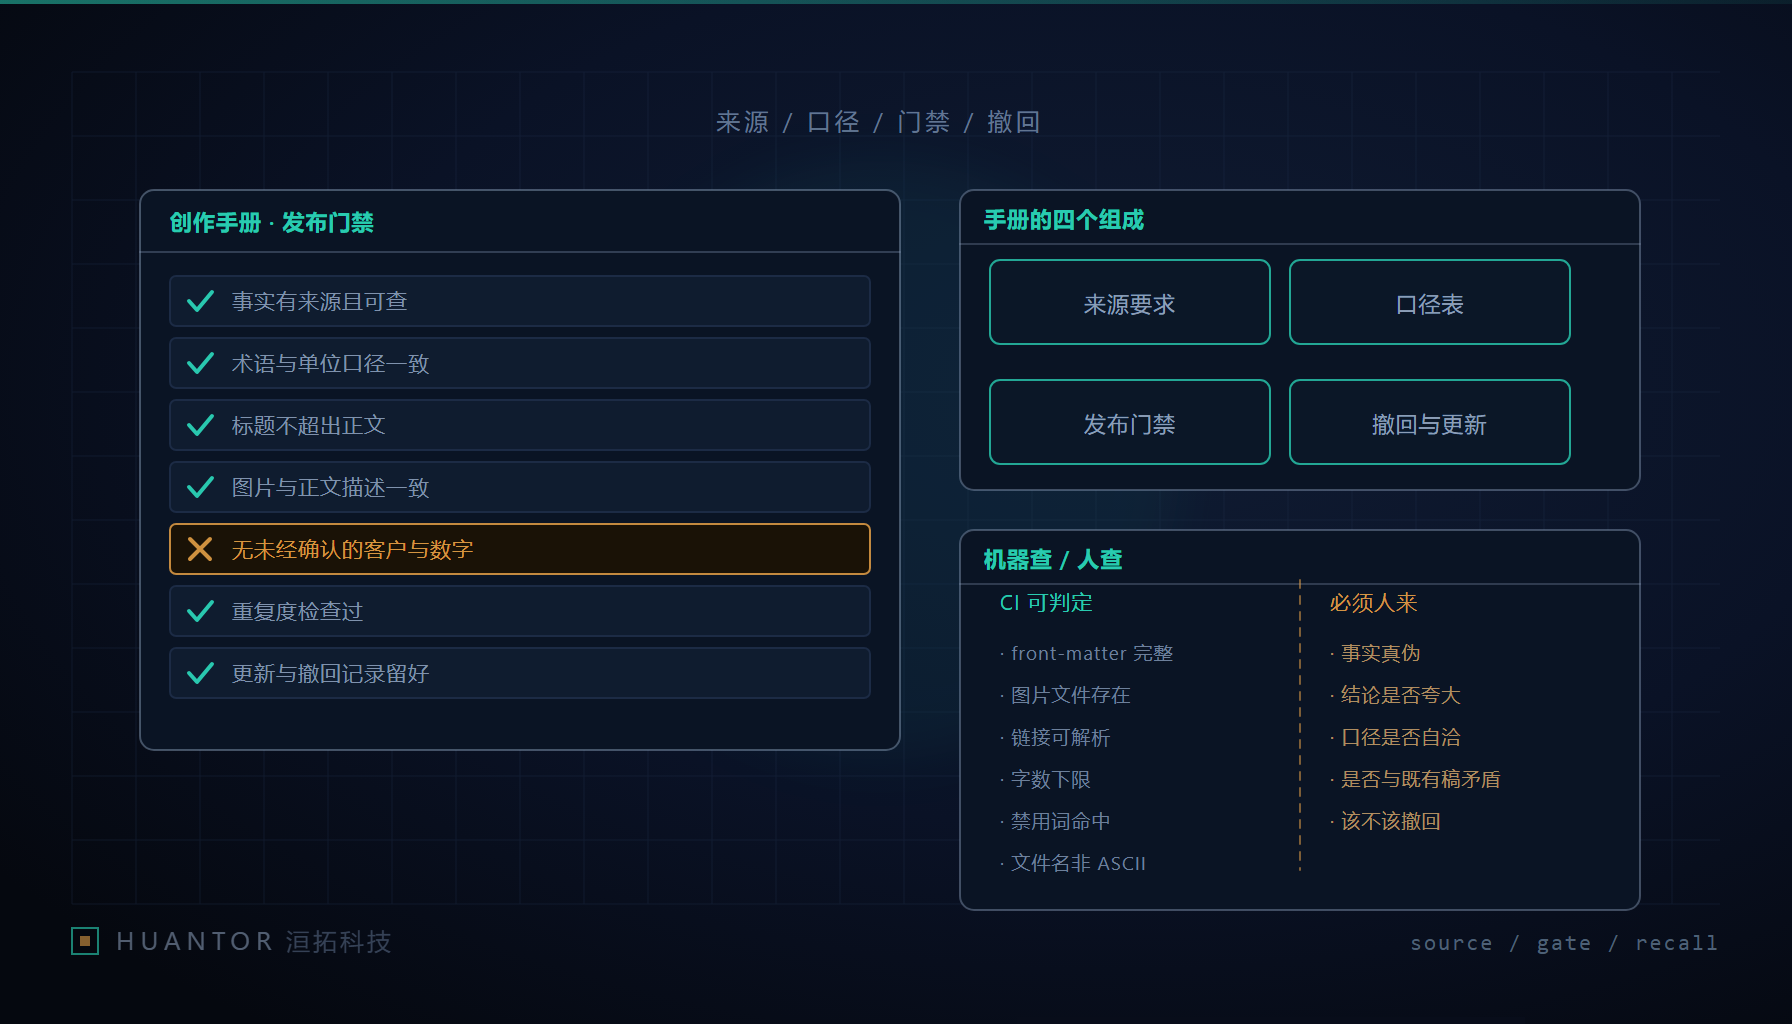
二、手册的四个组成
| 组成 | 解决什么 | 手册里要落到什么条目 | 谁维护 |
|---|---|---|---|
| 来源要求 | 哪些事实必须挂出处,哪些必须自测 | 按事实类型分组:外部数据必挂链接;性能类必须本方实测并留环境;观点类标注立场 | 内容负责人 |
| 口径表 | 写法不统一 | 名称与简称的唯一写法、单位与量级规则、日期与版本写法、禁用表述清单 | 产品与市场共同签字 |
| 发布门禁 | 不合格内容流不出去 | 一张可勾选清单,每条能答是或否;不通过时的处理动作写在同一行 | 工程与内容共同维护 |
| 撤回与更新 | 错了之后怎么办 | 勘误分级、更新记录格式、下游引用点回改范围、保留原文还是就地修订 | 首发作者与复核人 |
四件里最容易被省掉的是第四件。没有撤回流程的团队,改错的方式是悄悄替换文本,后果是同一错误在缓存、转载和摘录里各活一份,还查不到曾经错过。更新记录不需要长篇,一行”改了什么、为什么改、以哪一份为准”就够。
口径表要短。超过两页没人查,就会退回”凭印象写”。我们的做法是把口径表塞进模板里,新建文件时字段已经填好默认写法,不让人去翻文档。
三、十五条可勾选条目
判定原则:一条检查项如果不能由”看这段内容的人”在三十秒内回答是或否,它就是不可判定的,要拆或删。下面这份是我们自己在用的版本,可以直接抄回去按自己的字段改。
| 序号 | 条目(回答是或否) | 不通过时的动作 |
|---|---|---|
| 1 | 元信息里的标题、日期、更新时间、分类、标签、封面、摘要七项都非空 | 补齐后再进入下一项 |
| 2 | 封面指向的图片文件在仓库中真实存在 | 补图或改路径 |
| 3 | 正文长度达到手册约定的下限 | 补实质内容,不许用段落灌水 |
| 4 | 文中每个外部链接都能打开,且打开后的位置与引用它的那句话相关 | 换来源或删除该断言 |
| 5 | 所有数字都写明来源,或明确标注为自造样例 | 无来源的数字一律删除 |
| 6 | 没有出现未经授权的客户名称、合同金额、上线时间、具体人名 | 删除或换成不指名的描述 |
| 7 | 涉及其他平台规则的句子附有对方发布位置,未凭印象改写 | 找不到位置就改写为不涉规则的描述 |
| 8 | 标题里的每个承诺,在正文中有对应段落兑现 | 改标题或补正文 |
| 9 | 配图内容与正文表述一致,图里的字与表的项正文都提到过 | 改图或改文 |
| 10 | 与站内同主题旧文的重复段落经过人工确认,未直接复制 | 重写或删除旧文 |
| 11 | 禁用词扫描无命中 | 替换为具体说法 |
| 12 | 正文出现的任何日期不晚于本文件的发布日期字段 | 删掉超出范围的日期或改成不带日期的表述 |
| 13 | 代码与命令片段经过实际运行,或明确标注为示意 | 跑一遍或加标注 |
| 14 | 改动正文时更新时间字段同步改了 | 同步字段,不一致视为未完成 |
| 15 | 每条关键结论至少有一条可核验支撑(来源、实测记录或可复现步骤) | 削弱表述或撤下该结论 |
第 6、7 条是 AIGC 内容上最常破的。模型生成时对客户名与”某某平台规定”这类句式特别宽容,不显式拦住就会带出来;而这两类内容一旦出错,代价是对外责任,不是内部返工。
四、门禁工程化:机器查一半,人查另一半
清单能自动化的部分要推进流水线,剩下的必须人查,两边不要互相冒充。
| 检查项 | 机器可判定 | 必须人判 | 实现提示 |
|---|---|---|---|
| 元信息字段完整性 | 是 | 否 | 解析头部字段列表比对必填集合 |
| 图片文件是否存在 | 是 | 否 | 路径拼接后做一次文件存在性检查 |
| 字数下限 | 是 | 否 | 按汉字计数统计,不用字符总数 |
| 禁用词与相对时间词 | 是 | 否 | 词表放仓库内,命中即失败 |
| 日期不晚于发布日期 | 是 | 否 | 正则抽日期后与字段比较 |
| 链接可达性 | 部分是 | 否 | 状态码可查,”是否落题”要人看 |
| 断言是否有来源 | 否 | 是 | 机器只能查有没有链接,不能查支不支持 |
| 结论是否夸大 | 否 | 是 | 需要读上下文与既有口径 |
| 图文是否一致 | 否 | 是 | 只能人对着图读一遍 |
# 示意脚本:把清单里机器可判定的部分接进构建前检查 |
这段只是示意,函数名按自己的仓库改。关键不在于有没有 CI,而在于把”这条能自动查”这个判断做在清单里:每一项标注是机器管还是人管,人就不会把时间花在能自动化的检查上,也不会误以为自动检查覆盖了事实真伪。
五、五种反复出现的失效与改法
- 标题超出正文。改法:把标题当成断言,写完正文逐句回核,标题里出现的名词必须在正文里能找到落点。
- 模型补出来的”合理数字”。它不是故意编,是在补全语言模式。改法:条目 5 硬性执行,数字要么有来源要么删,不接受”看起来对”。
- 口径表更新而旧文不回改。改法:口径表每次变更列一份受影响文件清单,回改与发布同批完成,不留历史欠账。
- 清单条目不可判定。”内容要有高质量”这类条目要重写成能回答是或否的形式,例如”是否存在没有来源的数字”。
- 撤回没有留痕。就地替换等于没有发生过。改法:勘误记一行,写清改动位置与原因。
这五条之外还有一条边界要说清:这本手册解决的是自家产出的可核验性,不是判定内容是谁写的。围绕”检测机器生成文本”的争论很多,把发布标准写成”抓 AI 味”既不可执行也不稳定;能执行的是事实有没有来源、承诺能不能兑现、口径是否一致这三件事,它们与作者是谁无关。
六、手册的作用是让产出可对账:洹拓视角
手册本身要版本化。条目要能被引用——“第 7 条不通过”是可执行的反馈,”这篇不太行”不是。我们给手册留了变更记录,条目编号从不变动;编号一动,历史反馈就全部失效。
从工程角度看,这本手册就是一份接口约定:来源要求是输入约束,口径表是命名规范,发布门禁是断言,撤回流程是错误处理。模型在这里的角色是生成草稿,草稿过不过门禁由同一套断言判定,人与模型用的是同一把尺子,这才是”可对账”的意思。
洹拓科技做工业 AI 与软件开发项目时,交付物里总有文档;文档出问题的方式和这批稿子一模一样——同一指标两处不同值、承诺强度随版本上升、改了结论没改来源。把发布标准写成可勾选的条目之后,最直接的收益不是”质量提升”这种没法验证的说法,而是返工变得可定位:哪一条、哪一句、哪个来源缺失,能指到具体位置上。对外我们不解释任何平台的规则,只保证自家页面里写的每句话,都能被回答是或否。